Giao diện
1. Giới thiệu: Từ bài toán hồi quy đến bài toán phân loại
Trong các bài giảng trước, chúng ta đã xây dựng quy trình bốn bước chuẩn mực để kiến tạo một mô hình dự báo hồi quy (Regression):
- Xác định dạng toán học của mô hình: Sử dụng hàm tuyến tính kết hợp các biến đổi phi tuyến và đa thức.
- Lựa chọn thước đo tối ưu: Sử dụng tổng bình phương phần dư (
), hệ số xác định ( ) hoặc sai số toàn phương trung bình ( ). - Ước lượng tham số trên tập huấn luyện: Tìm các hệ số
nhằm cực tiểu hóa hàm tổn thất trên dữ liệu huấn luyện. - Đánh giá năng lực dự báo trên tập kiểm thử: Đo lường sai số
hoặc trên dữ liệu kiểm thử độc lập.
Quy trình bốn bước này là nền tảng cốt lõi của khoa học dự báo hiện đại. Tuy nhiên, trong vô số bài toán thực tế, biến mục tiêu cần dự báo không phải là một đại lượng định lượng liên tục (như giá nhà, điểm thi hay nồng độ hóa chất), mà là một biến định tính phân loại (Categorical Response).
Đặc biệt phổ biến là bài toán phân loại nhị phân (Binary Classification), trong đó biến mục tiêu chỉ nhận một trong hai trạng thái đối lập:
- Y khoa: Bệnh nhân có mắc bệnh hiểm nghèo hay không (
). - Tài chính: Giao dịch thẻ tín dụng là hợp lệ hay gian lận (
). - Tiếp thị số: Khách hàng truy cập có bấm vào đường dẫn quảng cáo hay không (
). - Công nghệ thông tin: Một bức thư điện tử gửi đến là thư rác hay thư thông thường (
).
2. Bài toán thực tế: Thiết kế bộ lọc thư rác (Spam Filter)
Thư rác điện tử (Spam Email) là các thông điệp không mong muốn được gửi hàng loạt tới hộp thư của người dùng. Một bộ lọc thư rác là một cỗ máy phân loại tự động: Dựa vào các đặc trưng nội dung và siêu dữ liệu của bức thư, mô hình phải đưa ra quyết định xem thư đó có phải là thư rác hay không.
Xét tập dữ liệu thực nghiệm gồm spam:
: Bức thư là thư rác. : Bức thư là thư hợp lệ (thư thường).
Cùng với biến mục tiêu là hàng loạt biến dự báo tiềm năng ghi nhận các đặc trưng cấu trúc của thư:
to_multiple: Thư có được gửi đồng thời cho nhiều người nhận hay không (). cc: Số lượng người được gửi kèm bản sao (CC).winner: Nội dung thư có xuất hiện từ "winner" (người chiến thắng) hay không.num_char: Tổng số ký tự trong bức thư (tính theo đơn vị nghìn ký tự).attach: Số lượng tệp đính kèm.dollar: Số lần xuất hiện ký hiệu tiền tệ trong văn bản.
Phân tích khám phá dữ liệu (EDA)
Liệu sự xuất hiện của từ "winner" có phải là dấu hiệu chắc chắn để nhận diện thư rác? Hãy quan sát biểu đồ thanh chuẩn hóa phân bố tỷ lệ thư rác theo biến winner:
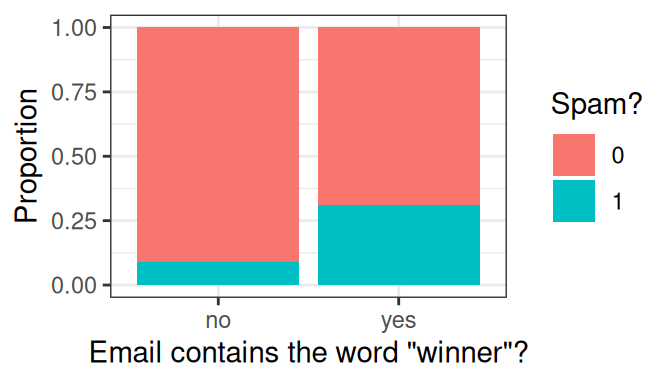
Hình 27.1: Biểu đồ thanh chuẩn hóa. Khoảng 30% thư chứa từ "winner" là thư rác, trong khi chỉ có khoảng 10% thư không chứa từ này là thư rác.
Quan sát Hình 27.1, ta nhận thấy:
- Thư chứa từ "winner" có khả năng là thư rác cao gấp 3 lần thư không chứa từ này.
- Tuy nhiên, phần lớn các bức thư chứa từ "winner" (khoảng
) vẫn là thư hợp lệ thông thường! - Do đó, nếu áp dụng một quy tắc cứng nhắc: "Cứ thấy từ winner là đánh dấu thư rác", chúng ta sẽ mắc sai lầm nghiêm trọng khi xóa nhầm phần lớn thư quan trọng của người dùng.
Tiếp theo, hãy khảo sát độ dài của bức thư qua biến num_char (số nghìn ký tự):
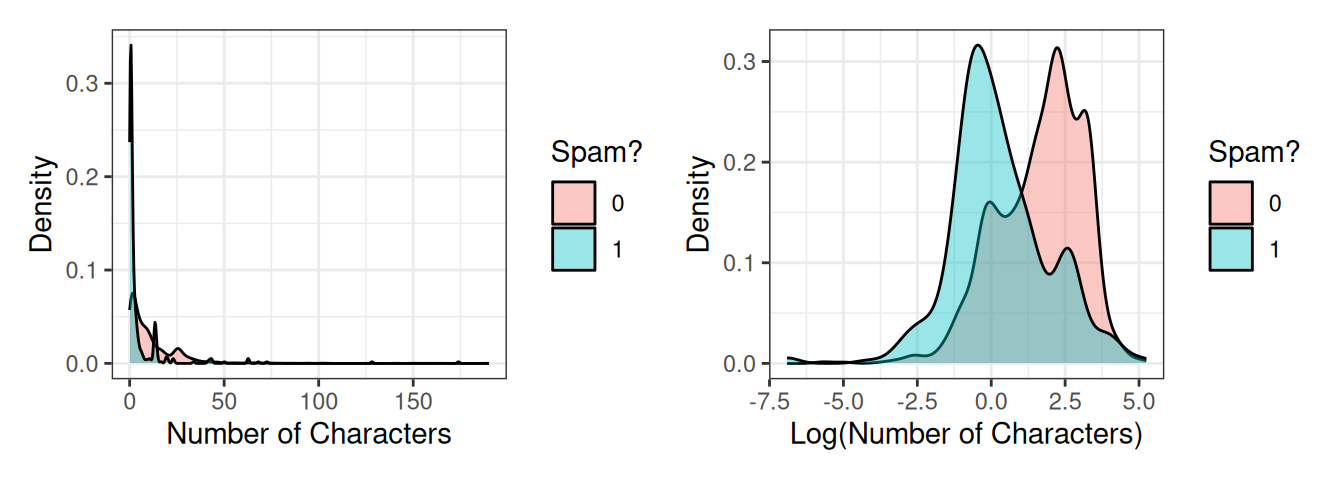
Hình 27.2: Đồ thị bên trái biểu diễn phân bố mật độ ban đầu của biến num_char (bị lệch phải dữ dội). Đồ thị bên phải biểu diễn phân bố sau khi lấy logarit tự nhiên log(num_char).
Đồ thị logarit bên phải cho thấy: Thư rác có xu hướng ngắn hơn đáng kể so với thư hợp lệ thông thường. Tuy nhiên, hai đường phân bố vẫn có phần giao thoa rất lớn.
Một biến đơn lẻ không bao giờ là "viên đạn bạc" giải quyết trọn vẹn bài toán. Chúng ta cần kết hợp đồng thời sức mạnh của nhiều biến dự báo vào một mô hình toán học thống nhất.
3. Vì sao Hồi quy tuyến tính OLS thất bại trong phân loại?
Hãy thử áp dụng mô hình hồi quy tuyến tính bình phương bé nhất quen thuộc để biến spam theo biến
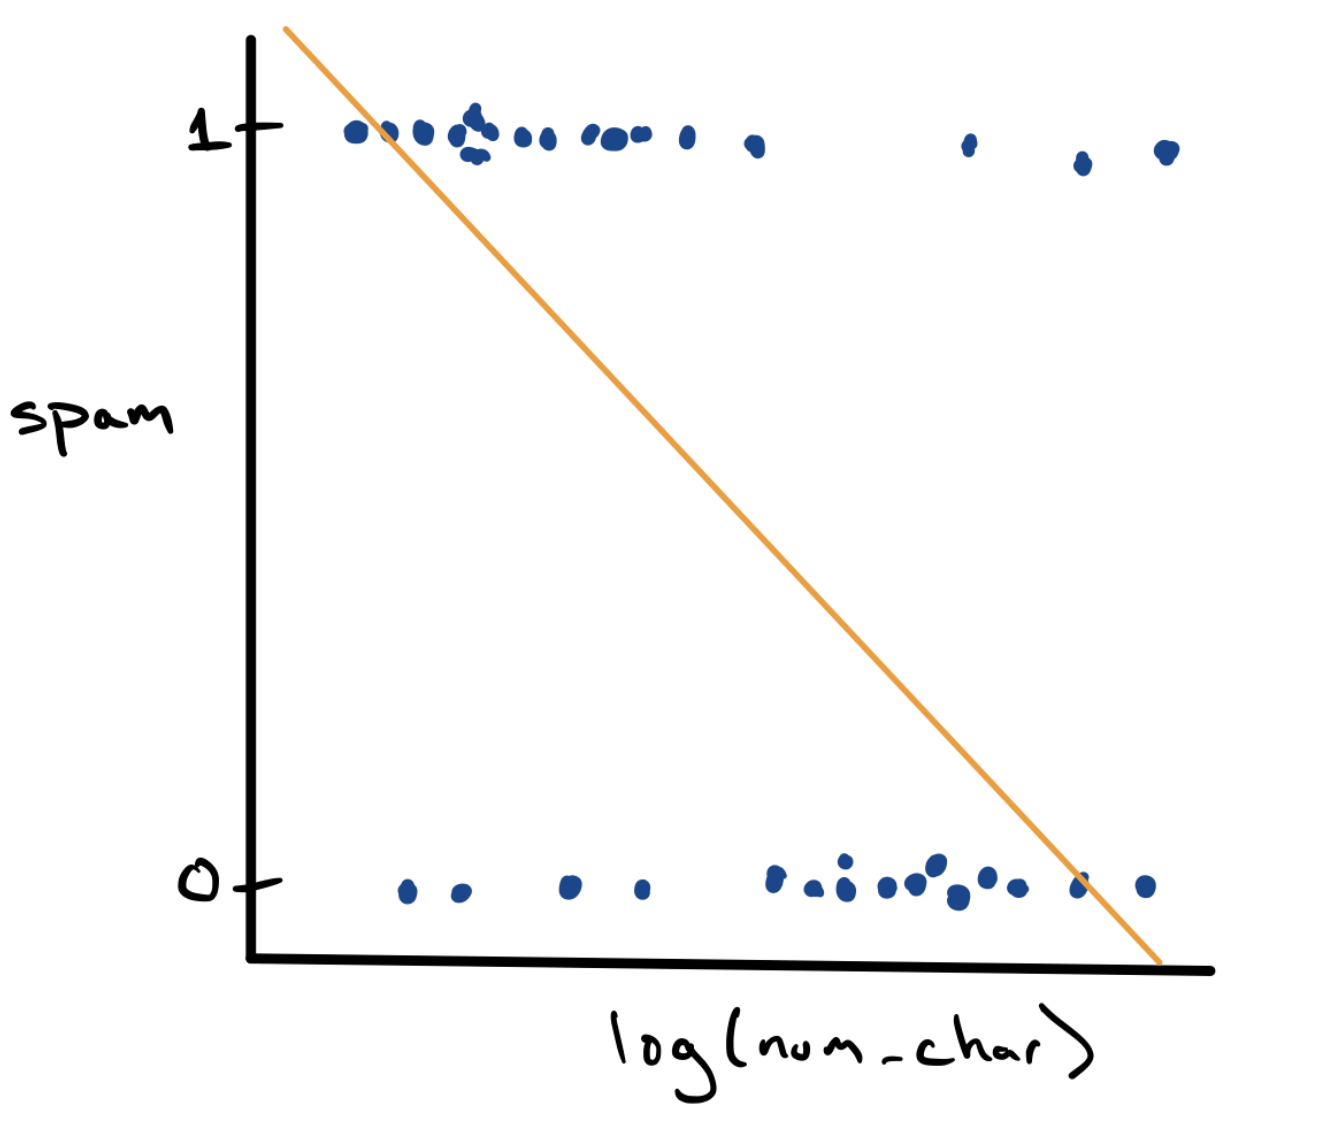
Hình 27.3: Đồ thị phân tán với các điểm dữ liệu chỉ nhận giá trị 0 hoặc 1. Đường thẳng OLS màu vàng cắt qua dữ liệu nhưng tạo ra các dự báo vô nghĩa.
Hình 27.3 bộc lộ hai khuyết tật nghiêm trọng của hồi quy tuyến tính:
- Vấn đề giải thích giá trị dự báo: Khi mô hình dự báo
, con số này mang ý nghĩa gì khi thực tế chỉ có nhãn hoặc ? - Lối thoát tự nhiên là diễn giải
như một ước lượng xác suất: (xác suất bức thư là thư rác bằng ).
- Lối thoát tự nhiên là diễn giải
- Sự vi phạm tiên đề xác suất: Đường thẳng tuyến tính
kéo dài vô tận về hai phía. - Khi bức thư có độ dài rất lớn (
lớn), đường thẳng dự báo . - Khi bức thư cực ngắn (
rất nhỏ), đường thẳng có thể dự báo . - Xác suất bắt buộc phải nằm trong đoạn
. Một mô hình dự báo xác suất âm hoặc vượt quá là hoàn toàn vô lý về mặt toán học.
- Khi bức thư có độ dài rất lớn (
Để giải quyết triệt để khuyết tật này, chúng ta cần một hàm toán học có khả năng "uốn cong" đường thẳng, nén toàn bộ trục số thực
4. Hàm Logistic (Sigmoid) và Phương trình Hồi quy Logistic
Hàm số toán học chuẩn mực được sử dụng rộng rãi nhất cho mục đích này là hàm Logistic chuẩn (Standard Logistic Function), thường được gọi là hàm Sigmoid:
Trong đó đại lượng
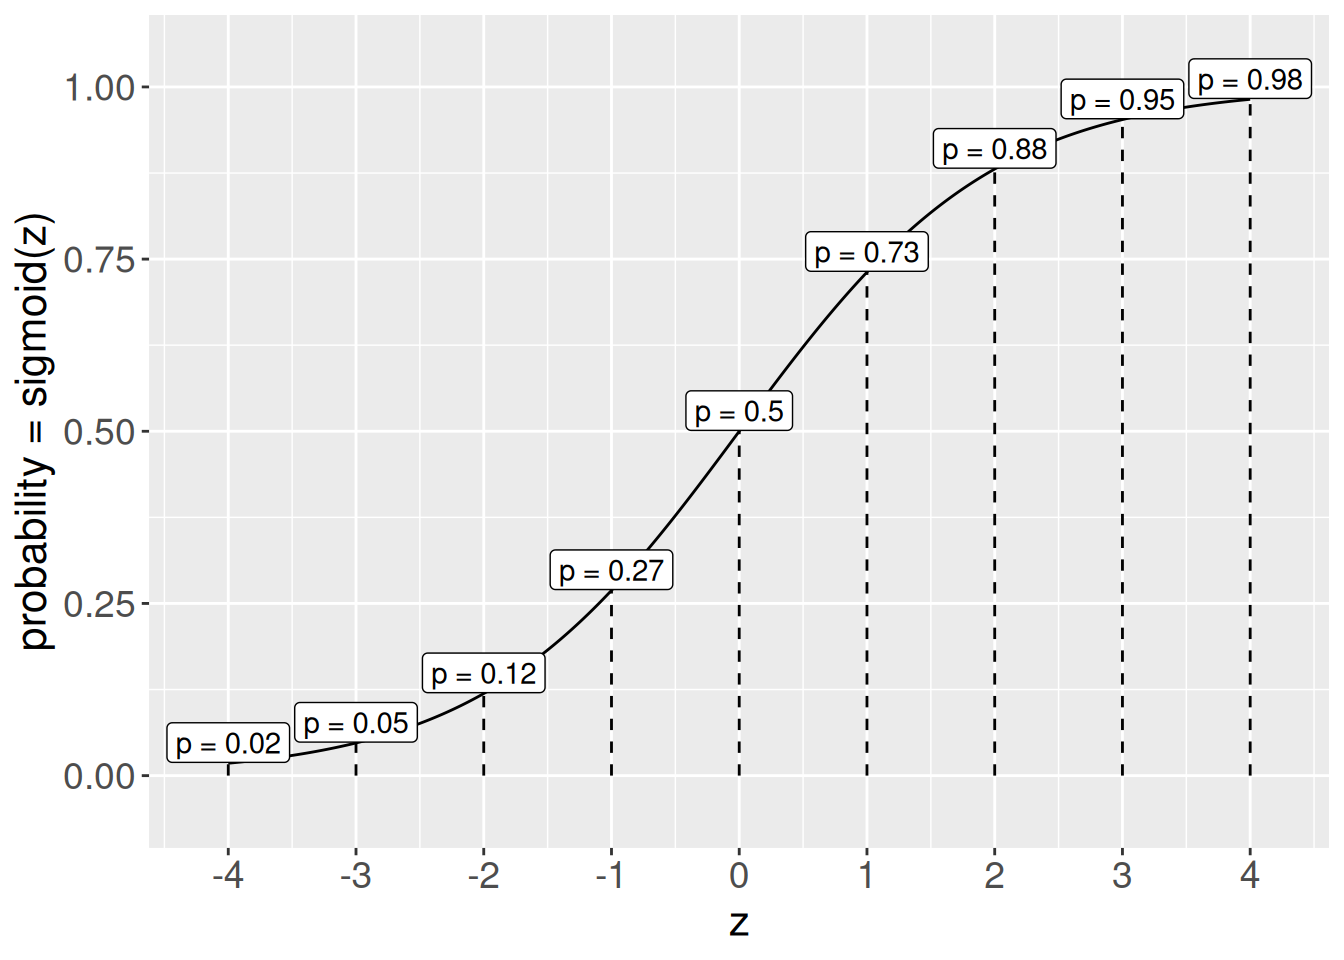
Hình 27.4: Đồ thị hàm Sigmoid f(z). Hàm số tăng đơn điệu, đối xứng qua điểm uốn (0, 0.5) và tiệm cận ngang tại 0 và 1.
Bảng trực giác giá trị của hàm Sigmoid:
| Công thức tính toán | Giá trị | Trực giác xác suất | |
|---|---|---|---|
| Biến cố gần như chắc chắn không xảy ra | |||
| Xác suất xảy ra thấp ( | |||
| Xác suất xảy ra tương đối thấp ( | |||
| Điểm cân bằng: Hai kết quả có cơ hội ngang nhau | |||
| Xác suất xảy ra cao ( | |||
| Xác suất xảy ra rất cao ( | |||
| Biến cố gần như chắc chắn xảy ra |
Bảng 27.1: Bảng giá trị đối chiếu của hàm Sigmoid qua các ngưỡng chỉ số
Mô hình Hồi quy Logistic (Logistic Regression)
Bằng cách đặt chỉ số tuyến tính là tổ hợp của các biến dự báo:
Mô hình hồi quy logistic dự báo xác suất biến cố
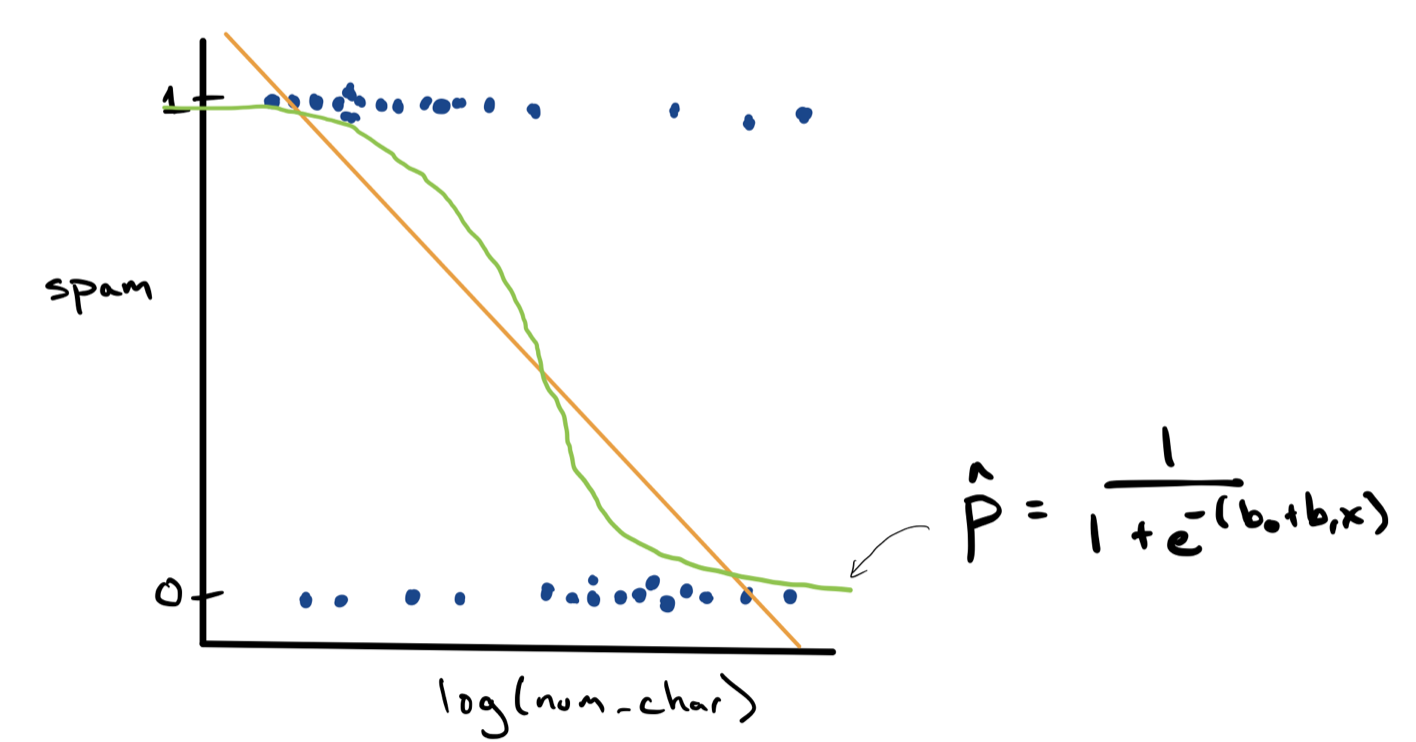
Hình 27.5: Đường cong hồi quy logistic màu xanh lá cây uốn lượn hình chữ S, luôn nằm nghiêm ngặt trong khoảng (0, 1) và mô tả hoàn hảo xu hướng suy giảm xác suất spam khi độ dài thư tăng lên.
5. Tỷ số cơ hội (Odds) và Hàm liên kết Logit
Để thấu hiểu sâu sắc bản chất đại số của hồi quy logistic, chúng ta cần tìm hiểu hai khái niệm xác suất quan trọng: Cơ hội (Odds) và Log-odds (Logit).
1. Cơ hội (Odds)
Trong ngôn ngữ thống kê học, cơ hội (
- Nếu
(cơ hội , hai bên cân bằng). - Nếu
(cơ hội , khả năng xảy ra gấp 4 lần không xảy ra). - Nếu
(cơ hội ). - Miền giá trị của
trải dài từ đến .
2. Hàm Logit (Log-odds)
Khi lấy logarit tự nhiên của
Biến đổi phương trình hồi quy logistic:
Như vậy, mô hình hồi quy logistic thực chất là một mô hình tuyến tính đối với log-odds:
3. Ý nghĩa tham số và Tỷ số cơ hội (Odds Ratio - OR)
Xét trường hợp một biến dự báo
- Khi
tăng thêm đơn vị, đại lượng log-odds tăng thêm đúng một lượng . - Do đó, cơ hội (
) sẽ được nhân với một thừa số :
Đại lượng
- Nếu
: Biến dự báo làm tăng khả năng xảy ra biến cố. - Nếu
: Biến dự báo làm giảm khả năng xảy ra biến cố. - Nếu
: Biến dự báo không có mối liên hệ với biến mục tiêu.
6. Đánh giá sai số phân loại và Ma trận nhầm lẫn
Sau khi tính được xác suất
Khi đối chiếu giữa nhãn dự báo
| Nhãn thực tế ( | Dự báo là Dương tính ( | Dự báo là Âm tính ( |
|---|---|---|
| Thực tế Dương tính ( | Dương tính thật (True Positive - TP) | Âm tính giả (False Negative - FN) (Sai lầm Loại II) |
| Thực tế Âm tính ( | Dương tính giả (False Positive - FP) (Sai lầm Loại I) | Âm tính thật (True Negative - TN) |
Bảng 27.2: Cấu trúc của Ma trận nhầm lẫn.
Hai loại sai lầm trong bài toán thực tế:
- Dương tính giả (False Positive - FP): Dự báo là
nhưng thực tế là . - Trong bộ lọc thư rác: Một bức thư quan trọng của đối tác bị mô hình gán nhầm là thư rác và đẩy vào thùng rác. Hậu quả là người dùng bị lỡ thông tin sống còn.
- Âm tính giả (False Negative - FN): Dự báo là
nhưng thực tế là . - Trong bộ lọc thư rác: Thư rác quảng cáo lọt qua bộ lọc và xuất hiện trong hộp thư đến. Hậu quả chỉ là người dùng thấy hơi phiền toái.
Rõ ràng, cái giá của sai lầm FP lớn hơn rất nhiều so với FN. Vì vậy, trong thực tế, các kỹ sư Gmail thường nâng ngưỡng quyết định lên mức cao (ví dụ
Các thước đo đánh giá chất lượng mô hình:
- Tỷ lệ phân loại sai (Misclassification Rate - MCR):
- Độ chính xác toàn phần (Accuracy):
- Độ nhạy (Sensitivity hay Recall): Khả năng phát hiện đúng các trường hợp dương tính thực tế:
- Độ đặc hiệu (Specificity): Khả năng nhận diện đúng các trường hợp âm tính thực tế:
7. Hướng dẫn thực hành: R và Python
Triển khai Hồi quy Logistic trong R
r
library(tidyverse)
library(openintro)

# 1. Chuẩn bị dữ liệu và chia train/test
set.seed(42)
email_clean <- email %>%
  mutate(
    log_num_char = log(num_char),
    spam = as.numeric(as.character(spam))
  )

train_data <- email_clean %>% slice_sample(prop = 0.8)
test_data  <- email_clean %>% anti_join(train_data, by = "time")

# 2. Huấn luyện mô hình hồi quy Logistic bằng glm()
model_logistic <- glm(
  spam ~ log_num_char + winner + to_multiple,
  data = train_data,
  family = binomial(link = "logit")
)

summary(model_logistic)

# 3. Dự báo xác suất trên tập kiểm thử
test_data <- test_data %>%
  mutate(
    pred_prob = predict(model_logistic, newdata = test_data, type = "response"),
    pred_class = if_else(pred_prob >= 0.5, 1, 0)
  )

# 4. Tính toán Ma trận nhầm lẫn và MCR
conf_mat <- table(Actual = test_data$spam, Predicted = test_data$pred_class)
print(conf_mat)

mcr <- mean(test_data$spam != test_data$pred_class)
print(paste("Tỷ lệ phân loại sai MCR:", round(mcr, 4)))
Triển khai Hồi quy Logistic trong Python
python
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix, classification_report

# 1. Phân chia tập huấn luyện và kiểm thử
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. Huấn luyện mô hình
clf = LogisticRegression(solver="lbfgs")
clf.fit(X_train, y_train)

# 3. Dự báo xác suất và nhãn
y_prob = clf.predict_proba(X_test)[:, 1]
y_pred = (y_prob >= 0.5).astype(int)

# 4. Đánh giá chất lượng
cm = confusion_matrix(y_test, y_pred)
print("Ma trận nhầm lẫn:")
print(cm)
print(classification_report(y_test, y_pred))
8. Tóm tắt bài học
- Bản chất của phân loại nhị phân: Dự báo một biến định tính nhận hai giá trị đối lập (
và ). - Khuyết tật của OLS: Đường thẳng hồi quy tuyến tính vi phạm tiên đề xác suất khi dự báo giá trị âm hoặc lớn hơn
. - Cơ chế hàm Sigmoid: Hàm
chuyển đổi linh hoạt chỉ số tuyến tính thành xác suất hợp lệ trong khoảng . - Hàm liên kết Logit và Odds Ratio: Mô hình thiết lập mối quan hệ tuyến tính giữa các biến dự báo và log-odds. Hệ số
biểu thị mức nhân của tỷ số cơ hội khi biến dự báo tăng thêm đơn vị. - Ma trận nhầm lẫn và Đánh đổi ngưỡng quyết định: Việc lựa chọn ngưỡng phân loại
phụ thuộc vào sự cân nhắc thiệt hại giữa sai lầm Dương tính giả (FP) và Âm tính giả (FN).
Tài liệu tham khảo
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied Logistic Regression (3rd ed.). John Wiley & Sons.
- Diez, D. M., Çetinkaya-Rundel, M., & Barr, C. D. (2019). OpenIntro Statistics (4th ed.). OpenIntro.
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R. Springer.
- Stoyanov, N., & Adhikari, A. (2026). Understanding the World with Data: Logistic Regression. UC Berkeley STAT 20 Course Notes.
Bài tập tự luyện có lời giải chi tiết
Bài tập 1: Tính toán xác suất dự báo, Odds và Phân loại theo ngưỡng
Một nhóm nghiên cứu huấn luyện mô hình hồi quy logistic để dự báo khả năng một bức thư điện tử là thư rác (
: Số lần xuất hiện ký hiệu tiền tệ trong thư. : Biến chỉ thị thư được gửi từ người quen trong danh bạ ( ).
Phương trình hàm logit ước lượng được là:
Xét hai bức thư mới đến cần phân loại:
- Thư A: Chứa
ký hiệu tiền tệ và gửi từ người lạ ( ). - Thư B: Chứa
ký hiệu tiền tệ và gửi từ người quen ( giả định điểm tương tác quen biết).
Yêu cầu:
- Tính chỉ số tuyến tính
, cơ hội ( ) và xác suất dự báo cho cả Thư A và Thư B. - Nếu hệ thống áp dụng ngưỡng quyết định mặc định
, Thư A và Thư B sẽ được phân loại là thư rác hay thư hợp lệ? - Nếu người dùng muốn bảo vệ tối đa hộp thư và đặt ngưỡng khắt khe
, kết quả phân loại của Thư A sẽ thay đổi như thế nào?
Lời giải chi tiết
Bước 1: Tính toán cho Thư A
Với Thư A (
- Chỉ số tuyến tính
: - Cơ hội (
): - Xác suất dự báo
:
Như vậy, mô hình dự báo xác suất Thư A là thư rác đạt
Bước 2: Tính toán cho Thư B
Với Thư B (
- Chỉ số tuyến tính
: - Cơ hội (
): - Xác suất dự báo
:
Như vậy, xác suất Thư B là thư rác chỉ là
Bước 3: Phân loại theo ngưỡng quyết định
- Với ngưỡng mặc định
: - Thư A: Có
Phân loại là Thư rác ( ). - Thư B: Có
Phân loại là Thư hợp lệ ( ).
- Thư A: Có
- Với ngưỡng khắt khe
: - Thư A: Vì
, Thư A sẽ không bị coi là thư rác và được chuyển vào Hộp thư đến thông thường ( ). - Nhận xét: Việc nâng ngưỡng quyết định giúp ngăn chặn tình trạng Thư A bị chặn nhầm nếu như mức độ chắc chắn chưa vượt quá
.
- Thư A: Vì
Bài tập 2: Giải thích ý nghĩa của Hệ số hồi quy và Tỷ số cơ hội (Odds Ratio)
Một mô hình hồi quy logistic dự báo khả năng một khách hàng thanh toán nợ đúng hạn (
Trong đó:
: Biến chỉ thị khách hàng có thu nhập ổn định ( ). : Số lượng khoản vay quá hạn trong lịch sử tín dụng.
Biết rằng
Yêu cầu:
- Tính Tỷ số cơ hội (
) của biến . Giải thích ý nghĩa thực tế của con số này đối với khả năng thanh toán nợ của khách hàng. - Giả sử một khách hàng ban đầu có xác suất trả nợ đúng hạn là
. Nếu khách hàng này có thêm nguồn thu nhập ổn định ( chuyển từ lên , các yếu tố khác không đổi), xác suất trả nợ đúng hạn mới sẽ là bao nhiêu? - Vì sao mức tăng của xác suất (
) không bằng hằng số ?
Lời giải chi tiết
Bước 1: Tính toán và giải thích Tỷ số cơ hội của biến
Hệ số của biến
Ý nghĩa thực tế: Giữ nguyên các yếu tố khác không đổi, một khách hàng có thu nhập ổn định sẽ có cơ hội thanh toán nợ đúng hạn cao gấp 2 lần (tăng
Bước 2: Tính toán xác suất mới
Ban đầu, xác suất trả nợ của khách hàng là
- Tính cơ hội ban đầu (
): - Khi có thêm thu nhập ổn định, cơ hội mới nhân với
: - Chuyển đổi từ
về xác suất mới :
Như vậy, xác suất trả nợ tăng từ
Bước 3: Bản chất phi tuyến của xác suất trong hồi quy logistic
Hệ số
Do mối quan hệ giữa xác suất
- Nếu
ở gần hoặc , độ dốc của hàm Sigmoid rất nhỏ nên xác suất biến động chậm. - Nếu
ở quanh vùng , độ dốc đạt cực đại và xác suất thay đổi nhạy bén nhất. - Đây chính là ưu điểm vượt trội giúp hồi quy logistic không bao giờ đẩy xác suất vượt quá miền
.
Bài tập 3: Thiết lập Ma trận nhầm lẫn và Tối ưu hóa Ngưỡng quyết định
Một ngân hàng thương mại thử nghiệm mô hình hồi quy logistic để phát hiện giao dịch gian lận trên tập kiểm thử gồm
Khi áp dụng ngưỡng quyết định mặc định
giao dịch gian lận được phát hiện chính xác. giao dịch gian lận bị bỏ sót (báo là hợp lệ). giao dịch hợp lệ bị gắn cờ nhầm là gian lận. giao dịch hợp lệ được xác định chính xác.
Sau đó, ngân hàng thử nghiệm ngưỡng nghiêm ngặt
- Phát hiện chính xác
giao dịch gian lận. - Chỉ còn
giao dịch hợp lệ bị gắn cờ nhầm.
Yêu cầu:
- Lập Ma trận nhầm lẫn cho cả hai trường hợp ngưỡng (
và ). - Tính Tỷ lệ phân loại sai (
), Độ nhạy ( ) và Độ đặc hiệu ( ) ở mỗi ngưỡng. - Phân tích bài toán đánh đổi trong thực tế: Ngân hàng nên chọn ngưỡng nào nếu chi phí xử lý khiếu nại của khách hàng bị khóa thẻ oan là rất lớn so với tổn thất gian lận?
Lời giải chi tiết
Bước 1: Lập Ma trận nhầm lẫn
Trường hợp 1: Ngưỡng
| Thực tế \ Dự báo | Dự báo Gian lận ( | Dự báo Hợp lệ ( | Tổng cộng |
|---|---|---|---|
| Gian lận thật ( | |||
| Hợp lệ thật ( | |||
| Tổng cộng |
Trường hợp 2: Ngưỡng
Với ngưỡng
. .
| Thực tế \ Dự báo | Dự báo Gian lận ( | Dự báo Hợp lệ ( | Tổng cộng |
|---|---|---|---|
| Gian lận thật ( | |||
| Hợp lệ thật ( | |||
| Tổng cộng |
Bước 2: Tính toán các chỉ số đánh giá
Tại ngưỡng
- Tỷ lệ phân loại sai:
- Độ nhạy (Sensitivity):
- Độ đặc hiệu (Specificity):
Tại ngưỡng
- Tỷ lệ phân loại sai:
- Độ nhạy (Sensitivity):
- Độ đặc hiệu (Specificity):
Bước 3: Phân tích bài toán đánh đổi thực tế
Bảng so sánh tổng hợp giữa hai ngưỡng:
| Chỉ số đánh giá | Ngưỡng mặc định ( | Ngưỡng nghiêm ngặt ( |
|---|---|---|
| Số ca khóa thẻ oan ( | ||
| Số ca gian lận lọt lưới ( | ||
| Tỷ lệ phân loại sai ( | ||
| Độ đặc hiệu ( | ||
| Độ nhạy ( |
Kết luận và khuyến nghị nghiệp vụ:
- Khi chi phí xử lý khiếu nại và nguy cơ khách hàng bỏ dịch vụ do bị khóa thẻ oan (
) là rất lớn, ngân hàng nên chọn ngưỡng . - Mặc dù độ nhạy giảm từ
xuống (chấp nhận để lọt thêm ca gian lận), nhưng số khách hàng chân chính bị khóa thẻ oan giảm mạnh từ xuống chỉ còn người, đồng thời tỷ lệ phân loại sai toàn phần giảm xuống mức tối ưu . - Việc điều chỉnh ngưỡng quyết định phản ánh triết lý quản trị rủi ro thực tế: Ngưỡng tối ưu không nhất thiết là
, mà là ngưỡng cân bằng tốt nhất giữa các tổn thất nghiệp vụ.