Giao diện
Dẫn nhập: Giới hạn của Giải tích và Bước đột phá của Máy tính
Các khoảng tin cậy mà chúng ta xây dựng trong các bài học trước đều dựa trên một trụ cột toán học vững chắc: Định lý Giới hạn Trung tâm (CLT). Định lý này khẳng định rằng tổng và trung bình của các biến ngẫu nhiên độc lập cùng phân phối sẽ hội tụ về phân phối chuẩn khi kích thước mẫu
Nhờ có Định lý Giới hạn Trung tâm, ta có thể tự tin áp dụng phân phối chuẩn Gauss để xấp xỉ phân phối chọn mẫu cho các đại lượng thống kê quen thuộc: Trung bình mẫu
Tuy nhiên, trong thực tế nghiên cứu khoa học và kinh doanh, chúng ta thường xuyên đối mặt với những câu hỏi hóc búa vượt ngoài tầm với của Định lý Giới hạn Trung tâm:
- Điều gì sẽ xảy ra nếu đại lượng thống kê ta cần khảo sát không thể biểu diễn dưới dạng tổng các biến ngẫu nhiên? Chẳng hạn như trung vị mẫu, phân vị thứ 90, tỉ số giữa hai phương sai, hệ số tương quan hạng, hay các tham số của một mô hình học máy phi tuyến phức tạp?
- Điều gì sẽ xảy ra nếu kích thước mẫu
quá nhỏ hoặc phân phối bị lệch cực đoan khiến xấp xỉ chuẩn tắc không còn đáng tin cậy?
Trước kỷ nguyên bùng nổ của máy tính điện tử, các nhà thống kê gần như bất lực trước những tình huống này, hoặc buộc phải đặt ra các giả thiết phân phối lý thuyết hết sức khắt khe (chẳng hạn như giả định tuân theo phân phối chuẩn hoàn hảo).
Đến năm 1979, nhà thống kê học lỗi lạc Bradley Efron tại Đại học Stanford đã đề xuất một phương pháp tính toán mang tính cách mạng: Phương pháp Bootstrapping (Tái lấy mẫu). Phương pháp này tận dụng sức mạnh tính toán của máy tính để định lượng sai số chọn mẫu mà không cần phụ thuộc vào bất kỳ công thức giải tích phức tạp hay giả định phân phối nghiêm ngặt nào.
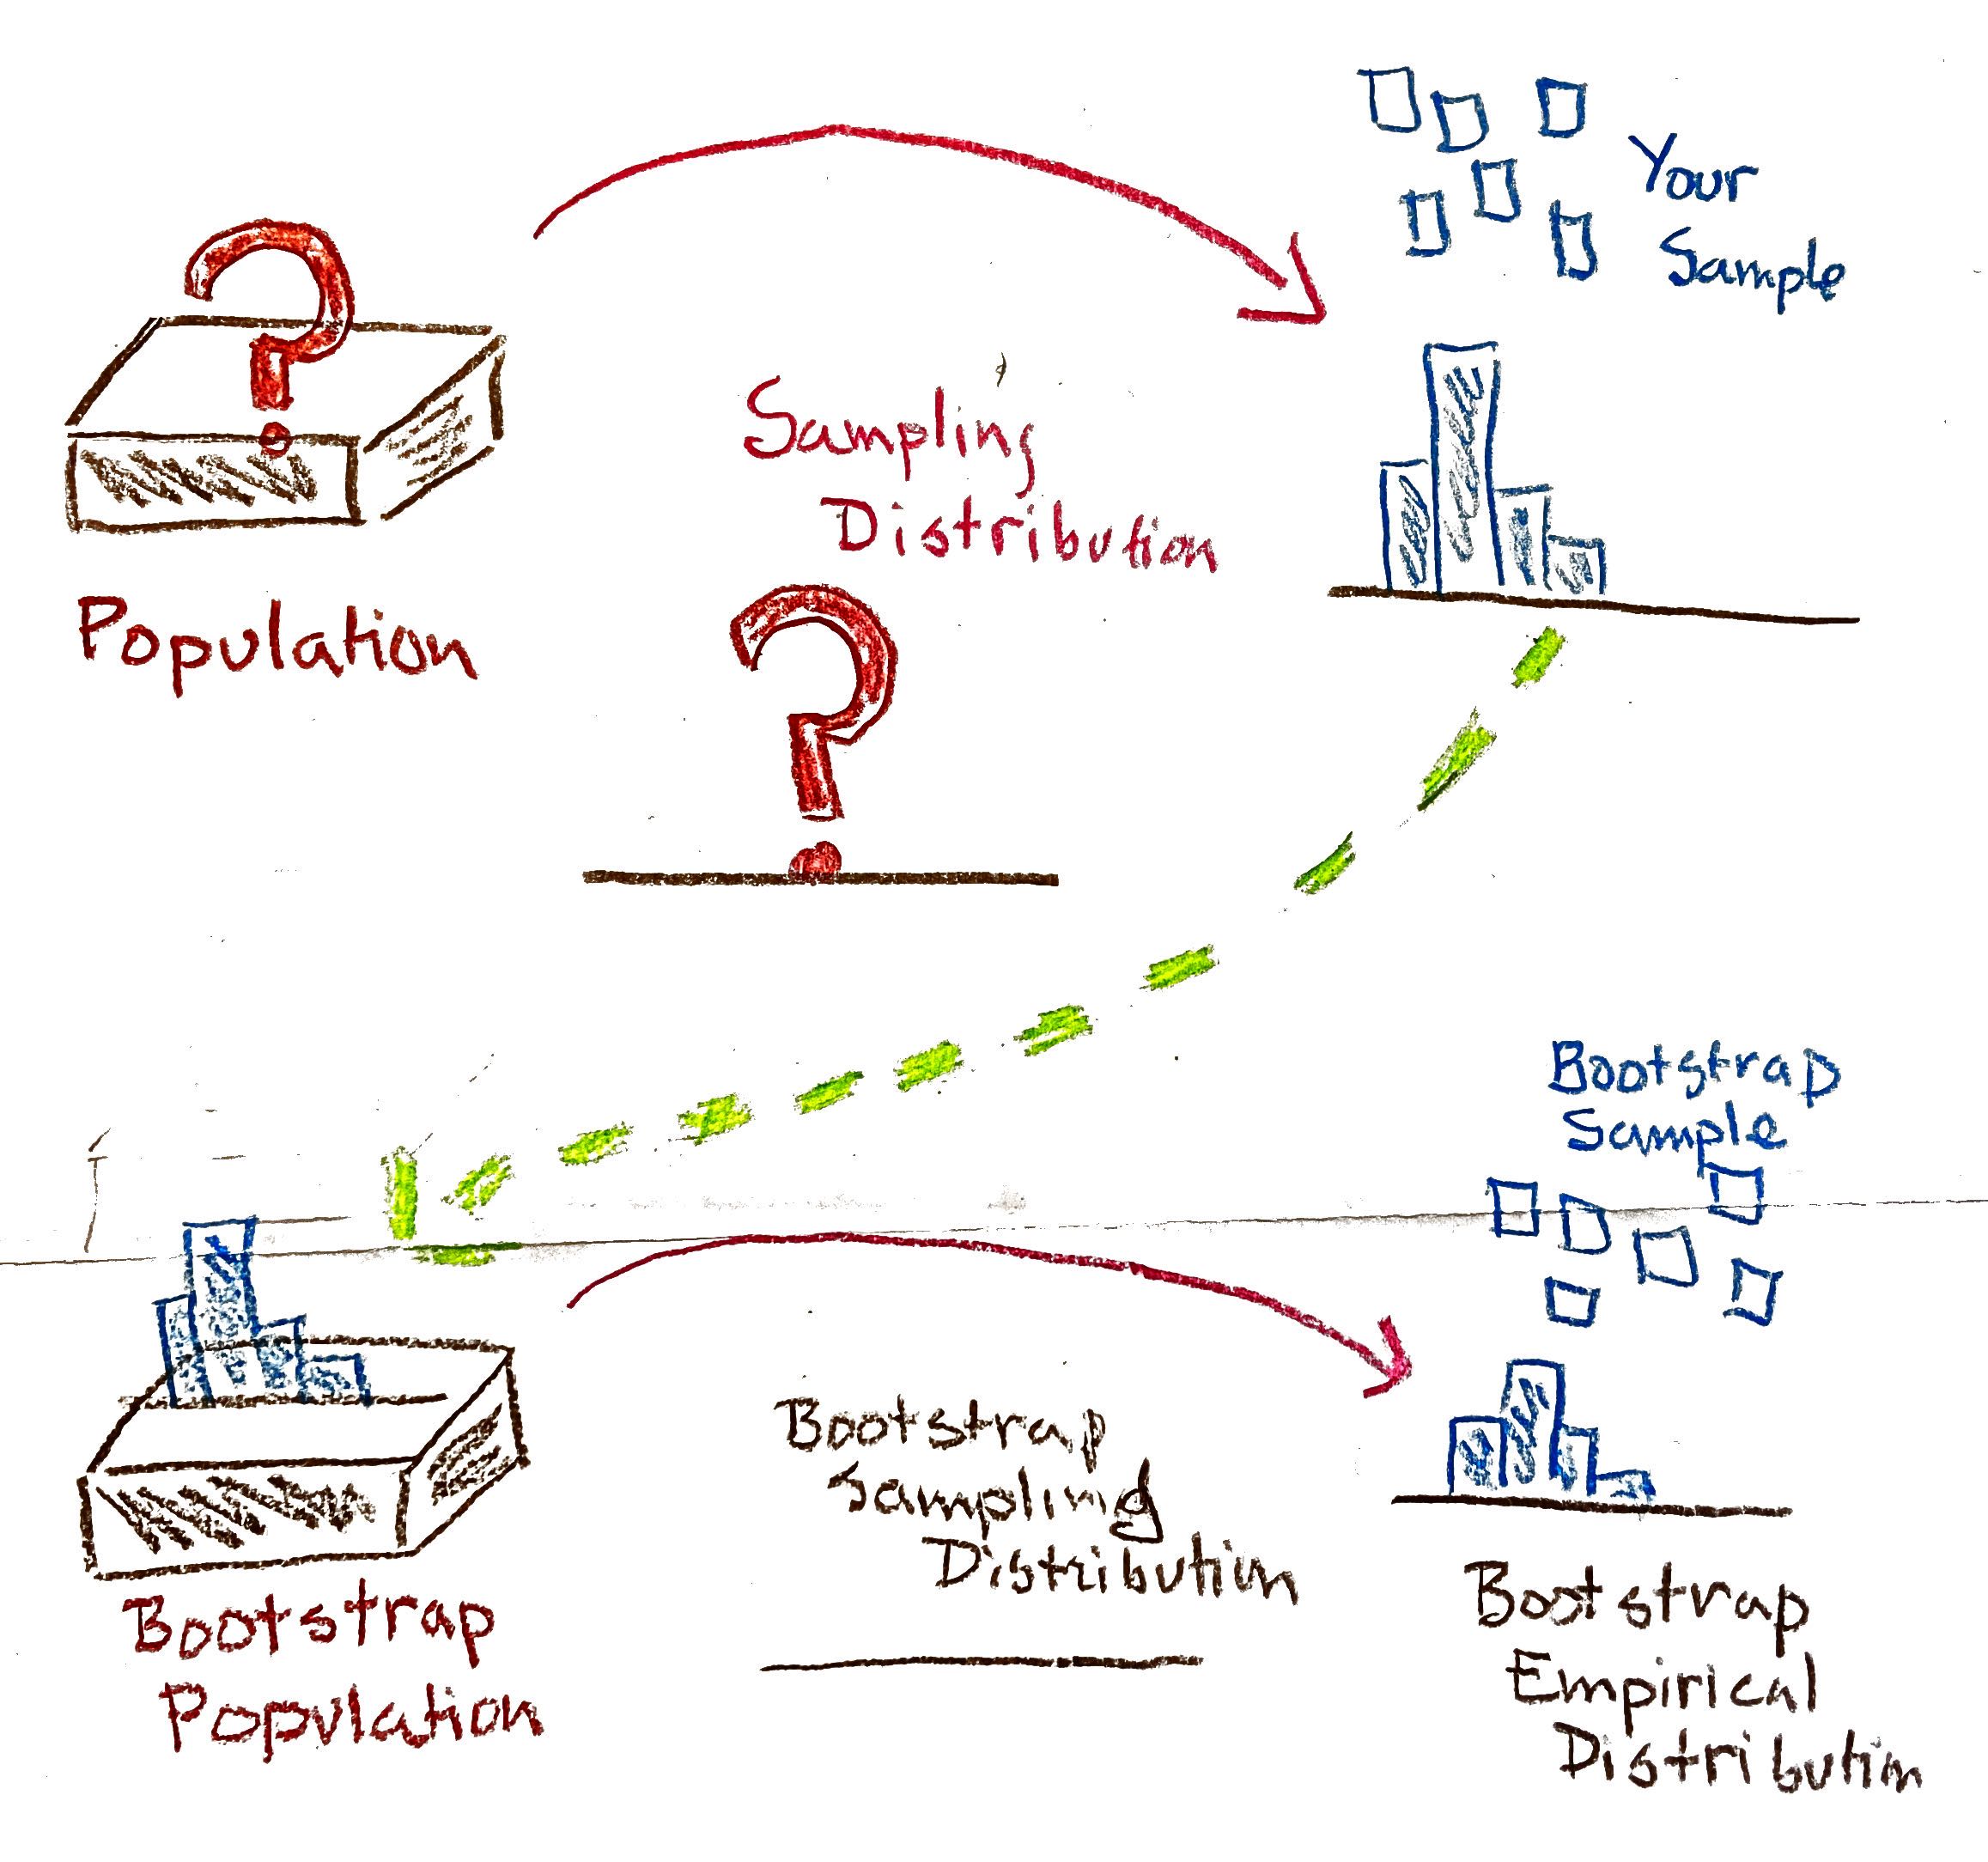
Hình 17.1: Nguyên lý Bootstrapping: Mẫu dữ liệu ban đầu đóng vai trò làm 'tổng thể Bootstrap' để mô phỏng phân phối chọn mẫu.
Bản chất của Phương pháp Bootstrapping
Tên gọi Bootstrap bắt nguồn từ thành ngữ dân gian tiếng Anh: "To pull yourself up by your own bootstraps" (tự nhấc mình lên bằng chính quai giày của mình). Thành ngữ này hàm ý một hành động dường như bất khả thi: Tự lực cánh sinh để vươn lên mà không cần sự trợ giúp từ bên ngoài.
Trong thống kê, thành ngữ này phản ánh bản chất kỳ diệu của phương pháp: Dù trong thực tế chúng ta chỉ thu thập được duy nhất một mẫu quan sát từ , phương pháp Bootstrap cho phép chúng ta dùng chính mẫu đơn lẻ đó để tạo ra vô số mẫu mới thông qua kỹ thuật tái lấy mẫu có hoàn lại (resampling with replacement)!
Trực giác triết học đằng sau phương pháp Bootstrap:
- Nếu mẫu ban đầu được thu thập bằng phương pháp ngẫu nhiên không thiên lệch (chẳng hạn SRS), thì phân phối thực nghiệm của mẫu chính là bản sao thu nhỏ tốt nhất của phân phối mà ta có thể tiếp cận được.
- Vì ta không thể quay lại thực để lấy thêm nhiều mẫu mới, ta thay thế thao tác đó bằng việc lấy các mẫu mới từ chính phân phối thực nghiệm của mẫu ban đầu!
Thuật toán Tái lấy mẫu Bootstrap (The Bootstrap Algorithm)
Thuật toán: Quy trình Tái lấy mẫu Bootstrap
Để ước lượng sai số chuẩn và xây dựng khoảng tin cậy cho một thống kê mẫu
- Bước 1 (Thiết lập Bootstrap): Coi mẫu dữ liệu ban đầu gồm
quan sát như một chiếc hộp chứa đúng tấm vé, đại diện cho "tổng thể Bootstrap". - Bước 2 (Rút mẫu Bootstrap): Rút ngẫu nhiên một mẫu mới có kích thước đúng bằng
từ Bootstrap theo phương thức có hoàn lại (with replacement). Mẫu này được gọi là một mẫu Bootstrap (resample). - Bước 3 (Tính thống kê Bootstrap): Tính toán giá trị của đại lượng thống kê quan tâm trên mẫu Bootstrap vừa rút được, ký hiệu là
. - Bước 4 (Lặp lại mô phỏng): Lặp lại Bước 2 và Bước 3 một số lượng lớn lần (thường từ
đến lần) để thu được tập hợp giá trị thống kê: . - Bước 5 (Xây dựng phân phối Bootstrap): Tập hợp các giá trị
tạo thành phân phối chọn mẫu Bootstrap (Bootstrap Sampling Distribution).
Minh họa trực quan qua bài toán 5 chú chim cánh cụt
Để nắm bắt cơ chế vận hành của việc rút thăm có hoàn lại, hãy xét một ví dụ minh họa đơn giản với mẫu ban đầu gồm
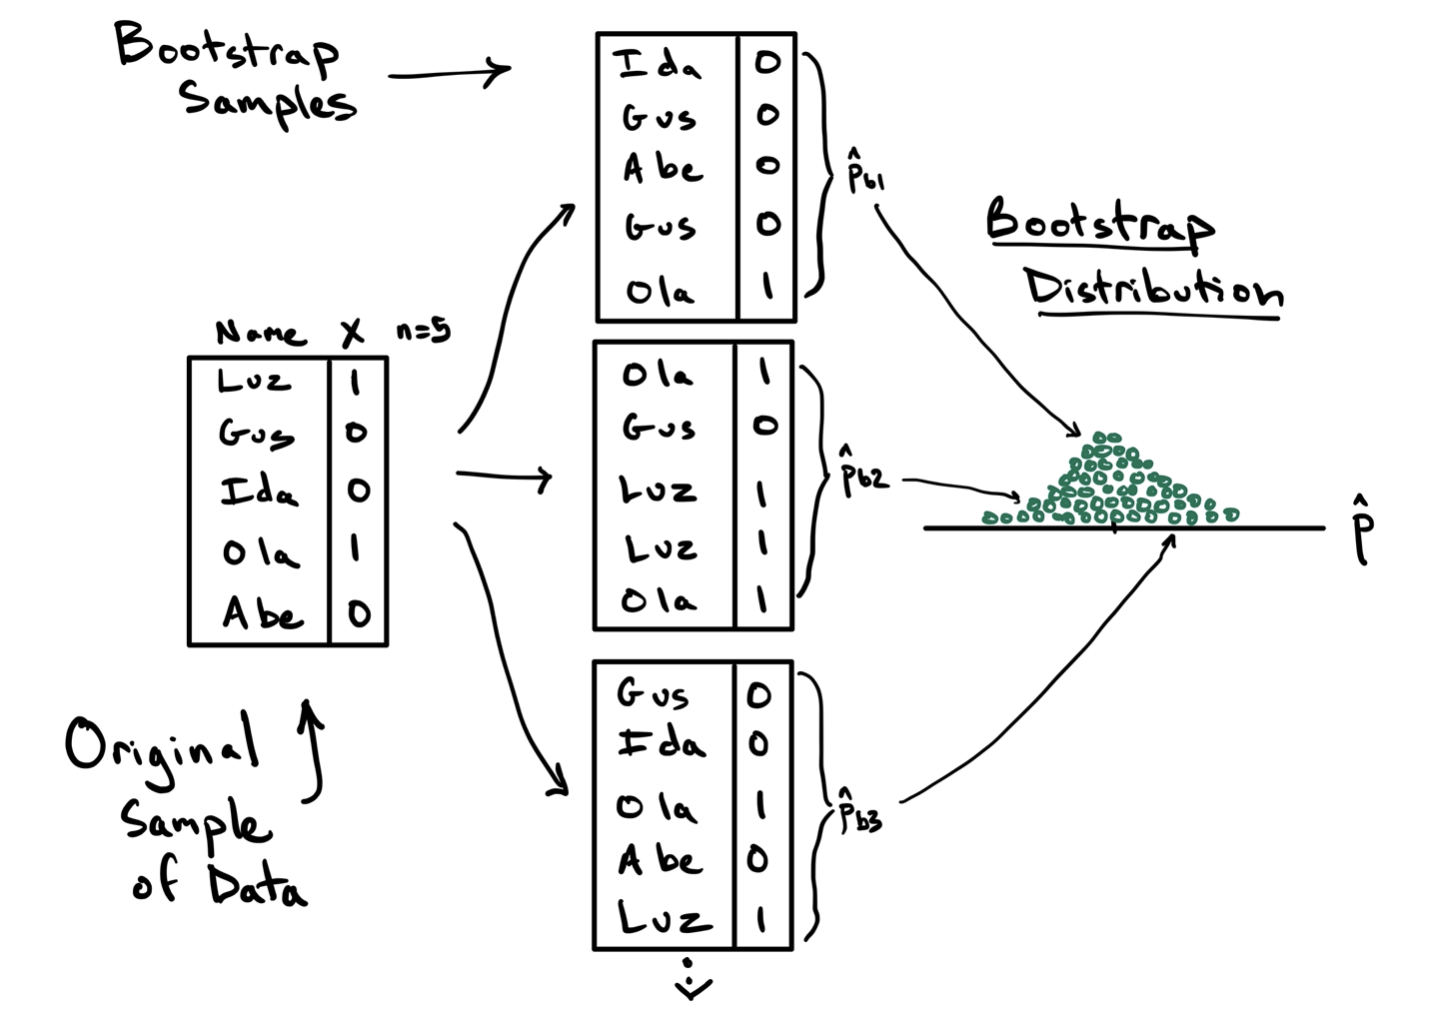
Hình 17.2: Cơ chế tái lấy mẫu có hoàn lại trên mẫu $n = 5$ chú chim cánh cụt.
Quan sát kỹ Bước 2 trong Hình 17.2:
- Ở mẫu Bootstrap thứ nhất, ta rút được:
Ida, Gus, Abe, Gus, Ola. - Điểm đặc trưng cốt tử của việc rút thăm có hoàn lại: Một cá thể có thể được chọn nhiều lần (
Gusxuất hiện 2 lần), trong khi một số cá thể khác có thể hoàn toàn không được chọn (Luzvắng mặt). - Nhờ có cơ chế hoàn lại, mẫu Bootstrap mới có cơ hội tạo ra tổ hợp dữ liệu khác biệt so với mẫu gốc, từ đó tạo ra giá trị thống kê Bootstrap mới
.
(Lưu ý sư phạm: Mẫu
Khoảng tin cậy Bootstrap theo Phương pháp Phân vị (Percentile Method)
Sau khi thu được phân phối chọn mẫu Bootstrap gồm
Cách tiếp cận tự nhiên và trực quan nhất là Phương pháp phân vị (Percentile Bootstrap Confidence Interval):
Công thức: Khoảng tin cậy Bootstrap Phân vị
Khoảng tin cậy
Trong đó
Cụ thể, đối với khoảng tin cậy 95% (
- Cận dưới: Là phân vị thứ
(quantile ) của phân phối Bootstrap. - Cận trên: Là phân vị thứ
(quantile ) của phân phối Bootstrap.
Ưu điểm tuyệt đối của phương pháp phân vị:
- Hoàn toàn không cần công thức giải tích tính sai số chuẩn.
- Không cần giả định phân phối có dạng đối xứng hay dạng chuông chuẩn tắc, do đó nếu phân phối Bootstrap bị lệch, khoảng tin cậy sẽ tự động thích ứng và bị lệch theo một cách tự nhiên.
Nghiên cứu điển hình 1: Điểm an toàn thực phẩm tại San Francisco
Hãy áp dụng thuật toán Bootstrap vào bộ dữ liệu điểm an toàn thực phẩm của các nhà hàng San Francisco mà chúng ta đã làm quen ở bài học trước.
Mẫu ban đầu gồm
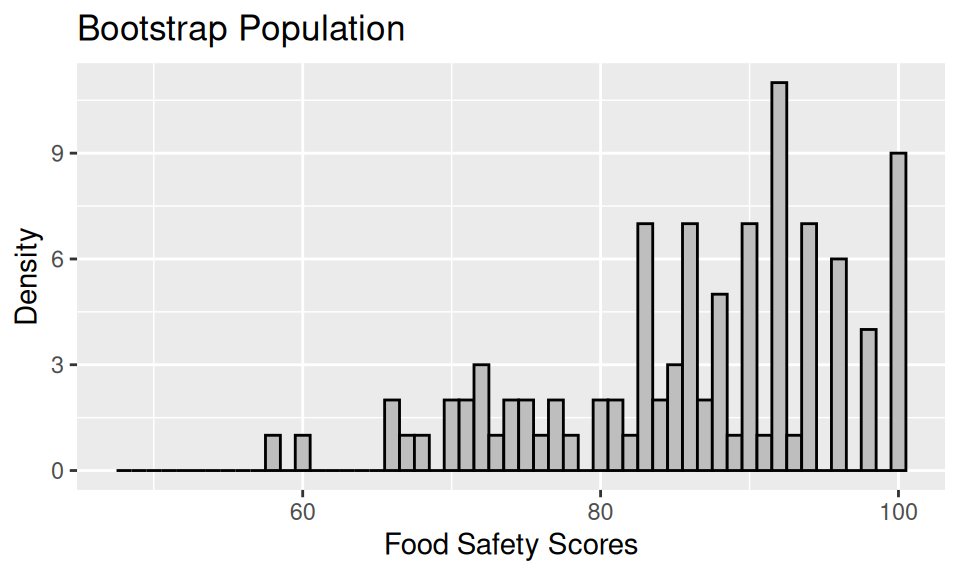
Hình 17.3: Phân phối chọn mẫu Bootstrap của 500 giá trị trung bình mẫu từ bộ dữ liệu nhà hàng San Francisco.
So sánh phân phối Bootstrap này với phân phối chọn mẫu lý thuyết:
- Hình dạng: Phân phối Bootstrap phản ánh chân thực hình dạng quả chuông của phân phối chọn mẫu thực sự.
- Tâm đối xứng: Tâm của phân phối Bootstrap nằm tại
, gần như trùng khít với trung bình mẫu ban đầu ( ). Cần lưu ý rằng nó tập trung quanh , chứ không tập trung quanh tham số thực của ( ). - Độ phân tán (Sai số chuẩn): Độ lệch chuẩn của 500 giá trị Bootstrap là
. Con số này trùng khớp hoàn hảo với công thức giải tích !
Tìm hai phân vị
Khi đối chiếu khoảng này với khoảng tin cậy tính bằng phân phối chuẩn ở bài học trước (
Nghiên cứu điển hình 2: Hệ số hồi quy khối lượng chim cánh cụt Adelie
Sức mạnh thực sự của Bootstrapping bộc lộ rực rỡ nhất khi ta cần xây dựng khoảng tin cậy cho các mô hình phức tạp mà công thức giải tích cổ điển rất khó thiết lập hoặc đòi hỏi nhiều giả định phi thực tế.
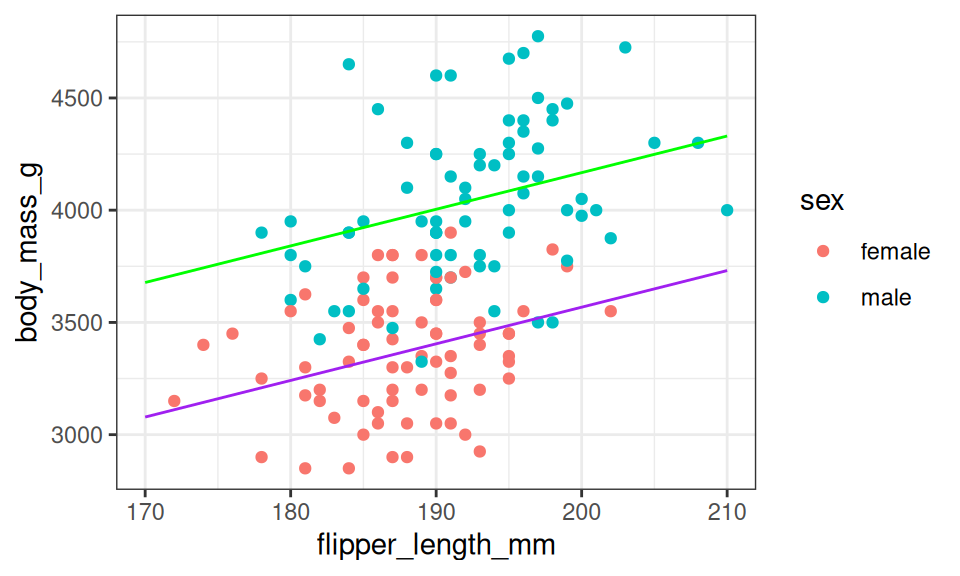
Xét bài toán nghiên cứu sinh thái học: Các nhà nghiên cứu muốn dự báo khối lượng cơ thể (
Khớp mô hình hồi quy tuyến tính trên mẫu gồm
Hình 17.4: Mối quan hệ giữa chiều dài cánh và khối lượng cơ thể của chim cánh cụt Adelie được phân tách bởi hai đường hồi quy song song theo giới tính.
Hệ số hồi quy ước lượng của chiều dài cánh là
Một câu hỏi cốt tử: Giá trị
Áp dụng Bootstrap cho Mô hình Hồi quy
Ta thực hiện thuật toán Bootstrap trên các dòng dữ liệu:
- Bootstrap gồm
dòng dữ liệu đầy đủ của các cá thể chim cánh cụt. - Mỗi lần rút mẫu, ta bốc ngẫu nhiên nguyên cả dòng dữ liệu (gồm cả khối lượng, chiều dài cánh và giới tính) có hoàn lại để tạo thành một mẫu mới gồm 146 dòng.
- Trên mẫu Bootstrap này, ta khớp lại mô hình hồi quy tuyến tính bội và trích xuất hệ số góc của biến chiều dài cánh
. - Lặp lại quy trình
lần.
Hình 17.5: Phân phối Bootstrap của hệ số hồi quy chiều dài cánh qua 500 lần tái lấy mẫu.
Từ phân phối Bootstrap ở Hình 17.5, ta trích xuất phân vị thứ
Khoảng tin cậy
Những giới hạn và Cảnh báo quan trọng khi dùng Bootstrap
Mặc dù Bootstrapping là một công cụ cực kỳ linh hoạt và mạnh mẽ, nó không phải là phương thuốc vạn năng. Người làm thống kê cần nắm vững bốn giới hạn cốt tử:
Bốn cạm bẫy cần tránh khi sử dụng Bootstrapping
- Bootstrap không thể cứu vãn một mẫu bị thiên lệch (Selection Bias): Nếu mẫu ban đầu là mẫu thuận tiện hoặc bị sai lệch có hệ thống, " Bootstrap" cũng sẽ bị sai lệch tương ứng. Tái lấy mẫu hàng triệu lần từ một mẫu méo mó sẽ chỉ tạo ra một phân phối Bootstrap hội tụ quanh một giá trị sai lệch.
- Cỡ mẫu ban đầu phải đủ lớn: Nếu cỡ mẫu ban đầu quá nhỏ (chẳng hạn
hay ), mẫu không thể bao quát các đặc trưng cơ bản của . Phân phối Bootstrap thu được sẽ rất nghèo nàn và không phản ánh đúng sai số thực tế. - Thống kê bị chi phối bởi ngoại lai hoặc giá trị cực trị: Bootstrapping hoạt động kém hiệu quả đối với các đại lượng thống kê nhạy cảm cao với điểm biên như giá trị cực đại
, cực tiểu , hoặc dữ liệu có phân phối đuôi dày cực đoan. - Quy trình tái lấy mẫu phải bảo toàn cấu trúc dữ liệu: Khi làm việc với dữ liệu đa biến hoặc dữ liệu không gian/thời gian, ta phải tái lấy mẫu nguyên cả quan sát (toàn bộ dòng trong bảng dữ liệu), tuyệt đối không được tráo đổi ngẫu nhiên từng cột riêng lẻ làm phá vỡ tương quan giữa các biến.
Về số lượng lần tái lấy mẫu: Trong thực hành nghiên cứu chuyên sâu, quy tắc chung là thực hiện từ
Tóm tắt kiến thức cốt lõi
- Ý tưởng cốt lõi: Phân phối thực nghiệm của mẫu đại diện đóng vai trò xấp xỉ phân phối , trong khi việc tái lấy mẫu có hoàn lại từ mẫu đóng vai trò mô phỏng việc lấy mẫu từ tổng thể.
- Quy tắc tái lấy mẫu: Mẫu Bootstrap bắt buộc phải được rút có hoàn lại và có cùng kích thước
với mẫu dữ liệu ban đầu. - Phương pháp phân vị: Khoảng tin cậy
Bootstrap được thiết lập trực tiếp bằng hai phân vị và của phân phối các thống kê Bootstrap. - Ứng dụng vượt trội: Áp dụng hiệu quả cho các đại lượng thống kê phức tạp (hệ số hồi quy, trung vị, tỉ số) mà không đòi hỏi giả thiết phân phối chuẩn.
Bài tập rèn luyện
Bài tập 1: Nhận diện Mẫu Bootstrap Hợp lệ
Xét một mẫu dữ liệu ban đầu gồm
| Mã cá thể | Tên gọi | Loài (Species) | Chiều dài cánh (mm) |
|---|---|---|---|
| 1 | Gus | Chinstrap | 50.7 |
| 2 | Luz | Gentoo | 48.5 |
| 3 | Ida | Chinstrap | 52.8 |
| 4 | Ola | Gentoo | 44.5 |
| 5 | Abe | Adelie | 42.0 |
Hãy phân tích và đánh giá xem các mẫu đề xuất dưới đây, mẫu nào là mẫu Bootstrap hợp lệ được rút từ mẫu ban đầu trên:
- Mẫu A:
Ida(Chinstrap, 52.8),Luz(Gentoo, 48.5),Abe(Adelie, 42.0),Ola(Gentoo, 44.5),Ida(Chinstrap, 52.8). - Mẫu B:
Ola(Gentoo, 44.5),Gus(Chinstrap, 50.7),Ida(Chinstrap, 52.8),Luz(Gentoo, 48.5),Gus(Chinstrap, 50.7),Gus(Chinstrap, 50.7). - Mẫu C:
Gus(Chinstrap, 50.7),Ola(Gentoo, 48.5),Ola(Chinstrap, 52.8),Ida(Gentoo, 44.5),Ida(Adelie, 42.0). - Mẫu D:
Gus(Chinstrap, 50.7),Abe(Adelie, 42.0),Gus(Chinstrap, 50.7),Gus(Chinstrap, 50.7),Gus(Chinstrap, 50.7).
Lời giải chi tiết
Để một mẫu được coi là mẫu Bootstrap hợp lệ từ mẫu dữ liệu ban đầu gồm
- Kích thước mẫu phải đúng bằng kích thước ban đầu:
. - Mỗi quan sát trong mẫu phải là một dòng dữ liệu nguyên vẹn xuất hiện trong mẫu gốc (các biến đi cùng nhau không bị xáo trộn).
- Được rút theo phương thức có hoàn lại, tức là một dòng có thể lặp lại nhiều lần hoặc vắng mặt.
Đánh giá từng mẫu:
Mẫu A:
- Kích thước: Gồm đúng 5 quan sát.
- Mỗi dòng là một quan sát nguyên vẹn từ bảng gốc:
Ida(lặp lại 2 lần),Luz,Abe,Ola.Gusvắng mặt. Mẫu A là mẫu Bootstrap hoàn toàn hợp lệ.
Mẫu B:
- Kích thước: Gồm 6 quan sát (
). Vi phạm điều kiện kích thước mẫu. Mẫu B không hợp lệ.
- Kích thước: Gồm 6 quan sát (
Mẫu C:
- Kích thước: Gồm 5 quan sát.
- Tuy nhiên, quan sát dòng 2 ghi
Olanhưng chiều dài cánh lại là(chiều dài của Luz), dòng 3 ghiOlavới loàiChinstrap(loài gốc làGentoo). Mẫu này đã tráo đổi ngẫu nhiên các cột thay vì rút nguyên dòng dữ liệu. Mẫu C không hợp lệ.
Mẫu D:
- Kích thước: Gồm đúng 5 quan sát.
- Mọi dòng đều nguyên vẹn từ bảng gốc:
Gus(xuất hiện 4 lần) vàAbe(xuất hiện 1 lần). - Mặc dù đây là một kết cục rút thăm ít có khả năng xảy ra trong thực tế, về mặt lý thuyết xác suất rút thăm có hoàn lại, việc một phần tử được bốc 4 lần vẫn là hoàn toàn hợp lệ.
Mẫu D về mặt nguyên tắc toán học là một mẫu Bootstrap hợp lệ (nhưng trong thực hành ta ưu tiên Mẫu A vì đại diện cho các lần rút thông thường).
Bài tập 2: Xác định Phân vị cho các Mức độ Tin cậy
Một nhà phân tích dữ liệu thực hiện thuật toán Bootstrap trên một mẫu quan sát và tạo ra
- Để xây dựng khoảng tin cậy 90% theo phương pháp phân vị, nhà phân tích cần chọn các giá trị tại vị trí thứ mấy trong danh sách đã sắp xếp?
- Để xây dựng khoảng tin cậy 95% theo phương pháp phân vị, các vị trí tương ứng là bao nhiêu?
- Nếu tăng số lần tái lấy mẫu lên
lần, vị trí cận dưới và cận trên của khoảng tin cậy 95% sẽ thay đổi như thế nào?
Lời giải chi tiết
1. Khoảng tin cậy 90% với
- Phân vị cận dưới:
Vị trí trong danh sách: . - Phân vị cận trên:
Vị trí trong danh sách: . Khoảng tin cậy 90% là .
2. Khoảng tin cậy 95% với
- Phân vị cận dưới:
Vị trí: . - Phân vị cận trên:
Vị trí: . Khoảng tin cậy 95% là .
3. Khi tăng lên
- Cận dưới mức
: . - Cận trên mức
: . Khoảng tin cậy 95% sẽ được xác định bởi . Việc tăng lên 10,000 giúp các điểm phân vị này có độ ổn định số học cao hơn, giảm bớt sai số ngẫu nhiên của mô phỏng máy tính.
Bài tập 3: Tâm của Phân phối Bootstrap và Bản chất của Ước lượng
Một sinh viên sau khi chạy mô phỏng Bootstrap 500 lần từ một mẫu
- Hãy giải thích tại sao tâm của phân phối Bootstrap luôn tập trung quanh giá trị thống kê mẫu gốc
mà không tập trung quanh tham số . - Nếu tâm của phân phối Bootstrap không tập trung quanh
, thì phân phối Bootstrap cung cấp thông tin quý giá nào cho nhà nghiên cứu? - Điều gì sẽ xảy ra với phân phối Bootstrap nếu mẫu ban đầu là một mẫu bị thiên lệch nghiêm trọng (Selection Bias)?
Lời giải chi tiết
1. Lý do tâm của phân phối Bootstrap tập trung quanh
- Trong thuật toán Bootstrap, "" mà máy tính thực hiện rút thăm chính là mẫu dữ liệu ban đầu (gồm
quan sát). - Theo tính chất của phép lấy mẫu ngẫu nhiên có hoàn lại từ một tập hợp gồm
giá trị cố định, giá trị kỳ vọng của một lần rút đơn lẻ bằng đúng trung bình cộng của giá trị đó ( ). - Do đó, giá trị kỳ vọng của trung bình các mẫu tái lấy mẫu phải hội tụ về chính giá trị thống kê của mẫu ban đầu:
. - Máy tính hoàn toàn không được tiếp cận với thực tế bên ngoài, do đó nó không thể biết
ở đâu để định tâm phân phối quanh .
2. Giá trị then chốt mà phân phối Bootstrap mang lại:
- Mục đích tối thượng của phương pháp Bootstrap không phải là tìm ra vị trí chính xác của tham số
(vị trí này đã được ước lượng điểm bởi ). - Mục đích của Bootstrap là mô phỏng hình dạng và độ phân tán (biến thiên lấy mẫu) của quá trình chọn mẫu. Nó trả lời câu hỏi: "Nếu quy trình lấy mẫu được lặp lại, thống kê mẫu sẽ dao động quanh tâm của nó với biên độ bao nhiêu (SE bằng bao nhiêu)?".
- Bằng cách đo lường độ phân tán quanh
, ta xây dựng được độ rộng chuẩn xác cho khoảng tin cậy bao quanh tham số .
3. Hậu quả khi mẫu ban đầu bị thiên lệch:
- Nếu mẫu ban đầu bị thiên lệch (Selection Bias), chẳng hạn
bị lệch xa khỏi , thì Bootstrap sẽ là một bản sao sai lệch của thế giới thực. - Phân phối Bootstrap thu được sẽ tập trung chụm quanh giá trị sai lệch đó. Toàn bộ khoảng tin cậy Bootstrap sẽ bị dịch chuyển lệch hẳn khỏi tham số thực
. - Điều này chứng minh rằng: Bootstrapping chỉ định lượng được sai số do biến thiên chọn mẫu (Sampling Variability), hoàn toàn không thể phát hiện hay sửa chữa sai số do độ lệch hệ thống (Bias).
Tài liệu tham khảo
- UC Berkeley STAT 20: Introduction to Probability and Statistics, Department of Statistics, UC Berkeley.
- Efron, B., & Tibshirani, R. J. (1994). An Introduction to the Bootstrap. CRC Press.