Giao diện
1. Giới thiệu: Đánh giá chất lượng của một cỗ máy dự báo
Trong bài học trước, chúng ta đã chế tạo cỗ máy dự báo đầu tiên: Một đường thẳng hồi quy tối thiểu hóa tổng bình phương phần dư (OLS). Sau khi đã khớp mô hình với dữ liệu quan sát, ta có thể dễ dàng trả lời những câu hỏi dự phóng trong tương lai.
Xét bài toán thực tế: tỉ lệ tốt nghiệp trung học phổ thông (
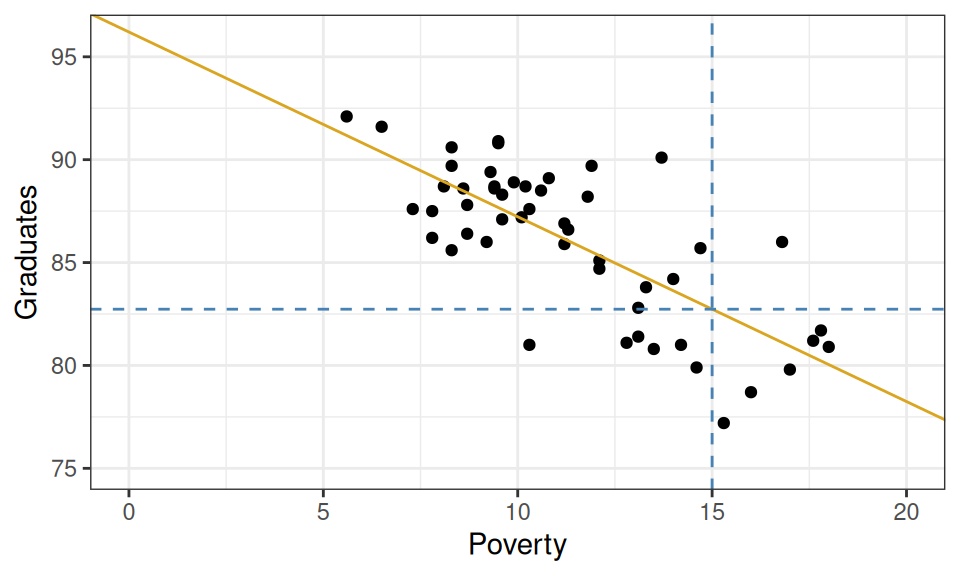 Hình 25.1: Đường hồi quy tỉ lệ tốt nghiệp trung học từ tỉ lệ hộ nghèo cấp bang.
Nếu một bang có tỉ lệ nghèo là
Câu hỏi then chốt đặt ra cho nhà khoa học dữ liệu là: Mức
Chúng ta không thể chờ đợi tương lai để kiểm chứng độ chính xác tuyệt đối của từng điểm dự báo đơn lẻ. Tuy nhiên, chúng ta hoàn toàn có thể đo lường xem mô hình đã nắm bắt và giải thích được bao nhiêu phần cấu trúc biến thiên trong tập dữ liệu quá khứ.
Bài học này tập trung vào hai vấn đề cốt lõi:
- Làm thế nào để định lượng chất lượng khớp dữ liệu của một mô hình dự báo?
- Những chiến lược nào có thể giúp cải thiện độ chính xác của các dự báo đó?
2. Đo lường năng lực giải thích: Hệ số xác định
Để đánh giá chất lượng dự báo của mô hình
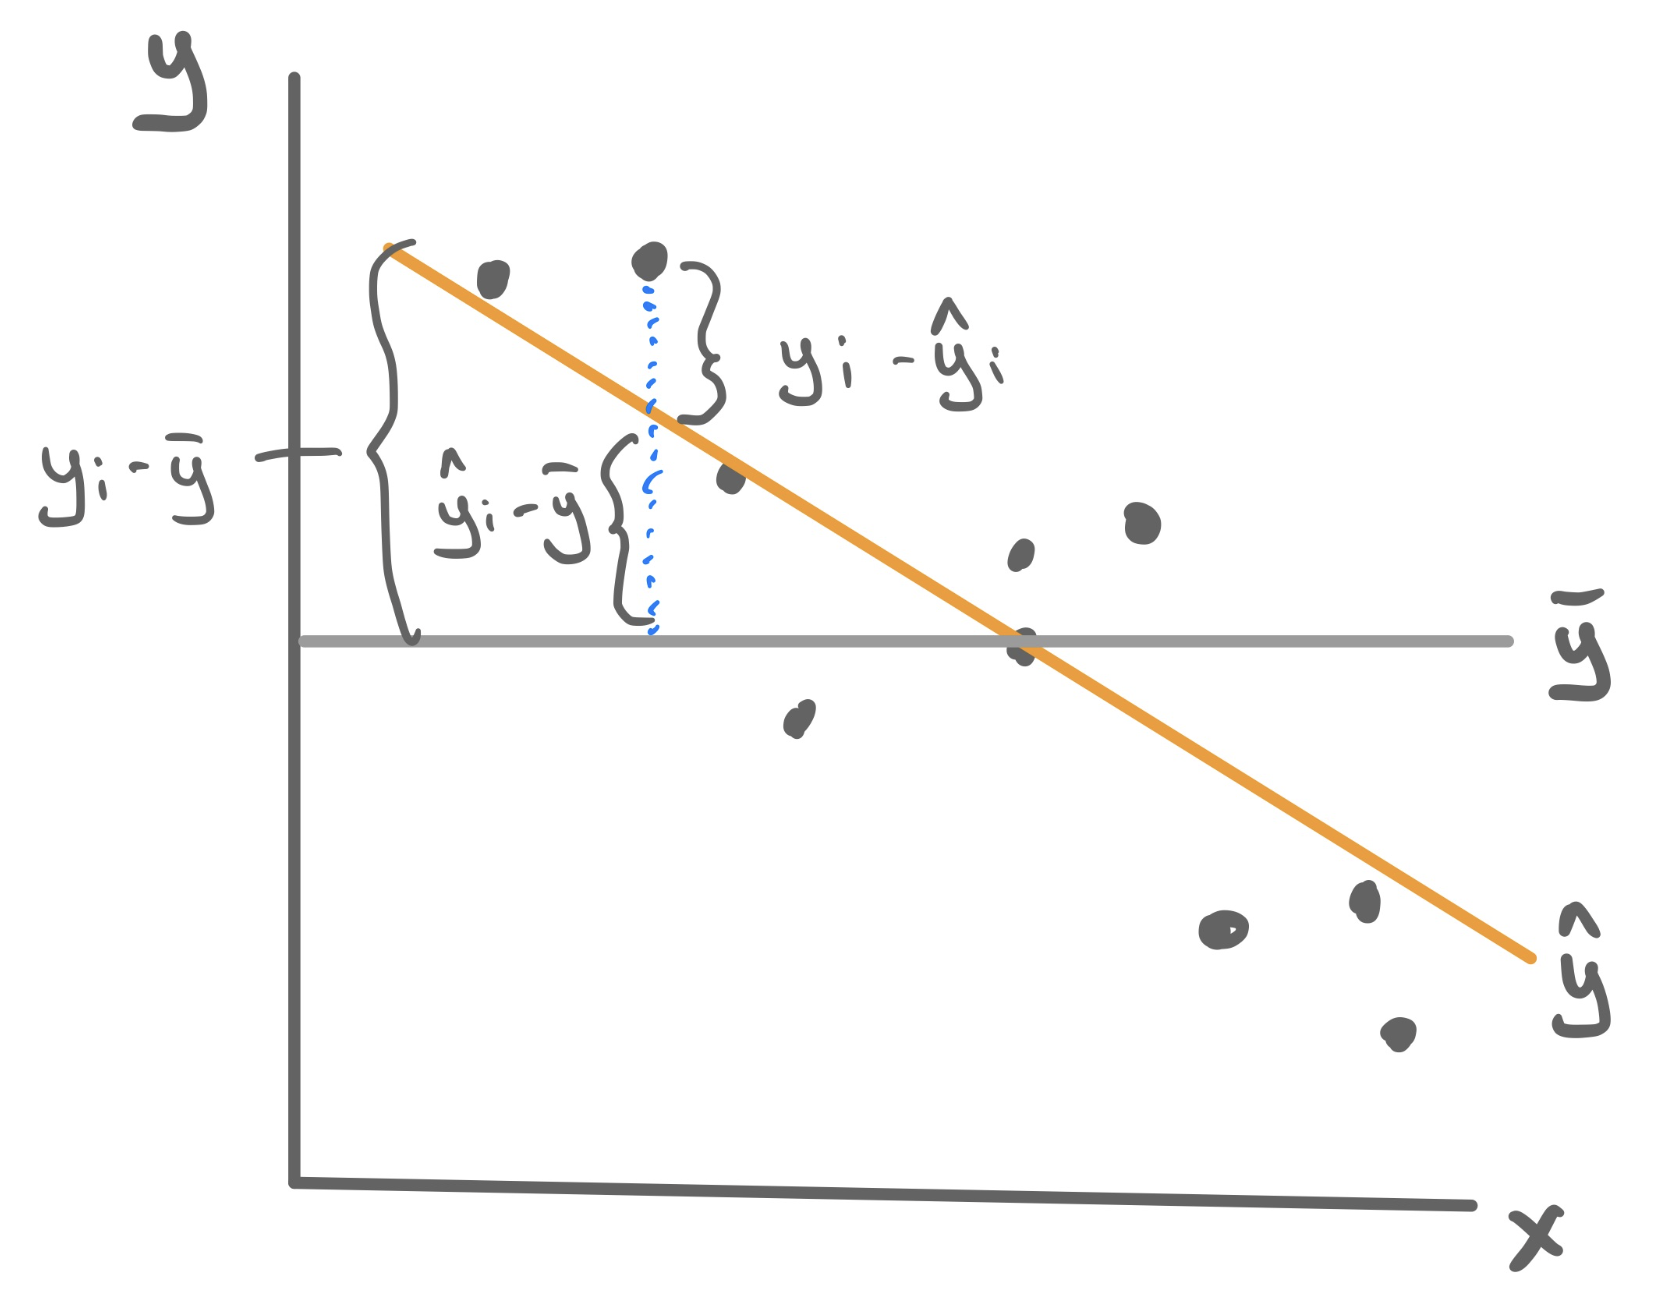 Hình 25.2: Phân rã biến thiên của hệ số xác định
Định lý phân rã phương sai (ANOVA Decomposition)
Trong mô hình hồi quy tuyến tính OLS có chứa hệ số chặn, tổng biến thiên của biến phản hồi
- Tổng biến thiên toàn phần (Total Sum of Squares - TSS):
- Đo lường mức độ phân tán tự nhiên của biến phản hồi
quanh giá trị trung bình khi chưa có mô hình:
- Đo lường mức độ phân tán tự nhiên của biến phản hồi
- Tổng bình phương do hồi quy giải thích (Sum of Squares due to Regression - SSR):
- Đo lường phần biến thiên mà đường hồi quy
đã nắm bắt và giải thích thành công:
- Đo lường phần biến thiên mà đường hồi quy
- Tổng bình phương phần dư (Residual Sum of Squares - RSS):
- Đo lường phần sai số còn lại mà mô hình chưa thể giải thích được:
- Đo lường phần sai số còn lại mà mô hình chưa thể giải thích được:
Định nghĩa Hệ số xác định
- Khái niệm: Hệ số
là tỉ lệ phần trăm tổng biến thiên của biến phản hồi được giải thích bởi mô hình hồi quy:
Các tính chất toán học của
- Miền giá trị:
luôn nhận giá trị nằm trong đoạn đối với mô hình OLS có hệ số chặn. - Khi
: Phần dư . Đường hồi quy đi qua hầu hết các điểm dữ liệu, mô hình có năng lực dự báo thực nghiệm rất cao. - Khi
: . Biến dự báo không cung cấp thêm bất kỳ thông tin hữu ích nào so với việc đoán mò bằng . - Trong hồi quy đơn biến: Giá trị
chính bằng bình phương của hệ số tương quan Pearson: . - Trong ví dụ về tỉ lệ nghèo và tốt nghiệp ở trên: Mô hình đạt
, đồng nghĩa với việc tỉ lệ hộ nghèo giải thích được biến thiên của tỉ lệ tốt nghiệp giữa các bang.
3. Chiến lược cải thiện 1: Bổ sung thêm biến dự báo
Một mục tiêu tự nhiên trong tối ưu hóa mô hình là tìm kiếm cỗ máy dự báo có giá trị
Xét tập dữ liệu gồm price, tính bằng USD). Ta có bốn biến dự báo tiềm năng: Điểm chất lượng món ăn (food), Điểm trang trí không gian (decor), Điểm dịch vụ phục vụ (service), và Vị trí địa lý (geo: Phía đông hay phía tây Đại lộ số 5).
Ta xây dựng bốn mô hình hồi quy lồng nhau với số lượng biến tăng dần:
- Mô hình
: price ~ food - Mô hình
: price ~ food + geo - Mô hình
: price ~ food + geo + decor - Mô hình
: price ~ food + geo + decor + service
Kết quả tính toán giá trị
| Mô hình | Các biến dự báo đưa vào | Không gian hình học | Giá trị |
|---|---|---|---|
food | Đường thẳng đơn trong không gian 2D | ||
food + geo | Hai đường thẳng song song trong 2D | ||
food + geo + decor | Hai mặt phẳng song song trong không gian 3D | ||
food + geo + decor + service | Hai siêu phẳng song song trong không gian 4D |
Định lý về tính đơn điệu của $R^2$:
Khi ta bổ sung thêm bất kỳ biến dự báo nào vào mô hình hồi quy tuyến tính OLS, giá trị
Nguyên nhân: Phương pháp OLS luôn tối thiểu hóa RSS. Trong trường hợp xấu nhất khi biến mới hoàn toàn vô dụng, thuật toán OLS chỉ việc gán hệ số của biến đó bằng
4. Chiến lược cải thiện 2: Biến đổi phi tuyến (Non-linear Transformations)
Trong tự nhiên và kinh tế, các mối liên hệ hiếm khi tuân theo dạng đường thẳng tuyệt đối. Khi đám mây điểm biểu diễn một đường cong uốn lượn, việc ép buộc một đường thẳng cứng nhắc sẽ dẫn tới sai số dự báo lớn.
Xét dữ liệu vận tốc bay trung bình (avg_speed, dặm/giờ) theo quãng đường bay (distance, dặm) của các chuyến bay thương mại:
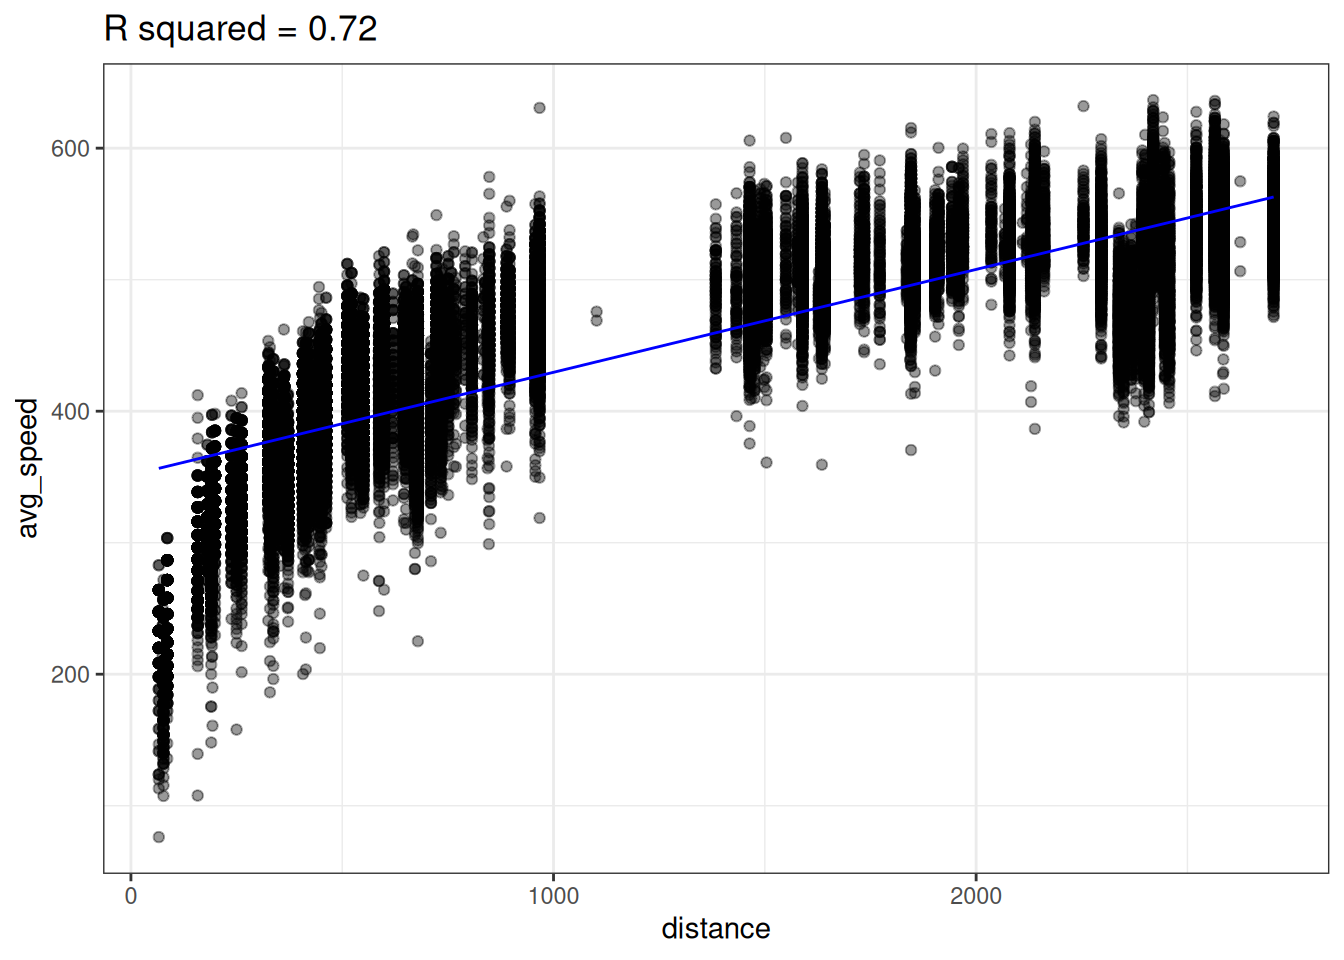 Hình 25.3: Khớp đường hồi quy tuyến tính đơn biến giữa vận tốc bay và quãng đường bay. Đường thẳng không nắm bắt được xu hướng uốn cong ở cự ly ngắn.
Quan sát Hình 25.3:
- Ở các chuyến bay ngắn (
dặm), vận tốc tăng rất nhanh theo cự ly vì máy bay dành phần lớn thời gian cất cánh và hạ cánh. - Ở các chuyến bay dài (
dặm), vận tốc đạt trần hành trình ổn định và đường biểu diễn thoải dần. Mối liên hệ có dạng hàm lõm (quy luật lợi tức giảm dần). - Đường hồi quy tuyến tính đơn giản chỉ đạt
.
Biến đổi Logarit
Để uốn nắn dữ liệu, ta áp dụng phép biến đổi logarit tự nhiên lên biến cự ly:
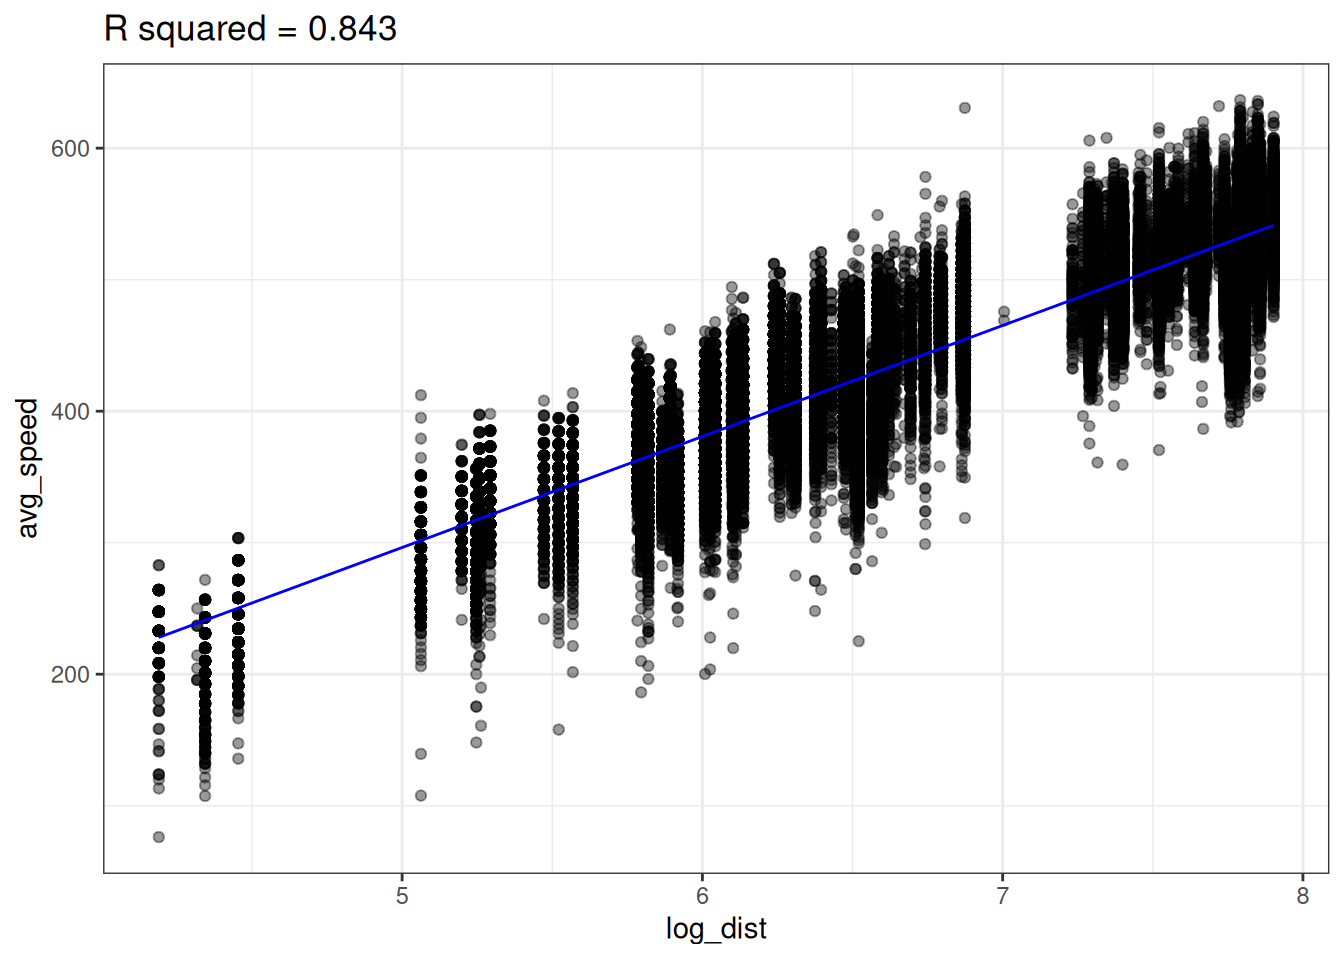 Hình 25.4: Sau khi biến đổi logarit cho biến dự báo trên trục hoành, mối liên hệ giữa vận tốc và log(cự ly) trở nên thẳng tắp một cách hoàn hảo.
Sau khi biến đổi, mô hình OLS mới đạt được phương trình:
Giá trị
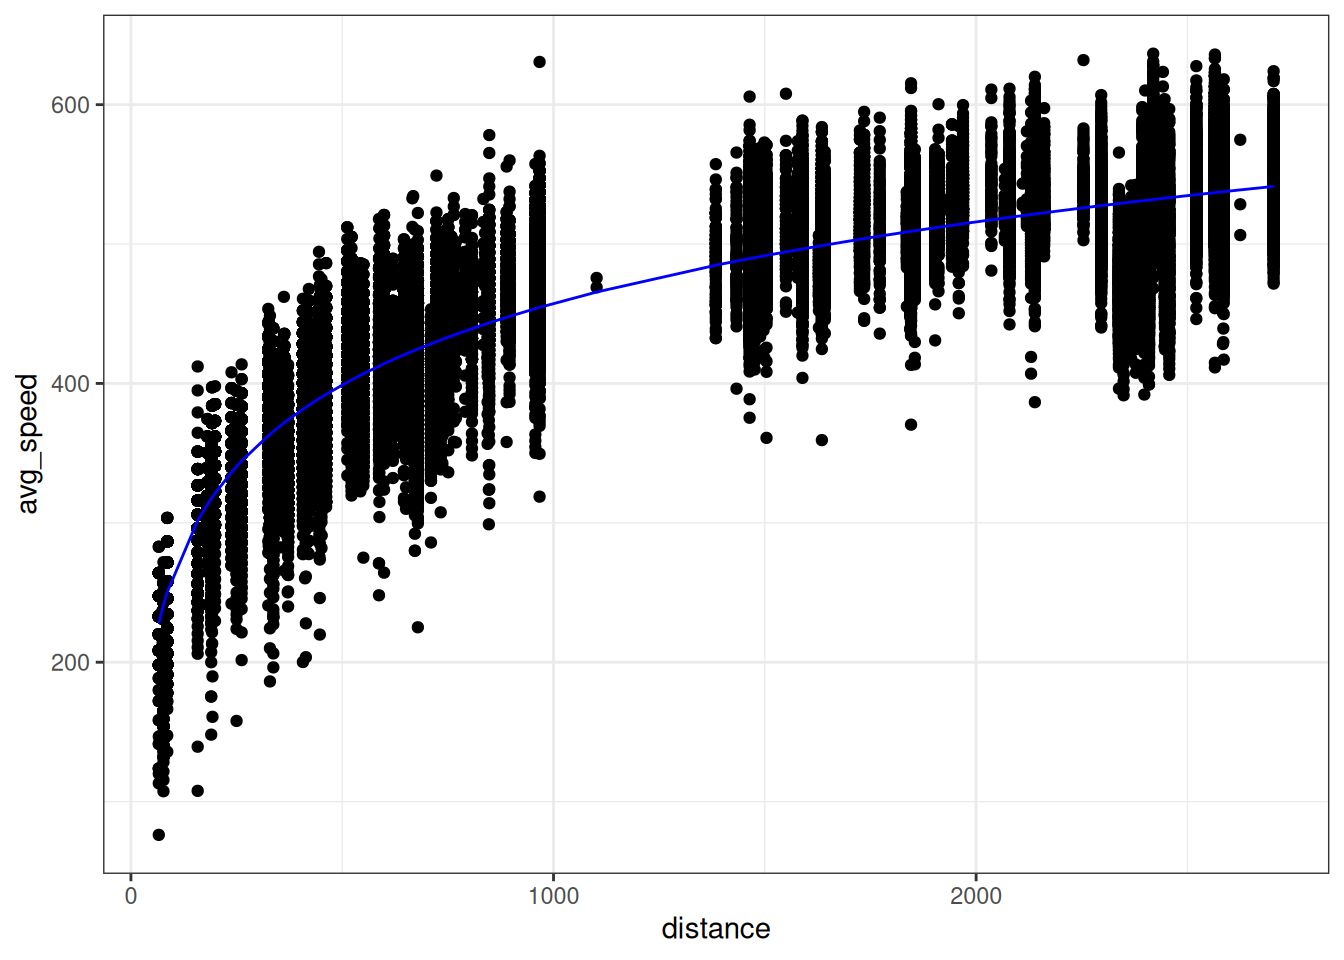 Hình 25.5: Khi chuyển phương trình dự báo ngược trở lại hệ tọa độ cự ly ban đầu, đường dự báo trở thành một đường cong mượt mà ôm sát lấy dữ liệu thực tế.
Mô hình này vừa là tuyến tính (đối với biến chuyển đổi
5. Chiến lược cải thiện 3: Hồi quy Đa thức (Polynomial Regression)
Đôi khi dữ liệu có nhiều điểm uốn sóng mà một hàm logarit hay căn bậc hai đơn giản không thể mô tả trọn vẹn. Trong trường hợp đó, đa thức bậc cao là công cụ đắc lực tiếp theo.
Một hàm đa thức bậc
Trong đó, số nguyên dương
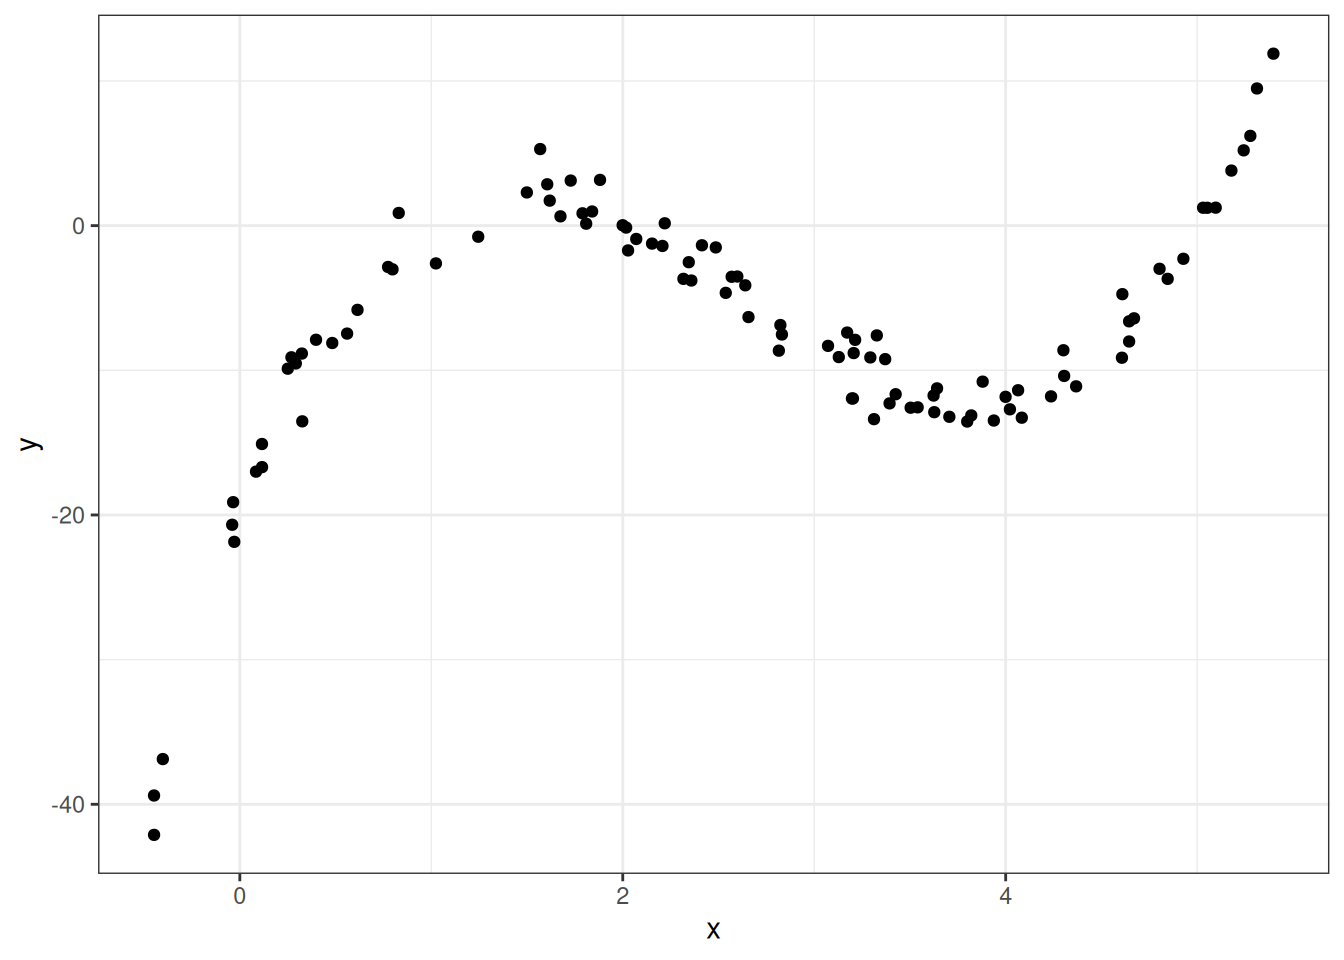 Hình 25.6: Đường hồi quy đa thức bậc 3 (
Phương trình dự báo của mô hình bậc 3 trên Hình 25.6 là:
Mặc dù đường cong dự báo uốn lượn phi tuyến theo
Mầm mống của cạm bẫy:
Nếu tiếp tục tăng bậc đa thức lên
6. Tóm tắt bài học
- Hệ số xác định
đo lường tỉ lệ phần trăm biến thiên của biến phản hồi được giải thích bởi mô hình: - Định lý phân rã phương sai:
. - Ba chiến lược gia tăng năng lực dự báo của mô hình:
- Bổ sung thêm biến dự báo: Giúp tăng diện tích thông tin đầu vào (
không bao giờ giảm). - Biến đổi phi tuyến (Log, căn bậc hai): Biến các mối quan hệ cong có lợi tức giảm dần thành quan hệ tuyến tính thẳng hàng.
- Hồi quy Đa thức: Cung cấp các đường cong linh hoạt để khớp các dạng mẫu hình phức tạp.
- Bổ sung thêm biến dự báo: Giúp tăng diện tích thông tin đầu vào (
- Tối đa hóa
trên tập dữ liệu mẫu là một mục tiêu tốt nhưng cần đi kèm sự cẩn trọng đối với rủi ro mô hình trở nên quá phức tạp.
Tài liệu tham khảo
- Wright, S. (1921). Correlation and causation. Journal of Agricultural Research, 20(7), 557–585.
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243.
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R (2nd ed.). Springer.
Bài tập tự luyện
Bài tập 1: Tính toán phân rã phương sai ANOVA và hệ số
Một nhà phân tích dữ liệu xây dựng mô hình hồi quy tuyến tính đơn biến
| Quan sát | Giá trị thực tế | Giá trị dự báo | Phần dư | |
|---|---|---|---|---|
| 1 | 1 | 2 | 1.8 | |
| 2 | 2 | 3 | 3.4 | |
| 3 | 3 | 5 | 5.0 | |
| 4 | 4 | 7 | 6.6 | |
| 5 | 5 | 8 | 8.2 |
Yêu cầu:
- Hãy tính giá trị trung bình mẫu
. - Tính Tổng biến thiên toàn phần (TSS), Tổng bình phương do hồi quy giải thích (SSR) và Tổng bình phương phần dư (RSS). Kiểm chứng hệ thức
. - Tính hệ số xác định
của mô hình và nêu ý nghĩa thực tiễn của con số này.
Lời giải chi tiết
1. Tính giá trị trung bình mẫu
2. Tính các thành phần tổng bình phương:
- Tổng biến thiên toàn phần (TSS):
\text{TSS} &= \sum_{i=1}^5 (y_i - \bar{y})^2 \ &= (2 - 5)^2 + (3 - 5)^2 + (5 - 5)^2 + (7 - 5)^2 + (8 - 5)^2 \ &= (-3)^2 + (-2)^2 + 0^2 + (+2)^2 + (+3)^2 \ &= 9 + 4 + 0 + 4 + 9 = 26.0 \end
\begin{aligned} \text{RSS} &= \sum_{i=1}^5 e_i^2 = \sum_{i=1}^5 (y_i - \hat{y}_i)^2 \ &= (+0.2)^2 + (-0.4)^2 + (0.0)^2 + (+0.4)^2 + (-0.2)^2 \ &= 0.04 + 0.16 + 0.00 + 0.16 + 0.04 = 0.40 \end
\begin{aligned} \text{SSR} &= \sum_{i=1}^5 (\hat{y}_i - \bar{y})^2 \ &= (1.8 - 5.0)^2 + (3.4 - 5.0)^2 + (5.0 - 5.0)^2 + (6.6 - 5.0)^2 + (8.2 - 5.0)^2 \ &= (-3.2)^2 + (-1.6)^2 + 0^2 + (+1.6)^2 + (+3.2)^2 \ &= 10.24 + 2.56 + 0.00 + 2.56 + 10.24 = 25.60 \end
Hệ thức phân rã phương sai hoàn toàn chính xác.
3. Tính hệ số xác định
- Công thức:
- Ý nghĩa thực tiễn: Mô hình hồi quy tuyến tính với biến thời gian ôn tập giải thích được tới
tổng biến thiên của điểm thi. Phần dư chưa giải thích được chỉ chiếm vỏn vẹn , chứng minh mô hình khớp rất tốt với dữ liệu quan sát.
Bài tập 2: Mô hình biến đổi logarit và độ co giãn trong kinh tế
Một nhà kinh tế học nghiên cứu mối liên hệ giữa tiền lương hàng tháng (
Yêu cầu:
- Hãy giải thích ý nghĩa kinh tế học của hệ số góc
đối với tốc độ tăng trưởng tiền lương khi người lao động tích lũy thêm một năm kinh nghiệm. - Dự báo mức lương hàng tháng của một người lao động có
năm kinh nghiệm và một người có năm kinh nghiệm (lấy giá trị làm tròn đến 2 chữ số thập phân). - Tại sao trong tài chính và kinh tế học, biến đổi logarit thường xuyên được áp dụng cho các biến số như thu nhập, giá cổ phiếu hay quy mô doanh số?
Lời giải chi tiết
1. Ý nghĩa kinh tế học của hệ số góc
- Lấy vi phân hai vế của phương trình
: - Khi số năm kinh nghiệm tăng thêm 1 năm (
), phần trăm thay đổi của tiền lương xấp xỉ bằng: - Kết luận: Cứ tích lũy thêm một năm kinh nghiệm làm việc, mức lương trung bình của người lao động tăng thêm khoảng
(tăng trưởng theo tỉ lệ phần trăm nhân tử thay vì một khoản tiền cố định).
2. Dự báo mức lương:
- Với người có
năm kinh nghiệm:
\ln(\hat{y}) &= 2.30 + 0.08(5) = 2.30 + 0.40 = 2.70 \ \hat{y} &= e^{2.70} \approx 14.88 \text{ million VND/month} \end
\begin{aligned} \ln(\hat{y}) &= 2.30 + 0.08(10) = 2.30 + 0.80 = 3.10 \ \hat{y} &= e^{3.10} \approx 22.20 \text{ million VND/month} \end
Bài tập 3: Cạm bẫy gia tăng
Một nhà phân tích dữ liệu đang cố gắng dự báo doanh thu của một chuỗi cửa hàng bán lẻ. Ban đầu, mô hình chỉ sử dụng biến diện tích mặt bằng (
Nhằm mục đích đẩy
Yêu cầu:
- Dưới góc độ toán học của phương pháp OLS, tại sao việc thêm các biến ngẫu nhiên vô nghĩa lại làm
tăng từ lên mà không bao giờ làm giảm ? - Mô hình có 11 biến với
có thực sự mang lại dự báo tốt hơn cho các cửa hàng mới mở trong năm tới so với mô hình ban đầu chỉ có 1 biến ( ) hay không? Giải thích rõ nguyên nhân. - Để khắc phục nhược điểm này của
, các nhà thống kê thường sử dụng chỉ số nào để phạt các mô hình lạm dụng quá nhiều biến số?
Lời giải chi tiết
1. Giải thích toán học về sự gia tăng của
- Phương pháp OLS tìm kiếm các hệ số
bằng cách giải bài toán tối thiểu hóa hàm tổng bình phương phần dư RSS trên không gian các hệ số. - Khi bổ sung thêm 10 biến số mới, không gian tìm kiếm tham số được mở rộng từ 2 chiều
lên 12 chiều . - Do tính biến thiên ngẫu nhiên trong mẫu quan sát hữu hạn, 10 biến số này sẽ có những mối tương quan ngẫu nhiên nhỏ tình cờ với biến doanh thu. Thuật toán OLS sẽ "chớp lấy" những tương quan ngẫu nhiên này để uốn nắn các hệ số nhằm ép nhỏ tổng bình phương phần dư
xuống thấp hơn một chút. - Vì
giảm trong khi không đổi, công thức bắt buộc phải tăng lên.
2. Đánh giá năng lực dự báo trong tương lai:
- Mô hình 11 biến chắc chắn sẽ dự báo tồi tệ hơn trên các cửa hàng mới mở trong tương lai!
- Nguyên nhân: Mức tăng
của hoàn toàn là "nhiễu ngẫu nhiên giả mạo" (Noise) chứ không phản ánh bất kỳ quy luật kinh tế thực sự nào. Khi triển khai mô hình sang các cửa hàng mới trong tương lai, những tương quan ngẫu nhiên từ việc gieo xúc xắc sẽ không còn đúng nữa, khiến các giá trị dự báo bị sai lệch trầm trọng. Đây chính là biểu hiện kinh điển của hiện tượng quá khớp (Overfitting).
3. Giải pháp thay thế: Hệ số xác định hiệu chỉnh (Adjusted
- Để ngăn ngừa việc lạm dụng thêm biến số vô tội vạ, các nhà thống kê sử dụng
hiệu chỉnh ( ): - Trong đó
là cỡ mẫu và là số lượng biến dự báo. Khi đưa thêm một biến mới vào mô hình ( tăng), mẫu số bị thu hẹp lại, tạo ra một khoản "tiền phạt". Nếu biến mới không giúp giảm đủ nhiều để bù đắp cho khoản phạt này, giá trị sẽ lập tức sụt giảm, cảnh báo nhà phân tích rằng biến số đó là thừa thãi.