Giao diện
1. Giới thiệu: Ba cấp độ khẳng định tri thức trong khoa học dữ liệu
Trong toàn bộ tiến trình phân tích dữ liệu, câu hỏi mà chúng ta đặt ra cho thế giới thường được chia thành ba cấp độ tăng dần về độ sâu và mức độ phức tạp:
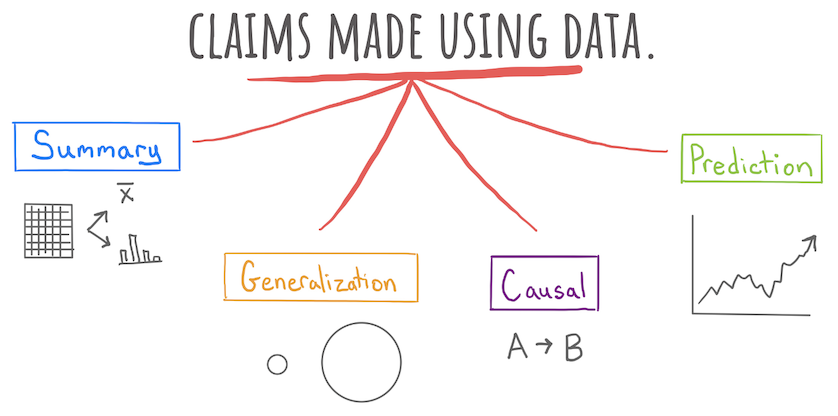 Hình 21.1: Ba tầng bậc khẳng định trong khoa học dữ liệu: Khẳng định mô tả, khẳng định suy rộng và khẳng định nhân quả.
- Khẳng định mô tả (Descriptive Claim): Trả lời câu hỏi: “Dữ liệu chúng ta đang nắm giữ mang những đặc điểm gì?” (Ví dụ: Tỉ lệ sinh viên có việc làm sau tốt nghiệp trong mẫu khảo sát là
). - Khẳng định suy rộng (Generalization Claim): Trả lời câu hỏi: “Đặc điểm của mẫu dữ liệu này có thể mở rộng cho toàn bộ tổng thể hay không?” (Ví dụ: Với độ tin cậy
, khoảng từ đến sinh viên toàn trường sẽ tìm được việc làm). - Khẳng định nhân quả (): Trả lời câu hỏi sâu sắc nhất: “Liệu sự thay đổi ở biến số giải thích
có trực tiếp tạo ra sự biến đổi ở biến kết cục hay không?” (Ví dụ: Liệu tấm bằng đại học có phải là nguyên nhân trực tiếp giúp sinh viên tìm được việc làm tốt, hay những người tìm được việc tốt vốn dĩ đã có năng lực xuất sắc từ trước?).
Trong đời sống thường nhật, chúng ta sử dụng ngôn ngữ nhân quả liên tục: “Tôi uống một viên thuốc giảm đau và cơn đau đầu đã thuyên giảm”, “Nhờ có bằng đại học danh tiếng, cô ấy mới ứng tuyển thành công vào tập đoàn đa quốc gia”. Tuy nhiên, làm thế nào để chúng ta định nghĩa một cách chặt chẽ và toán học khái niệm nguyên nhân và kết quả?
2. Thử nghiệm tư duy: Ai đã gây ra cái chết của tù nhân?
Để thấy rõ sự phức tạp khi phân định ranh giới nhân quả, hãy cùng xem xét một tình huống thực nghiệm tư duy kinh điển được nhà khoa học máy tính Judea Pearl đưa ra:
Kịch bản: Một tù nhân bị kết án tử hình trước đội hành quyết. Để việc thi hành án diễn ra, một chuỗi sự kiện bắt buộc phải xảy ra theo đúng quy trình:
- Đầu tiên, quan tòa ban hành lệnh hành quyết.
- Lệnh hành quyết được chuyển tới đại úy chỉ huy. Đại úy phát tín hiệu lệnh bắn tới hai người lính trong đội hành quyết (Lính 1 và Lính 2).
- Cả hai người lính đều là những xạ thủ thiện xạ và tuyệt đối tuân lệnh: Họ chỉ nổ súng khi có hiệu lệnh từ đại úy, và chỉ cần một trong hai người bắn trúng, tù nhân chắc chắn sẽ tử vong.
Thực tế diễn ra: Quan tòa ra lệnh, đại úy phát tín hiệu, cả hai người lính cùng bóp cò đồng thời và tù nhân tử vong.
Câu hỏi: Ai là nguyên nhân thực sự gây ra cái chết của tù nhân?
- A. Quan tòa
- B. Đại úy chỉ huy
- C. Người lính số 1
- D. Người lính số 2
Nếu nhìn theo trực giác cảm tính, ta có thể nghĩ cả bốn người đều có phần trách nhiệm. Nhưng nếu phân tích theo chuỗi logic nghiêm ngặt, ranh giới nhân quả sẽ phụ thuộc hoàn toàn vào cách ta định nghĩa: Một hành động được coi là nguyên nhân khi nào?
3. Định nghĩa nhân quả phản thực tế có điều kiện (Conditional Counterfactual)
Khái niệm nhân quả hiện đại trong khoa học bắt nguồn từ một trực giác logic sâu sắc: So sánh thế giới thực tế với một thế giới giả định chưa từng xảy ra.
Nguồn gốc sớm nhất của lối tư duy này xuất hiện trong trước tác của nhà sử học Hy Lạp cổ đại Thucydides khi ông ghi chép về trận sóng thần tàn phá thị trấn Orobiae sau một cơn địa chấn dữ dội:
“Nguyên nhân của hiện tượng này, theo tôi, phải bắt nguồn từ chính trận động đất. Tại nơi chấn động mạnh nhất, nước biển bị đẩy lùi rồi đột ngột ập trở lại với sức mạnh gấp bội, gây nên trận ngập lụt kinh hoàng. Nếu không có trận động đất, tôi không thấy làm sao một tai họa như vậy có thể xảy ra.”
Nhiều thế kỷ sau, triết gia Scotland David Hume đã đúc kết nguyên lý này thành một định nghĩa triết học bất hủ:
“Một vật là nguyên nhân của vật khác khi: Nếu vật thứ nhất không tồn tại, vật thứ hai sẽ không bao giờ xuất hiện.”
Cả hai phát biểu trên đều dựa vào việc tưởng tượng một thế giới trái ngược với thực tế khách quan đã diễn ra. Trong logic học và thống kê học, khái niệm này được gọi là sự kiện phản thực tế (Counterfactual).
Định nghĩa Phản thực tế (Counterfactual)
- Khái niệm: Là mệnh đề hoặc kịch bản mô tả những gì đã không xảy ra trong thế giới thực, hoặc trái ngược với dữ kiện thực tế.
Định nghĩa Nguyên nhân (Causality)
- Quy chuẩn: Ta khẳng định “Biến cố
gây ra biến cố ” nếu và chỉ nếu: Trong một thế giới song song nơi biến cố không xảy ra, thì biến cố cũng sẽ không xảy ra.
Áp dụng định nghĩa này để giải mã bài toán đội hành quyết ở trên:
- Xét quan tòa: Nếu quan tòa không ra lệnh, đại úy sẽ không phát lệnh, hai người lính không bắn, và tù nhân vẫn còn sống. Do đó, quan tòa là nguyên nhân gây ra cái chết của tù nhân.
- Xét đại úy: Nếu đại úy không phát tín hiệu, hai người lính không nổ súng và tù nhân vẫn còn sống. Do đó, đại úy là nguyên nhân gây ra cái chết của tù nhân.
- Xét người lính số 1: Giả sử lính số 1 không bắn súng. Vì lính số 2 vẫn nhận lệnh và bắn trúng đích độc lập, tù nhân vẫn tử vong! Như vậy, việc lính số 1 không bắn không làm thay đổi kết cục của tù nhân. Theo định nghĩa phản thực tế có điều kiện, xét trên phương diện cá nhân độc lập, lính số 1 không phải là nguyên nhân quyết định duy nhất. Lập luận tương tự áp dụng cho lính số 2.
Đó chính là lý do các đội hành quyết trong lịch sử quân sự thường bố trí nhiều xạ thủ: Nó tạo ra sự dư thừa hỏa lực nhằm triệt tiêu vai trò nguyên nhân trực tiếp mang tính cá nhân, giúp giảm bớt gánh nặng tâm lý cho từng người lính.
4. Thách thức căn bản của suy luận nhân quả
Nhà khoa học máy tính Judea Pearl từng phát biểu một nhận định sâu sắc:
“Counterfactuals have a particularly problematic relationship with data because data are, by definition, facts.”(Các sự kiện phản thực tế có mối quan hệ đầy nghịch lý với dữ liệu, bởi lẽ dữ liệu theo đúng định nghĩa là những sự thật đã diễn ra.)
Từ nguyên của từ “datum” trong tiếng Latinh mang ý nghĩa là “một điều đã xảy ra, một sự thật”. Ngược lại, “counterfactual” có nghĩa là “trái với sự thật”. Để chứng minh tuyệt đối một mối quan hệ nhân quả trên một cá thể, ta buộc phải quan sát được đồng thời hai điều:
- Dữ liệu thực tế diễn ra khi cá thể đó nhận can thiệp.
- Dữ liệu phản thực tế diễn ra khi chính cá thể đó không nhận can thiệp trong cùng một điều kiện hoàn cảnh.
Bảng dữ liệu hai thế giới lý tưởng
Hãy hình dung trong một thế giới song song lý tưởng, để kiểm tra xem liệu việc tốt nghiệp đại học danh tiếng (biến can thiệp
| Cá thể | Tốt nghiệp đại học ( | Có việc làm tốt ( | Bản chất quan sát |
|---|---|---|---|
| An | Có ( | Có ( | Thế giới thực tế đã diễn ra |
| An | Không ( | Không ( | Thế giới phản thực tế (chưa từng xảy ra) |
Trong bảng dữ liệu lý tưởng này, hai dòng quan sát thuộc về cùng một người: Có cùng chỉ số IQ, cùng tính cách, cùng hoàn cảnh gia đình, cùng năng lực ban đầu. Sự khác biệt duy nhất là một phiên bản của An đi học đại học, còn phiên bản kia thì không. Khi kết cục việc làm thay đổi giữa hai phiên bản, ta có bằng chứng đanh thép
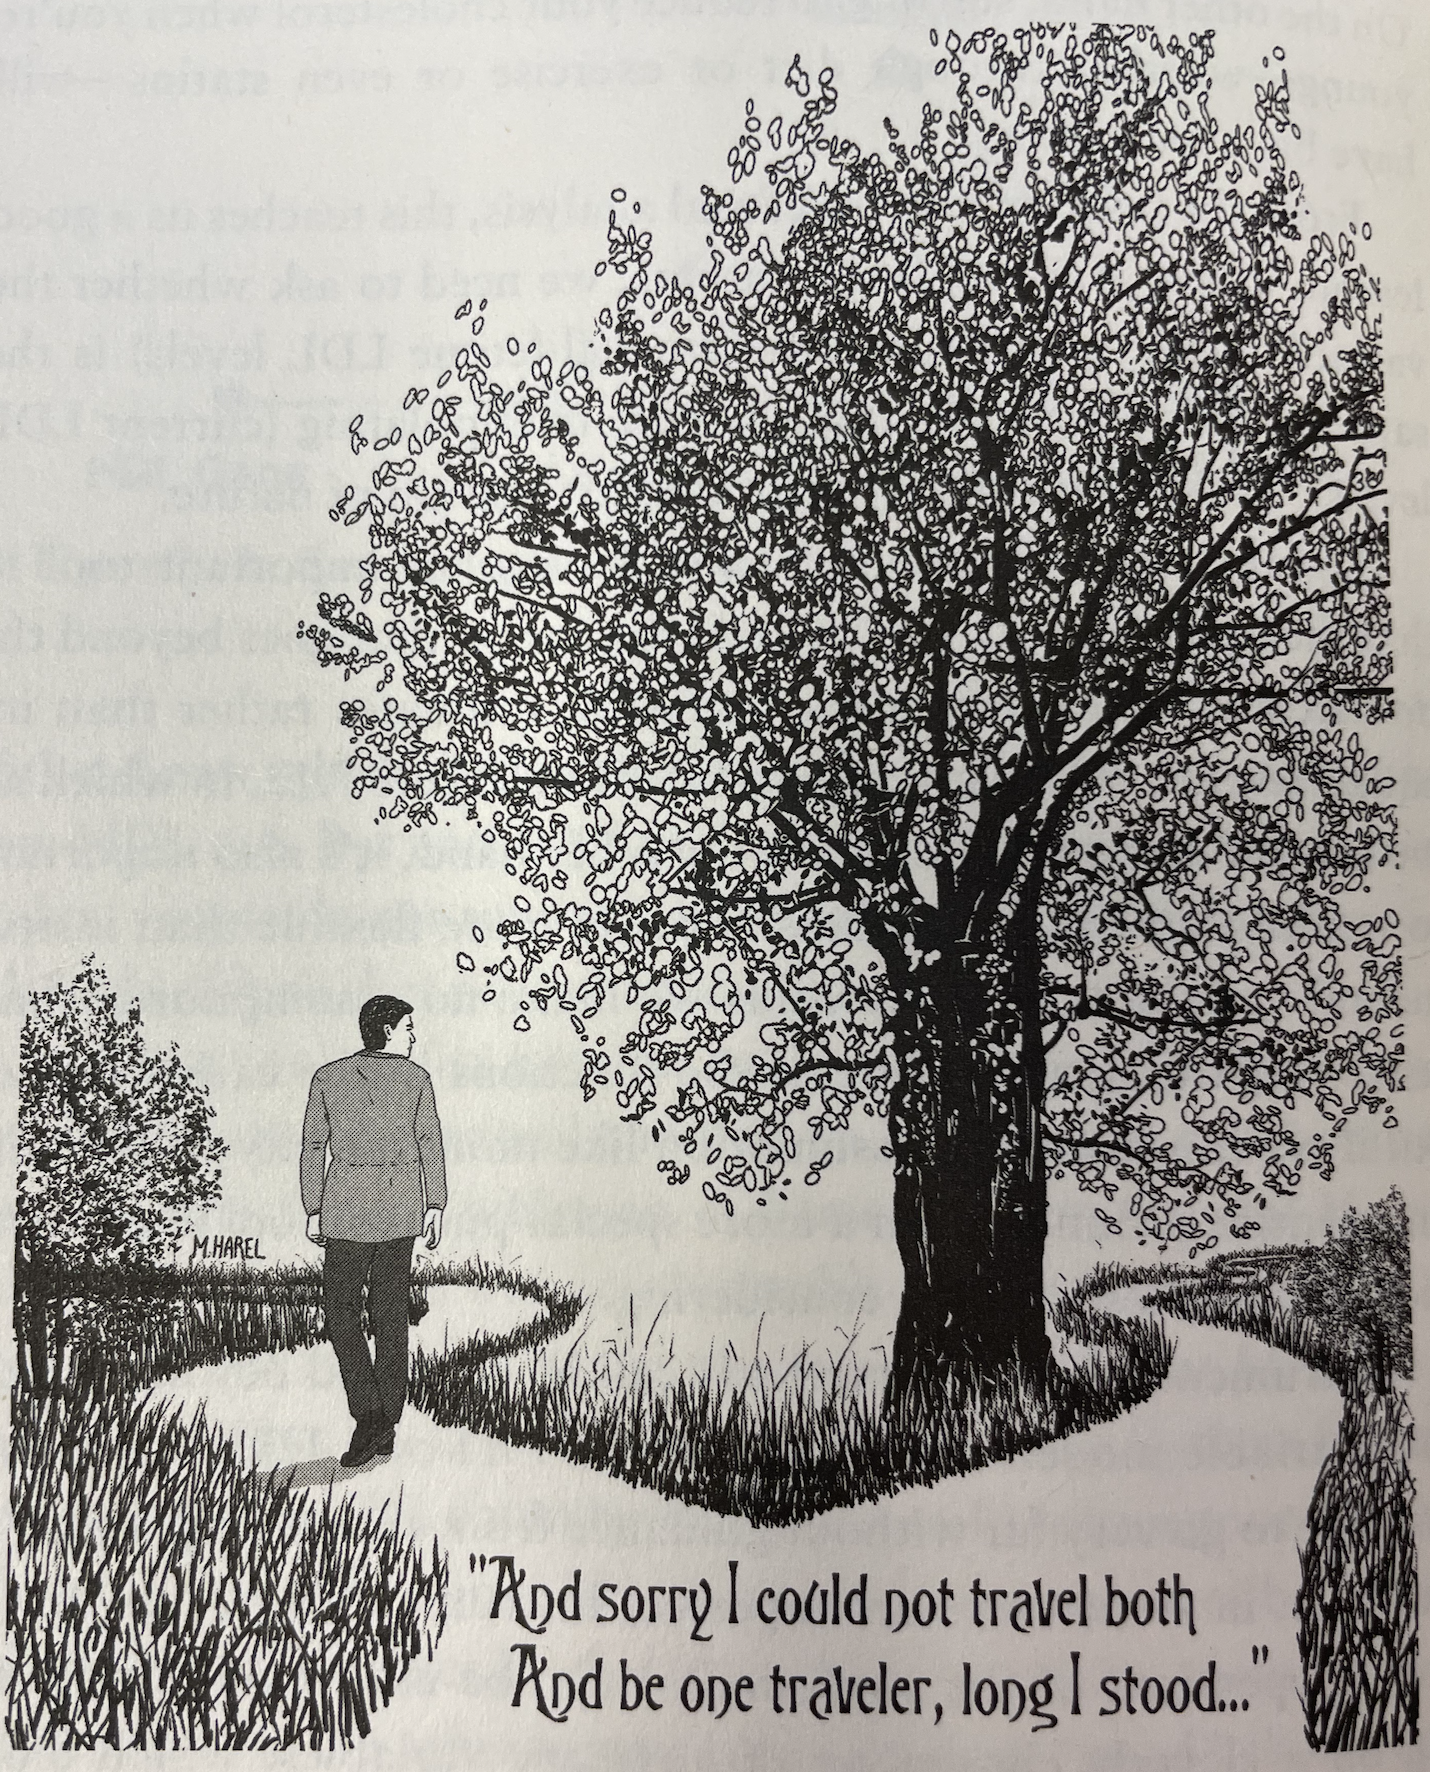 Hình 21.2: Minh họa tác phẩm "The Road Not Taken" của Robert Frost. Khi một cá thể đã chọn bước đi trên một ngả đường, ngả đường còn lại vĩnh viễn trở thành miền phản thực tế không thể quan sát.
Mô hình kết quả tiềm năng (Potential Outcomes Framework)
Được phát triển bởi nhà thống kê học Donald Rubin, mô hình kết quả tiềm năng định nghĩa:
- Với mỗi cá thể
, tồn tại hai kết quả tiềm năng: : Kết cục của cá thể nếu nhận can thiệp ( ). : Kết cục của cá thể nếu không nhận can thiệp ( ).
- Hiệu ứng can thiệp cá thể (Individual Treatment Effect - ITE):
Bài toán cơ bản của suy luận nhân quả (Fundamental Problem of Causal Inference):
Với mỗi cá thể
Kết quả tiềm năng còn lại
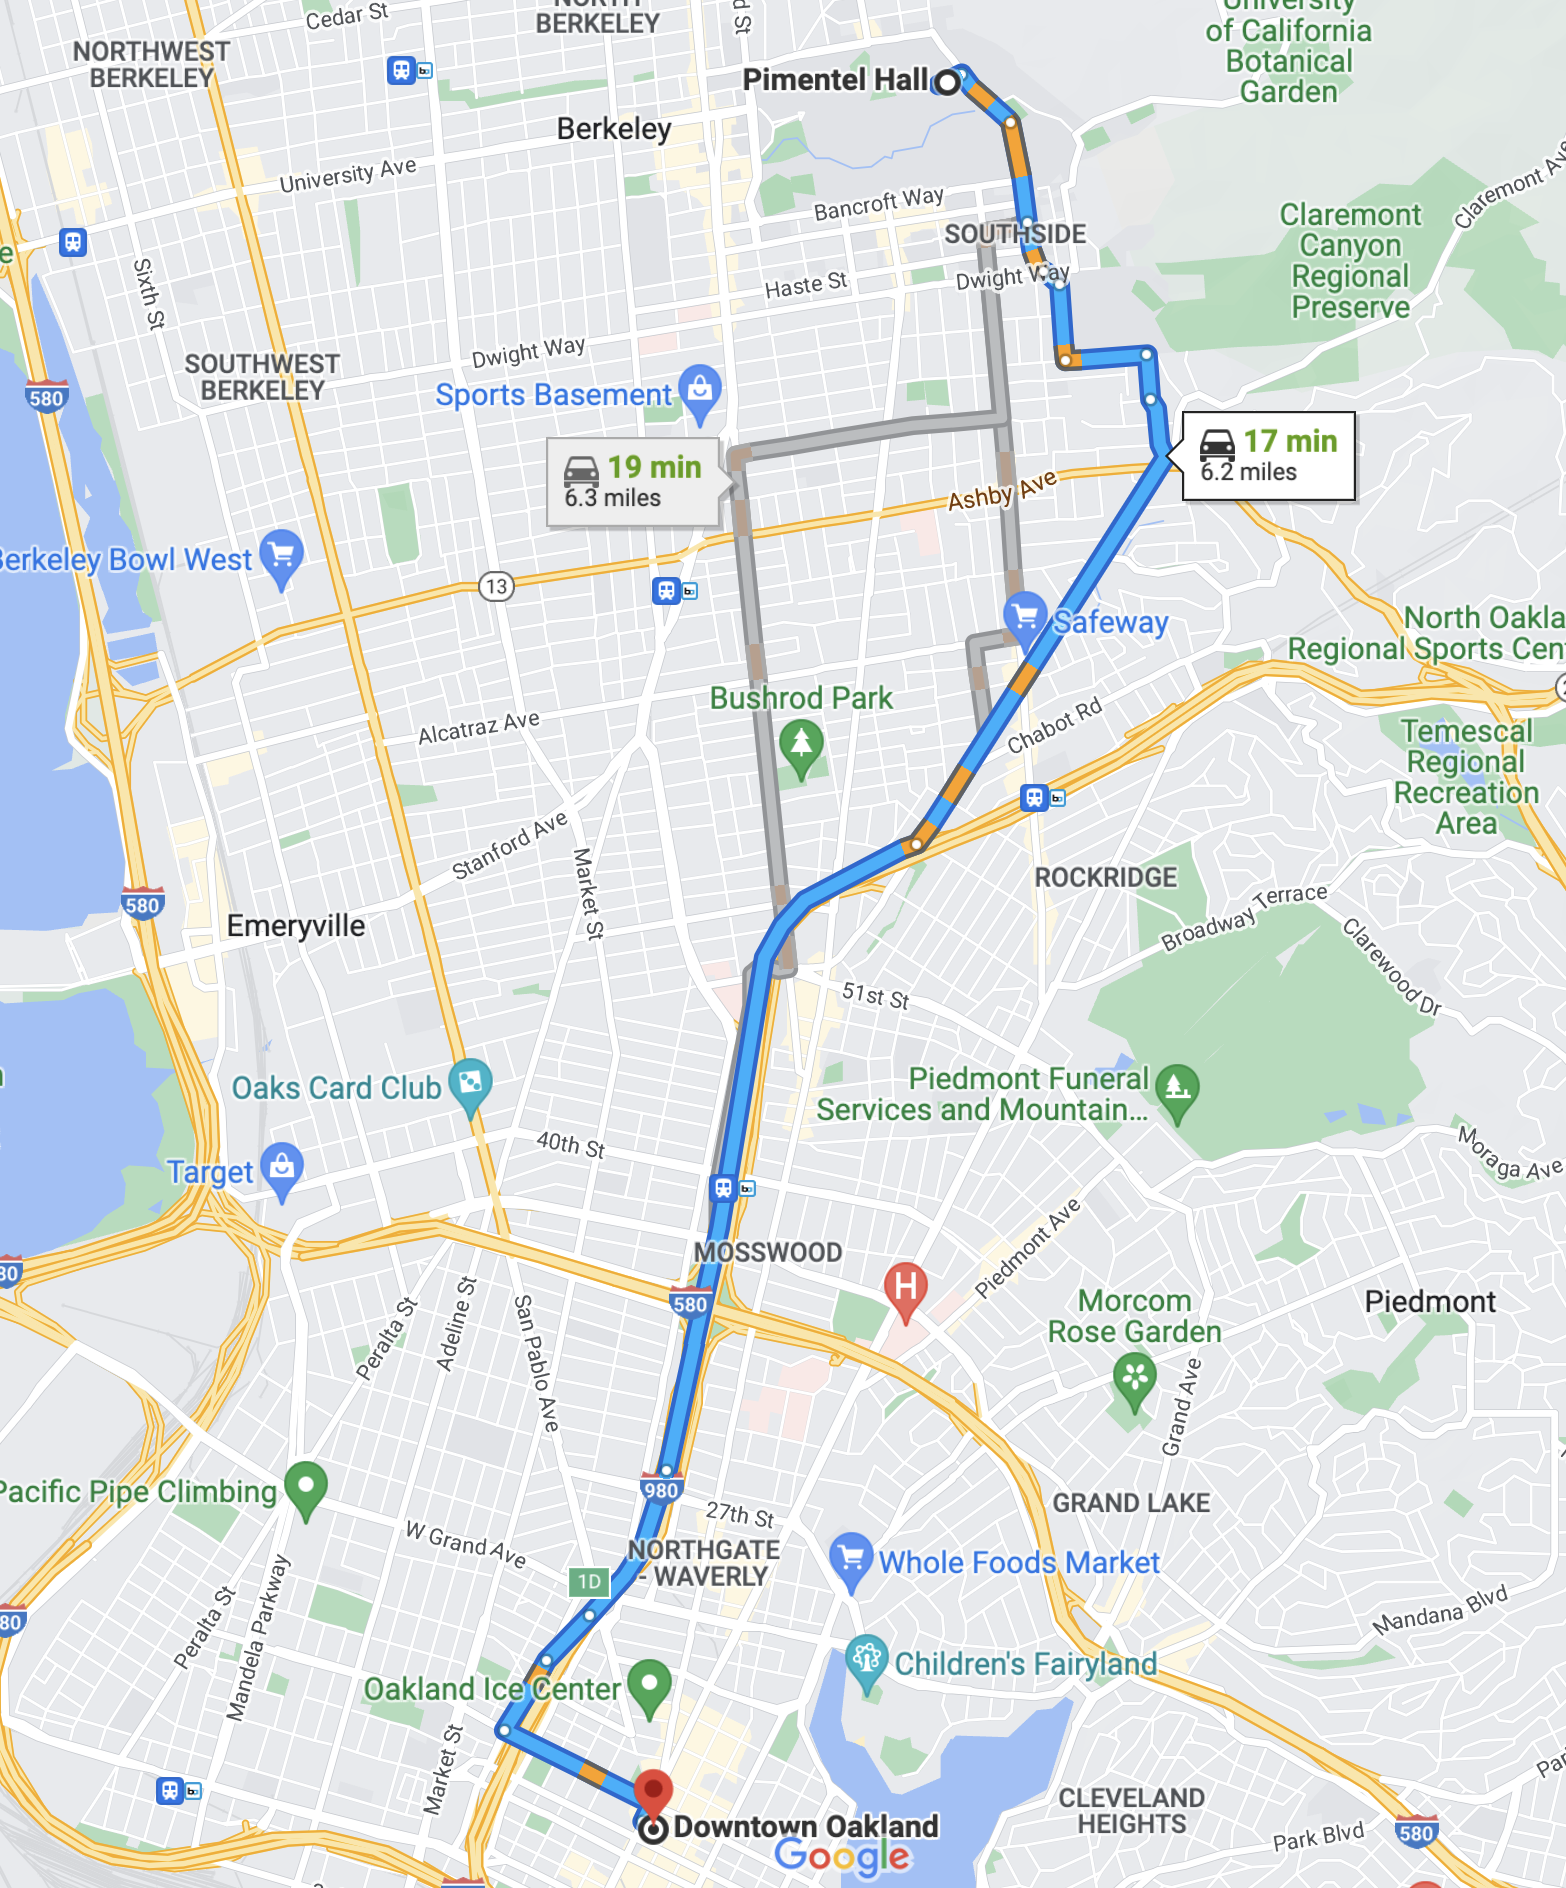 Hình 21.3: Ba lộ trình tiềm năng trên ứng dụng bản đồ Google Maps. Ứng dụng dự báo các kết quả tiềm năng (16 phút, 19 phút, 20 phút), nhưng khi bạn chọn tuyến đường 16 phút, bạn không bao giờ thu thập được dữ liệu thực tế của hai tuyến đường còn lại.
5. Từ cấp độ cá thể đến cấp độ quần thể: Hiệu ứng can thiệp trung bình (ATE)
Vì không thể quay ngược thời gian để quan sát cả hai trạng thái trên cùng một người, các nhà khoa học chuyển dịch mục tiêu: Thay vì tìm kiếm hiệu ứng nhân quả trên từng cá thể riêng biệt, ta ước lượng Hiệu ứng can thiệp trung bình (Average Treatment Effect - ATE) trên một nhóm hoặc toàn bộ quần thể.
Định nghĩa Hiệu ứng can thiệp trung bình (ATE)
- Khái niệm: Là kỳ vọng toán học của hiệu ứng can thiệp trên toàn bộ các cá thể trong quần thể:
Phát biểu cấp độ quần thể chuyển trọng tâm từ một cá nhân sang quy luật chung:
- Phát biểu cá thể: “An tìm được việc làm tốt vì bạn ấy tốt nghiệp đại học.” (Không thể kiểm chứng trực tiếp).
- Phát biểu quần thể: “Việc tốt nghiệp đại học trung bình giúp nâng cao xác suất tìm kiếm việc làm tốt cho các ứng viên.” (Có thể kiểm chứng được thông qua ATE).
Ví dụ minh họa ước lượng ATE trên mẫu 6 sinh viên
Xét dữ liệu của 6 sinh viên, trong đó 3 người tốt nghiệp đại học (
| Sinh viên | Tốt nghiệp đại học ( | Có việc làm tốt ( |
|---|---|---|
| An | Có ( | Có ( |
| Bình | Có ( | Không ( |
| Chi | Có ( | Có ( |
| Dũng | Không ( | Không ( |
| Hà | Không ( | Không ( |
| Linh | Không ( | Có ( |
Từ bảng dữ liệu quan sát này, ta tính tỉ lệ có việc làm tốt ở mỗi nhóm:
- Tỉ lệ ở nhóm tốt nghiệp:
( ). - Tỉ lệ ở nhóm không tốt nghiệp:
( ).
Ước lượng tự nhiên cho hiệu ứng can thiệp trung bình là chênh lệch tỉ lệ mẫu:
Con số
6. Cạm bẫy so sánh ngây thơ và Thiên lệch lựa chọn (Selection Bias)
Một ước lượng chênh lệch trung bình đơn thuần chỉ trở thành bằng chứng nhân quả đáng tin cậy nếu hai nhóm so sánh thực sự tương đồng về mọi mặt ngoại trừ biến can thiệp. Nếu hai nhóm có sự khác biệt sẵn có ngay từ đầu, ước lượng sẽ bị bóp méo nghiêm trọng.
Hãy xem xét một ví dụ thực tế đầy kịch tính về việc lựa chọn phương tiện di chuyển từ Berkeley sang San Francisco giữa hai lựa chọn: Đi tàu điện ngầm (BART) hoặc tự lái xe hơi.
Thế giới giả định: Khi ta biết trọn vẹn cả hai kết quả tiềm năng
Giả sử trong một thế giới toàn tri, ta biết chính xác thời gian di chuyển (phút) của 4 hành khách dưới cả hai phương án:
| Hành khách | Thời gian đi Xe hơi | Thời gian đi Tàu điện | Hiệu ứng cá thể |
|---|---|---|---|
| Maria | 35 | 28 | |
| Phan | 30 | 32 | |
| An | 40 | 55 | |
| Minh | 30 | 40 |
Từ bảng số liệu toàn tri này, ta tính toán các giá trị kỳ vọng thực sự:
- Thời gian trung bình nếu tất cả cùng đi tàu điện:
- Thời gian trung bình nếu tất cả cùng đi xe hơi:
- Hiệu ứng can thiệp trung bình thực sự (True ATE):
Kết luận khách quan: Trung bình trên 4 người này, việc đi tàu điện ngầm làm thời gian di chuyển tăng thêm 5 phút so với lái xe hơi.
Thế giới thực tế: Khi hành khách tự do lựa chọn phương tiện
Trong đời sống thực tế, con người luôn hành động có chủ đích:
- Maria và Phan sống ngay cạnh ga tàu điện, nên họ quyết định đi tàu điện.
- An và Minh sống xa ga tàu nhưng nhà gần đường cao tốc, nên họ chọn lái xe hơi.
Dữ liệu thực tế mà nhà phân tích thu thập được trong bảng khảo sát sẽ bị khuyết thiếu các giá trị phản thực tế:
| Hành khách | Thời gian đi Xe hơi quan sát | Thời gian đi Tàu điện quan sát | Phương tiện lựa chọn |
|---|---|---|---|
| Maria | ? (Phản thực tế) | 28 | Tàu điện |
| Phan | ? (Phản thực tế) | 32 | Tàu điện |
| An | 40 | ? (Phản thực tế) | Xe hơi |
| Minh | 30 | ? (Phản thực tế) | Xe hơi |
Nếu một nhà phân tích thiếu kinh nghiệm thực hiện so sánh ngây thơ (Naive Comparison) giữa hai nhóm:
- Thời gian trung bình của nhóm đi tàu điện:
. - Thời gian trung bình của nhóm lái xe hơi:
. - Ước lượng ngây thơ thu được:
Sự đảo ngược đáng kinh ngạc của dấu hiệu ứng:
- Hiệu ứng nhân quả thực sự:
phút (Tàu điện làm chậm hơn 5 phút). - Ước lượng từ dữ liệu quan sát ngây thơ:
phút (Tàu điện làm nhanh hơn 5 phút!).
Dấu của hiệu ứng đã bị đảo ngược hoàn toàn
7. Tóm tắt bài học
- Mối quan hệ nhân quả được định nghĩa thông qua mệnh đề phản thực tế có điều kiện:
gây ra nếu trong một thế giới giả định nơi không xảy ra, thì cũng sẽ không xảy ra. - Bài toán cơ bản của suy luận nhân quả: Ta chỉ có thể quan sát được một trong hai kết quả tiềm năng
hoặc cho mỗi cá thể. Hiệu ứng can thiệp cá thể là đại lượng vĩnh viễn không thể quan sát đồng thời. - Để vượt qua rào cản này, khoa học dữ liệu tập trung vào ước lượng Hiệu ứng can thiệp trung bình (ATE) trên quy mô quần thể.
- Việc lấy hiệu số trung bình ngây thơ trên dữ liệu quan sát tự nhiên thường dẫn đến kết luận sai lệch nghiêm trọng do sự xuất hiện của thiên lệch lựa chọn và các biến gây nhiễu.
- Để ước lượng ATE một cách chuẩn xác, ta cần những phương pháp thiết kế nghiên cứu đặc thù: Thử nghiệm ngẫu nhiên có đối chứng (Randomized Experiments) hoặc các kỹ thuật ghép cặp (Matching) trong nghiên cứu quan sát.
Tài liệu tham khảo
- Pearl, J., & Mackenzie, D. (2018). The Book of Why: The New Science of Cause and Effect. Basic Books.
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701.
- Holland, P. W. (1986). Statistics and causal inference. Journal of the American Statistical Association, 81(396), 945–960.
- Hume, D. (1748). An Enquiry Concerning Human Understanding. A. Millar, London.
Bài tập tự luyện
Bài tập 1: Đồ thị nhân quả và phân tích phản thực tế
Xét tình huống đội hành quyết được mô tả trong bài giảng:
- Quan tòa (
) ra lệnh hành quyết ( ). - Đại úy (
) tiếp nhận lệnh và ra hiệu lệnh bắn ( ). - Hai người lính độc lập (
và ) nổ súng ( ). - Tù nhân tử vong (
) nếu hoặc .
Yêu cầu:
- Hãy vẽ sơ đồ quan hệ nhân quả (Causal Graph) biểu diễn dòng tác động từ quan tòa đến cái chết của tù nhân.
- Áp dụng định nghĩa phản thực tế có điều kiện: Hãy giải thích tại sao xét trên phương diện từng cá nhân độc lập, việc lính số 1 nổ súng không thỏa mãn định nghĩa là nguyên nhân duy nhất gây ra cái chết của tù nhân.
- Giả sử người lính số 2 bị kẹt đạn nên súng không nổ (
). Trong tình huống mới này, hành động của người lính số 1 có trở thành nguyên nhân gây ra cái chết của tù nhân theo định nghĩa phản thực tế hay không? Hãy lập luận chặt chẽ.
Lời giải chi tiết
1. Sơ đồ quan hệ nhân quả:
- Quan hệ nhân quả có thể biểu diễn qua đồ thị có hướng (Directed Acyclic Graph - DAG) như sau:
- Giải thích:
- Nút
(Quan tòa) truyền tín hiệu trực tiếp đến nút (Đại úy): . - Nút
truyền tín hiệu song song đến hai nút và : Quy tắc và . - Hai nút
và cùng hội tụ về nút kết cục (Tử vong): (hàm logic OR).
- Nút
2. Phân tích phản thực tế của người lính số 1 trong tình huống ban đầu:
- Theo định nghĩa phản thực tế có điều kiện: Hành động nổ súng của lính số 1 (
) là nguyên nhân gây ra cái chết của tù nhân ( ) nếu trong một thế giới giả định nơi lính số 1 không nổ súng ( ), tù nhân sẽ không tử vong ( ). - Tuy nhiên, trong kịch bản ban đầu, đại úy đã phát tín hiệu (
) nên lính số 2 cũng nổ súng ( ). - Khi xét thế giới phản thực tế nơi lính số 1 không bắn (
), vì lính số 2 vẫn bắn trúng đích ( ), kết cục của tù nhân vẫn là tử vong ( ). - Vì kết cục của tù nhân không thay đổi khi lính số 1 rút lại hành động, xét theo định nghĩa phản thực tế thuần túy, hành động của riêng lính số 1 không phải là nguyên nhân quyết định duy nhất gây ra cái chết của tù nhân.
3. Phân tích tình huống khi súng lính số 2 bị kẹt đạn (
- Trong kịch bản này, trạng thái của hệ thống là
. Kết cục tử vong của tù nhân hoàn toàn phụ thuộc vào lính số 1: . - Thực tế diễn ra: Lính số 1 nổ súng (
) và tù nhân tử vong ( ). - Xét thế giới phản thực tế: Nếu lính số 1 không nổ súng (
), vì súng lính số 2 bị kẹt ( ), không có phát đạn nào bắn ra, nên tù nhân sẽ không tử vong ( ). - Kết luận: Khi súng của lính số 2 bị kẹt, hành động của lính số 1 trở thành nguyên nhân trực tiếp gây ra cái chết của tù nhân theo đúng định nghĩa phản thực tế có điều kiện.
Bài tập 2: Mô hình kết quả tiềm năng và Đảo ngược dấu hiệu ứng
Một công ty công nghệ thử nghiệm hai giao diện thanh toán: Giao diện A (truyền thống,
| Khách hàng | ||
|---|---|---|
| Khách hàng 1 | 45 | 30 |
| Khách hàng 2 | 50 | 40 |
| Khách hàng 3 | 60 | 55 |
| Khách hàng 4 | 70 | 65 |
Yêu cầu:
- Hãy tính hiệu ứng can thiệp cá thể
cho từng khách hàng và tính Hiệu ứng can thiệp trung bình thực sự ( ) của việc chuyển từ giao diện A sang giao diện B. Giao diện B giúp tiết kiệm thời gian trung bình bao nhiêu giây? - Giả sử trong thực tế, khách hàng tự do lựa chọn giao diện: Khách hàng 1 và 2 (vốn am hiểu công nghệ) chọn giao diện B, trong khi Khách hàng 3 và 4 (người lớn tuổi, ít dùng ứng dụng) chọn giao diện A. Hãy lập bảng dữ liệu quan sát thực tế và tính toán ước lượng hiệu ứng can thiệp ngây thơ
. - So sánh giá trị ước lượng ngây thơ với ATE thực sự và giải thích nguyên nhân gây ra sự sai lệch.
Lời giải chi tiết
1. Tính hiệu ứng can thiệp cá thể và ATE thực sự:
- Hiệu ứng cá thể cho từng khách hàng:
giây. giây. giây. giây.
- Hiệu ứng can thiệp trung bình thực sự:
- Hoặc tính thông qua kỳ vọng:
\mathbb{E}[Y(1)] &= \frac{30 + 40 + 55 + 65}{4} = \frac{190}{4} = 47.5 \text{ s} \ \mathbb{E}[Y(0)] &= \frac{45 + 50 + 60 + 70}{4} = \frac{225}{4} = 56.25 \text{ s} \ \text{ATE} &= 47.5 - 56.25 = -8.75 \text{ s} \end
- Thời gian trung bình quan sát được ở nhóm dùng giao diện A:
- Ước lượng ngây thơ:
3. So sánh và giải thích sai lệch:
- So sánh: Ước lượng ngây thơ cho rằng giao diện B giúp tiết kiệm tới
giây, trong khi hiệu ứng thực sự chỉ là giây (bị phóng đại lên gấp hơn 3.4 lần!). - Giải thích: Sai lệch này xuất phát từ Thiên lệch lựa chọn (Selection Bias). Nhóm chọn giao diện B vốn là những người am hiểu công nghệ, thao tác điện thoại rất nhanh ngay từ đầu (nếu dùng giao diện A thì họ cũng chỉ mất trung bình 47.5 giây). Ngược lại, nhóm chọn giao diện A là người lớn tuổi thao tác chậm chạp (mất trung bình 65 giây). Sự khác biệt ban đầu về kỹ năng công nghệ giữa hai nhóm đã hòa lẫn vào hiệu ứng của giao diện, khiến phép so sánh ngây thơ bị bóp méo nghiêm trọng.
Bài tập 3: Thiên lệch lựa chọn trong chương trình đào tạo nghề
Một nghiên cứu xã hội học muốn đánh giá tác động của một khóa đào tạo kỹ năng lập trình miễn phí kéo dài 6 tháng (
Nghiên cứu thu thập dữ liệu quan sát từ 200 thanh niên, trong đó 100 người tự nguyện đăng ký tham gia khóa học (
- Nhóm tham gia khóa học có mức lương trung bình là 18 triệu VNĐ/tháng.
- Nhóm không tham gia có mức lương trung bình là 11 triệu VNĐ/tháng.
- Nhóm nghiên cứu tuyên bố: “Khóa học kỹ năng lập trình là nguyên nhân trực tiếp làm tăng mức lương của thanh niên thêm 7 triệu VNĐ/tháng.”
Yêu cầu:
- Hãy chỉ ra ít nhất hai yếu tố biến gây nhiễu tiềm ẩn có thể dẫn tới thiên lệch lựa chọn trong nghiên cứu quan sát này.
- Dưới góc độ của mô hình kết quả tiềm năng, tại sao việc nhóm thanh niên tự nguyện đăng ký tham gia khóa học lại vi phạm giả định cần thiết để phép so sánh hiệu số trung bình phản ánh đúng ATE?
- Để có thể đưa ra không bị thiên lệch, các nhà nghiên cứu cần thiết kế lại quy trình phân bổ học viên vào khóa học như thế nào?
Lời giải chi tiết
1. Các biến gây nhiễu tiềm ẩn:
- Động lực học tập và tính kiên trì: Những thanh niên chủ động nộp đơn đăng ký một khóa học khó khăn kéo dài 6 tháng thường là những người có ý chí tự giác, ham học hỏi và quyết tâm cải thiện cuộc sống cao hơn. Ngay cả khi không tham gia khóa học này, phẩm chất cá nhân đó cũng sẽ giúp họ tìm được những công việc có thu nhập tốt hơn.
- Năng lực tư duy logic ban đầu: Những người quan tâm đến lập trình thường đã có thiên hướng hoặc nền tảng tư duy toán học và logic tốt hơn mức trung bình, giúp họ có lợi thế cạnh tranh tự nhiên trên thị trường lao động.
2. Vi phạm giả định của mô hình kết quả tiềm năng:
- Trong mô hình kết quả tiềm năng, để hiệu số trung bình quan sát
ước lượng không chệch cho , ta cần giả định hai nhóm có kết quả tiềm năng cơ bản như nhau nếu cùng ở trạng thái không can thiệp, tức là: - Do thanh niên tự nguyện lựa chọn (
), nhóm tham gia ( ) có mức kỳ vọng cơ sở cao hơn hẳn nhóm không tham gia (họ có ý chí và năng lực tốt hơn, nên nếu không học khóa này họ vẫn kiếm được mức lương cao hơn nhóm ). - Sự chênh lệch ban đầu này (gọi là Thiên lệch lựa chọn - Selection Bias) đã cộng dồn vào hiệu ứng thực của khóa học, làm phóng đại con số chênh lệch lên 7 triệu VNĐ/tháng.
3. Thiết kế lại nghiên cứu chuẩn mực:
- Để triệt tiêu thiên lệch lựa chọn, các nhà nghiên cứu cần triển khai một Thử nghiệm ngẫu nhiên có đối chứng (Randomized Controlled Trial - RCT):
- Bước 1: Tuyển mộ một danh sách gồm các ứng viên có nguyện vọng học.
- Bước 2: Sử dụng quy trình bốc thăm ngẫu nhiên (hoặc thuật toán sinh số ngẫu nhiên) để chia danh sách ứng viên thành hai nhóm:
- Nhóm can thiệp (
): Được nhận vào học khóa đào tạo miễn phí. - Nhóm đối chứng (
): Được đưa vào danh sách chờ và chưa tham gia khóa học trong giai đoạn này.
- Nhóm can thiệp (
- Khi phân nhóm hoàn toàn ngẫu nhiên, các yếu tố về động lực, chỉ số thông minh hay hoàn cảnh gia đình sẽ được phân bổ đồng đều giữa hai nhóm, triệt tiêu thiên lệch lựa chọn và đảm bảo chênh lệch mức lương trung bình sau khóa học phản ánh chính xác hiệu ứng nhân quả ATE.