Giao diện
Dẫn nhập: Bước đi ngẫu nhiên của người say rượu
Hãy tưởng tượng một vị khách quen vừa bước ra khỏi quán rượu sau một đêm tiệc tùng. Khi quán đóng cửa, người này tìm đường trở về nhà. Ngôi nhà thực ra rất gần, nằm ngay trên con đường thẳng tắp phía trước mặt. Nếu người này có thể bước đi vững vàng theo một đường thẳng, họ sẽ về tới nhà chỉ sau ít phút. Nhưng rắc rối duy nhất là: Người này không thể đi thẳng được nữa. Cứ sau mỗi phút, họ lại bước ngẫu nhiên về phía trước hoặc thụt lùi về phía sau với xác suất ngang nhau.
Liệu sau
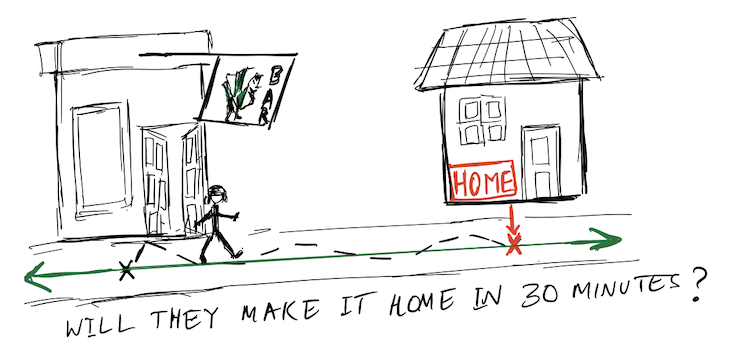
Hình 14.1: Bước đi ngẫu nhiên của người say trên trục tọa độ một chiều.
Tại mỗi bước thời gian (chẳng hạn mỗi phút), người say bước tiến
Đồ thị dưới đây mô phỏng một quỹ đạo cụ thể của người say trong thời gian
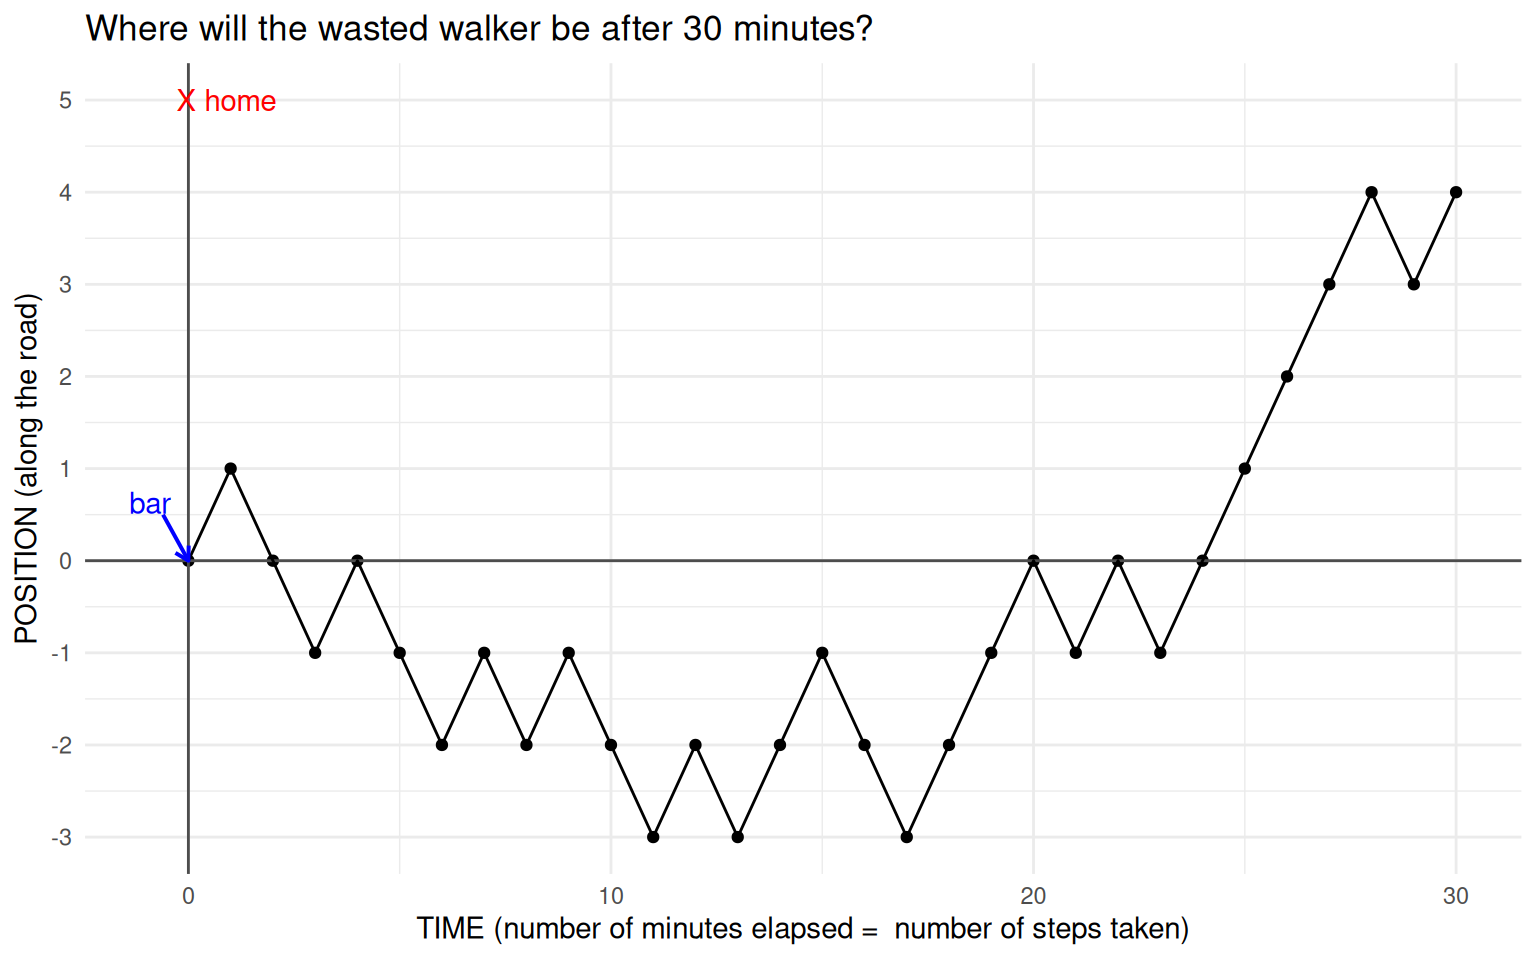
Hình 14.2: Một quỹ đạo mô phỏng vị trí của người say qua 30 bước đi ngẫu nhiên.
Đồ thị trải dài theo trục hoành nhằm thể hiện số bước thời gian đã trôi qua. Tuy nhiên, người đi bộ thực chất chỉ dao động tiến lùi trên trục tung. Chuyển động này được gọi là bước đi ngẫu nhiên đơn giản (Simple Random Walk).
Mô hình bước đi ngẫu nhiên có ứng dụng sâu rộng trong vật lý và tài chính: Mô hình hóa hạt photon tìm đường thoát khỏi lõi mặt trời, chuyển động Brown của các phân tử lơ lửng trong chất lỏng, hay sự biến động của giá cổ phiếu trên thị trường chứng khoán.
Để mô phỏng quỹ đạo này, ta định nghĩa một Bernoulli biến đổi
Kỳ vọng, phương sai và độ lệch chuẩn của một bước đi đơn lẻ được tính toán trực tiếp:
Trong ngôn ngữ lập trình R, ta có thể mô phỏng khoảng cách di chuyển sau
r
x <- c(-1, 1)      # Cac gia tri nhan cua bien ngau nhien X
px <- c(1/2, 1/2)  # Xac suat tuong ung
sum(sample(x, size = 30, prob = px, replace = TRUE))
Trong quỹ đạo cụ thể ở Hình 14.2, sáu bước đầu tiên là:
Một câu hỏi tự nhiên xuất hiện: Xác suất để người say dừng chân tại đúng vị trí
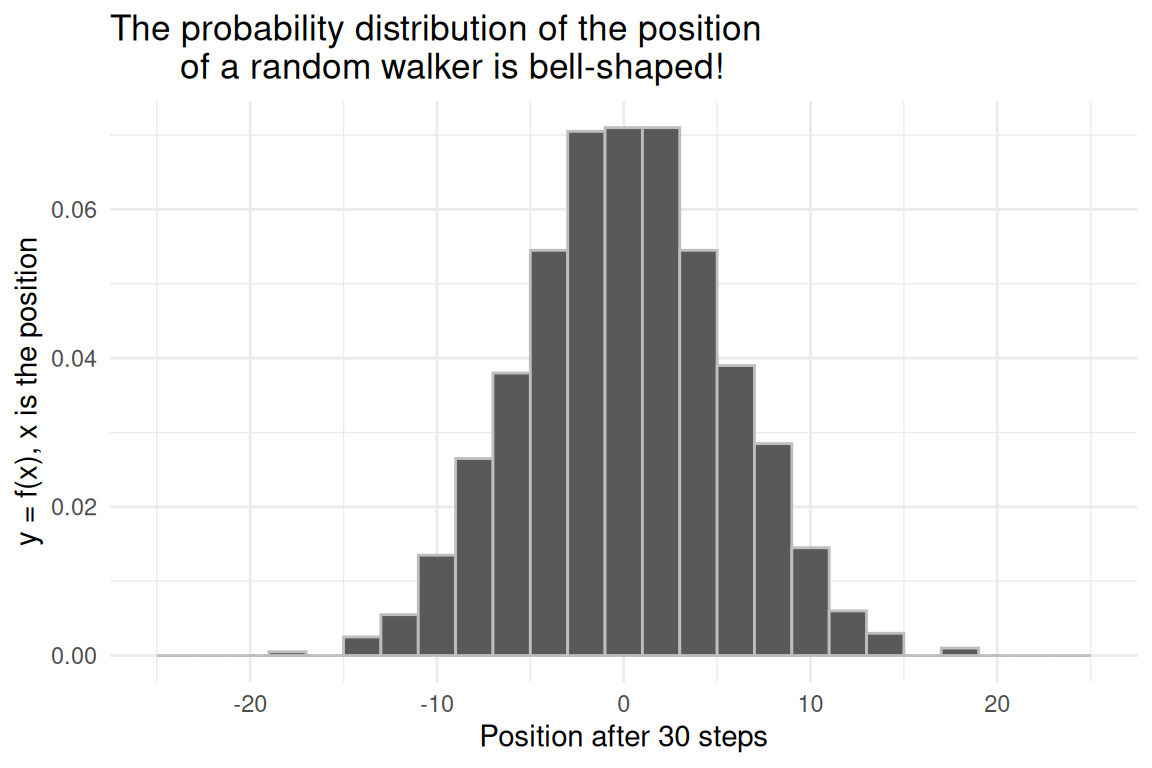
Hình 14.3: Phân phối thực nghiệm của vị trí cuối cùng sau 30 bước đi ngẫu nhiên.
Đồ thị phân phối thực nghiệm mang hình dáng quả chuông đối xứng đẹp mắt. Đây chính là biểu hiện sống động của một kết quả toán học nền tảng: Định lý Giới hạn Trung tâm. Để hiểu thấu đáo kết quả này, trước hết ta cần tìm hiểu về các độc lập và cùng phân phối.
Biến ngẫu nhiên độc lập và cùng phân phối (IID)
Định nghĩa: Biến ngẫu nhiên độc lập và cùng phân phối (IID)
Cho
- Độc lập (Independent): Mọi biến cố liên quan đến này đều độc lập thống kê với các biến ngẫu nhiên khác.
- Cùng phân phối (Identically Distributed): Tất cả đều có chung một hàm khối lượng xác suất
(hoặc hàm mật độ xác suất) và chung hàm phân phối tích lũy .
Khi đó, ta gọi
Khái niệm IID là viên gạch nền móng của lý thuyết xác suất và thống kê suy luận:
- Phân phối nhị thức
thực chất là tổng của Bernoulli độc lập cùng phân phối: với . - Tung một đồng xu
lần và đếm số mặt ngửa: Mỗi lần tung là một IID.
Ví dụ: Rút thăm có hoàn lại từ hộp vé
Xét chiếc hộp chứa 10 tấm vé được minh họa dưới đây:
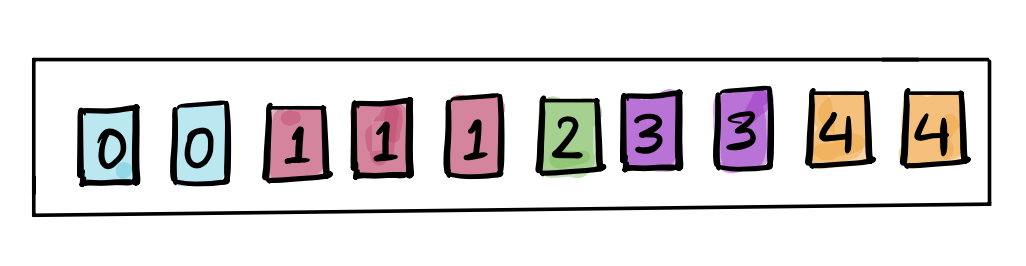
Hình 14.4: Hộp vé chứa 10 tấm vé: Hai vé số 0, ba vé số 1, một vé số 2, hai vé số 3 và hai vé số 4.
Giả sử ta rút ngẫu nhiên
Do mỗi lần rút đều được hoàn lại vé cũ vào hộp và xáo đều trước khi rút tiếp, kết quả của lần rút này hoàn toàn không ảnh hưởng đến lần rút khác. Đồng thời, cấu trúc các vé trong hộp không bao giờ thay đổi. Do đó,
Mô hình hộp (The Box Model)
Mọi rời rạc đều có thể biểu diễn tường minh thông qua một chiếc hộp chứa các tấm vé. Ta thiết kế số lượng vé sao cho xác suất rút được một tấm vé bất kỳ đúng bằng phân phối xác suất của biến ngẫu nhiên cần mô hình.
Khi đó, việc khảo sát sample(..., replace = TRUE) trong R.
Mọi hiện tượng ngẫu nhiên quen thuộc đều có thể quy về mô hình hộp:
- Đổ xúc xắc: Hộp gồm 6 tấm vé mang các số
. Đổ 2 con xúc xắc tương đương với rút 2 lần có hoàn lại và tính tổng .
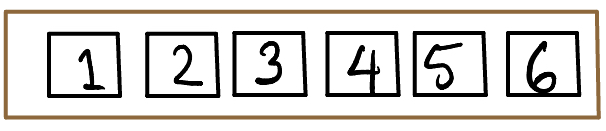
Hình 14.5: Đổ xúc xắc được mô hình hóa bằng việc rút vé từ hộp $\{1, 2, 3, 4, 5, 6\}$.
- Quay Roulette Las Vegas: Bàn quay kiểu Mỹ có tổng cộng 38 ô: 18 ô màu Đỏ, 18 ô màu Đen và 2 ô màu Xanh lá (số 0 và 00). Giả sử ta đặt cược 1 USD vào màu Đỏ: Nếu bóng lăn vào ô Đỏ, ta nhận lại 1 USD cược và thêm 1 USD tiền thắng (lãi ròng
USD), ngược lại nếu bóng lăn vào ô Đen hoặc Xanh, ta mất 1 USD tiền cược (lãi ròng USD).
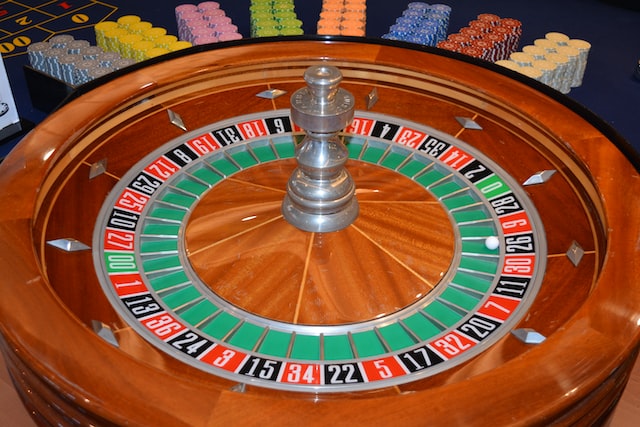
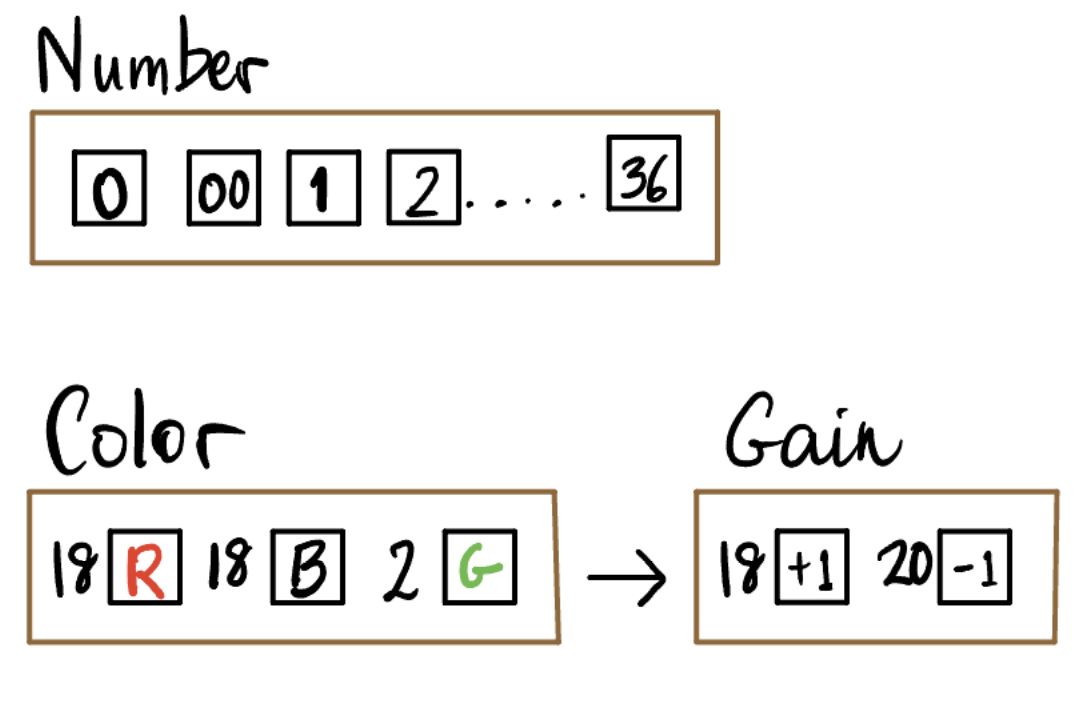
Hình 14.6: Bàn quay Roulette và bàn cược tại sòng bạc.
Chiếc hộp mô hình hóa một ván cược Roulette gồm đúng 38 tấm vé:
- 18 vé ghi số
(thắng cược khi bóng vào ô Đỏ). - 20 vé ghi số
(thua cược khi bóng vào ô Đen hoặc ô Xanh).
Nếu chơi
Ba câu hỏi then chốt khi xây dựng mô hình hộp
Để thiết lập mô hình hộp cho bất kỳ quá trình ngẫu nhiên nào, ta cần trả lời ba câu hỏi:
- Giá trị ghi trên các tấm vé là gì?: Phản ánh các kết cục số học của một phép thử đơn lẻ.
- Mỗi giá trị có bao nhiêu tấm vé?: Tỉ lệ số vé phản ánh chính xác xác suất xảy ra của từng kết cục.
- Cần rút thăm bao nhiêu lần?: Tương ứng với cỡ mẫu hoặc số lần lặp lại độc lập của thí nghiệm (
).
Tổng và Trung bình của các biến ngẫu nhiên IID
Trong thực tế thống kê, hai đại lượng thường được quan tâm nhất chính là Tổng mẫu và Trung bình mẫu của các quan sát ngẫu nhiên.
Tổng của các biến ngẫu nhiên IID
Xét
Bản thân
Xét lại chiếc hộp vé ở Hình 14.4 gồm 10 vé: Hai số 0, ba số 1, một số 2, hai số 3, hai số 4. Rút
- Giá trị nhỏ nhất có thể của
là: . - Giá trị lớn nhất có thể của
là: .
Đoạn mã R sau đây thực hiện rút 25 vé, tính tổng và lặp lại quá trình này 10 lần bằng hàm replicate():
r
set.seed(12345)
box <- c(0, 0, 1, 1, 1, 2, 3, 3, 4, 4)
replicate(n = 10, expr = sum(sample(x = box, size = 25, replace = TRUE)))
# Ket qua: 56 50 64 51 49 41 64 44 45 51
Vì mỗi vé trong hộp có phân phối xác suất xác định, ta tính được kỳ vọng và phương sai của một lần rút đơn lẻ
Giá trị này chính bằng trung bình cộng của 10 tấm vé trong hộp:
Phương sai của một lần rút đơn lẻ:
Độ lệch chuẩn của một lần rút:
Khi xét tổng của
- Theo tính chất tuyến tính của kỳ vọng:
- Do các lần rút độc lập, theo tính chất cộng của phương sai:
::: important Quy luật căn bậc hai cho tổng (Square Root Law for Sums) Độ lệch chuẩn của tổng
:::
Quy luật này phản ánh một trực giác sâu sắc: Khi số được cộng dồn tăng lên gấp
Quay lại bài toán người say rượu:
- Kỳ vọng vị trí:
. - Phương sai vị trí:
. - Độ lệch chuẩn vị trí:
bước.
Trung bình của các biến ngẫu nhiên IID
Trung bình mẫu của
Kỳ vọng của trung bình mẫu:
Kỳ vọng của trung bình mẫu không phụ thuộc vào cỡ mẫu
Phương sai của trung bình mẫu:
::: important Quy luật căn bậc hai cho trung bình mẫu Độ lệch chuẩn của trung bình mẫu tỉ lệ nghịch với căn bậc hai của cỡ mẫu:
:::
Khi cỡ mẫu
Sai số chuẩn (Standard Error - SE)
Trong thống kê, các đại lượng được tính toán từ dữ liệu mẫu như tổng mẫu
Để phân biệt độ lệch chuẩn của từng cá thể quan sát đơn lẻ
- Sai số chuẩn của tổng mẫu:
. - Sai số chuẩn của trung bình mẫu:
.
Minh họa mô phỏng: Phân phối của tổng và trung bình
Hãy quan sát phân phối mô phỏng của tổng và trung bình khi rút
- Đối với tổng
: , và . - Đối với trung bình
: , và .
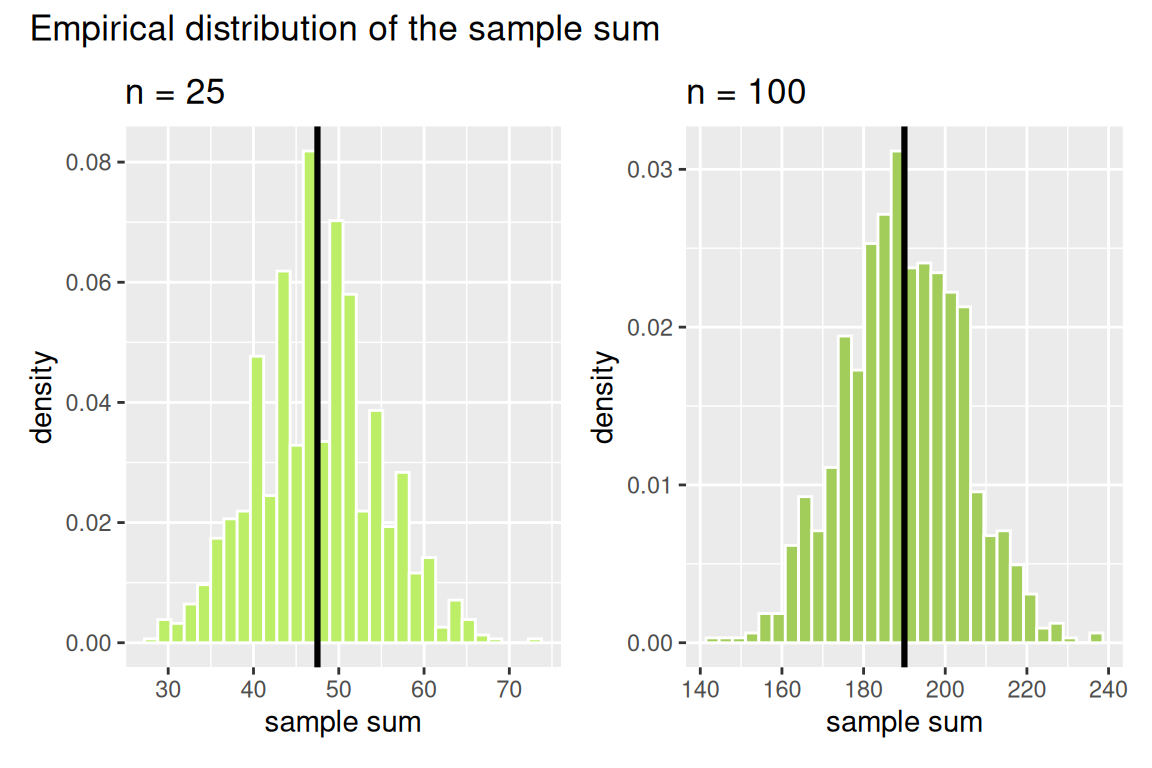
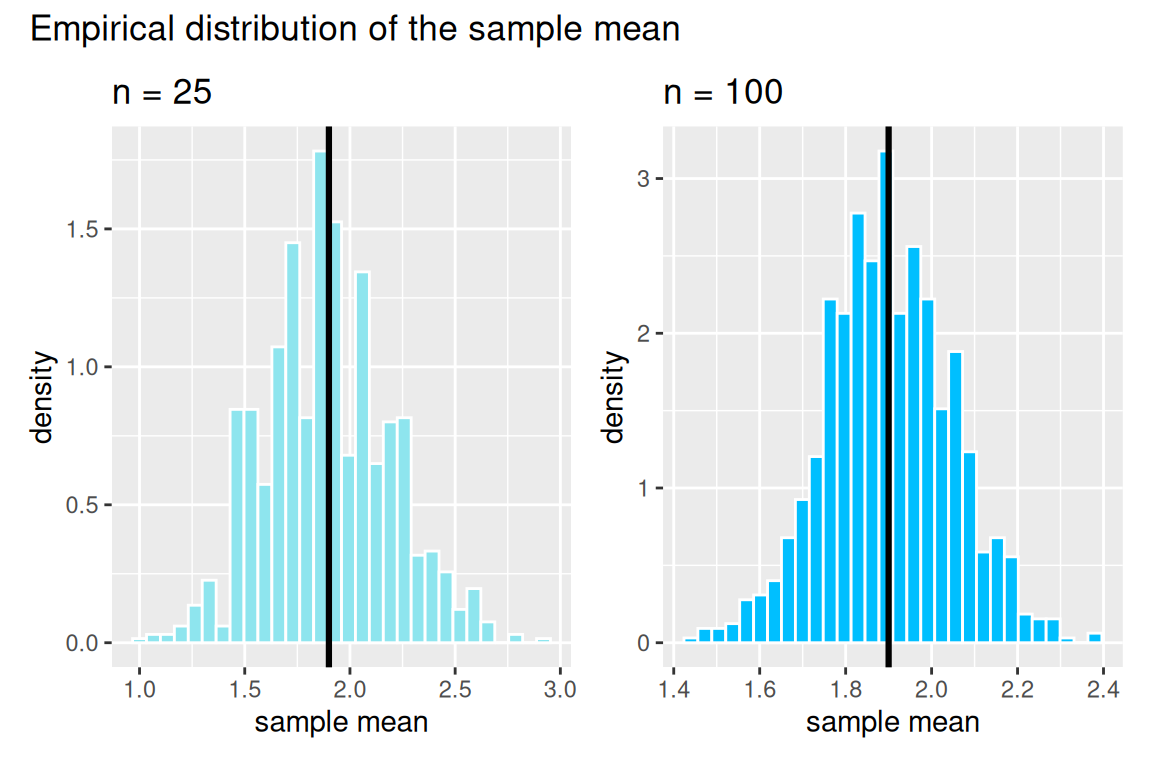
Hình 14.7: Đồ thị mật độ thực nghiệm của tổng mẫu (trái) và trung bình mẫu (phải) cho 25 lần rút có hoàn lại. Đường thẳng đứng màu đen biểu thị giá trị kỳ vọng.
Đặc điểm then chốt cần ghi nhận:
- Cả hai phân phối đều mang dáng dấp quả chuông đối xứng.
- Trục tung của đồ thị không ghi tần số hay tỉ lệ phần trăm, mà ghi Mật độ (Density). Điều này đảm bảo tổng diện tích của tất cả các cột trong biểu đồ luôn bằng
. - Biểu đồ này được gọi là biểu đồ mật độ (density histogram), đóng vai trò như một xấp xỉ thực nghiệm của hàm mật độ xác suất liên tục.
Biến ngẫu nhiên liên tục và Hàm mật độ xác suất (PDF)
Cho đến thời điểm này, chúng ta chủ yếu làm việc với các rời rạc, nơi xác suất tập trung tại từng điểm giá trị riêng biệt thông qua hàm khối lượng xác suất PMF.
Tuy nhiên, trong thế giới thực, rất nhiều đại lượng có thể nhận bất kỳ giá trị thực nào trong một khoảng liên tục: Chiều cao của sinh viên, thời gian chờ chuyến xe buýt kế tiếp, hay nhiệt độ không khí. Những đại lượng như vậy được gọi là liên tục.
Đối với liên tục, khối lượng xác suất
Định nghĩa: Hàm mật độ xác suất (Probability Density Function - PDF)
Hàm số
- Tính không âm:
với mọi . - Tổng diện tích dưới đường cong bằng 1:
Xác suất rơi vào một khoảng
Vì trong một khoảng số thực bất kỳ luôn chứa vô số giá trị không đếm được, xác suất để một liên tục nhận chính xác một giá trị đơn lẻ luôn bằng 0:
Xác suất chỉ có ý nghĩa khi xét trên một khoảng giá trị
Vì xác suất tại một điểm đơn lẻ bằng 0, việc có lấy hay không lấy dấu đẳng thức tại các đầu mút hoàn toàn không làm thay đổi giá trị xác suất:
Hàm phân phối tích lũy (Cumulative Distribution Function - CDF)
Tương tự như rời rạc, hàm phân phối tích lũy
Về mặt hình học,
Các phân phối liên tục tiêu biểu
Phân phối Đều liên tục:
Phân phối đơn giản nhất về mặt hình học là phân phối Đều trên đoạn
Hàm mật độ xác suất có dạng hình chữ nhật nằm ngang:
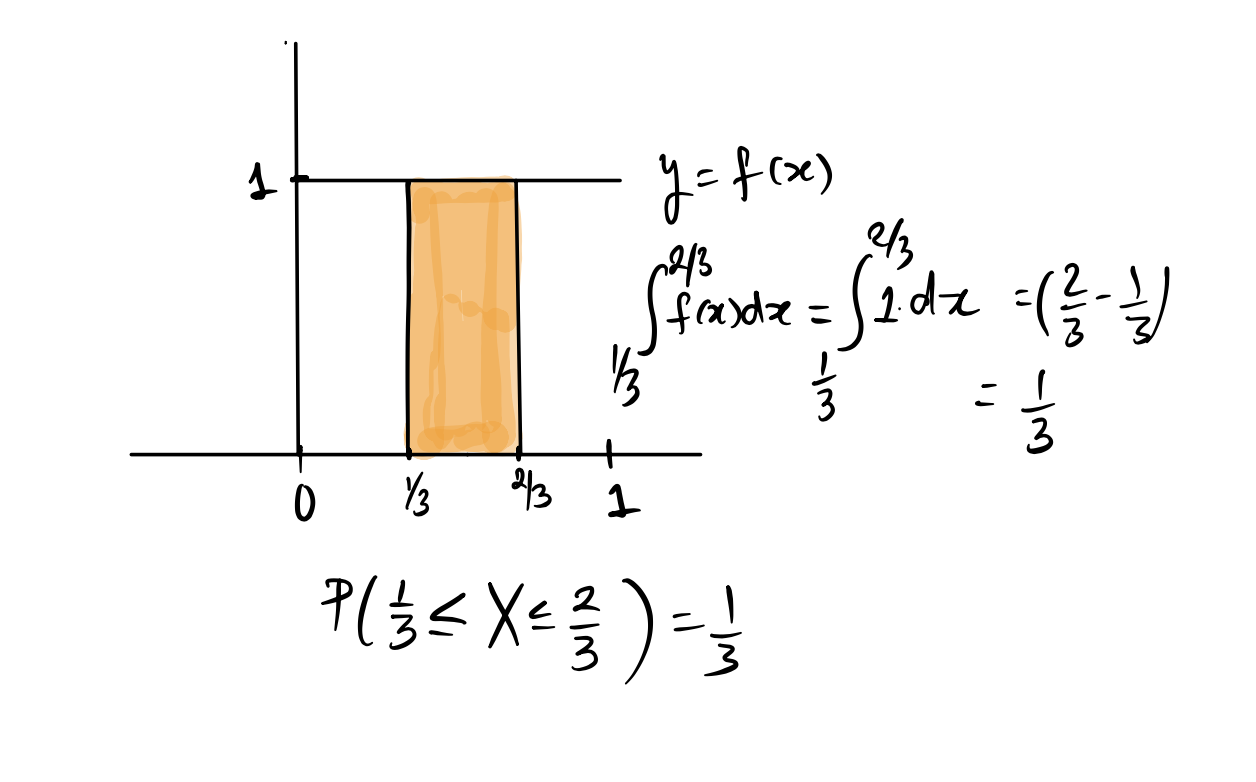
Hình 14.8: Đường cong mật độ của phân phối Đều $U(0, 1)$. Diện tích hình chữ nhật trên khoảng $(a, b)$ đúng bằng độ dài khoảng $b - a$.
Vì hàm mật độ là một đường thẳng nằm ngang có chiều cao bằng
Hàm phân phối tích lũy CDF của
Phân phối Chuẩn (Normal / Gaussian Distribution)
Phân phối Chuẩn, còn được gọi là phân phối Gauss theo tên nhà toán học lừng danh người Đức Carl Friedrich Gauss, là phân phối xác suất quan trọng và phổ biến nhất trong toàn bộ ngành thống kê.
Đường cong phân phối chuẩn hoàn toàn được xác định bởi hai tham số:
- Kỳ vọng
: Quyết định vị trí tâm đối xứng của đường cong. - Độ lệch chuẩn
: Quyết định độ bè rộng và chiều cao của đỉnh quả chuông.
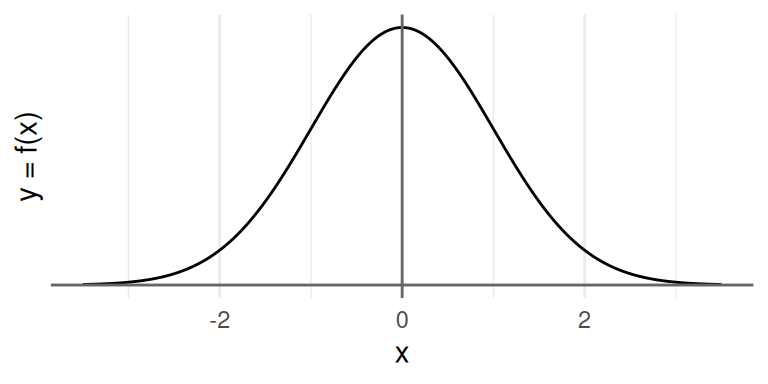
Hình 14.9: Phân phối chuẩn tắc $\mathcal{N}(0, 1)$ cùng các ngưỡng độ lệch chuẩn $\pm 1\sigma, \pm 2\sigma, \pm 3\sigma$.
Đơn vị chuẩn (Standard Units) và Phân phối chuẩn tắc
Mọi phân phối chuẩn bất kỳ
Bản chất của phép biến đổi này gồm hai thao tác hình học:
- Dịch chuyển tâm: Trừ đi
để đưa tâm phân phối về gốc tọa độ . - Co giãn tỉ lệ: Chia cho
để đưa độ lệch chuẩn về đúng .
Quy tắc thực nghiệm 68-95-99.7 (The Empirical Rule)
Đối với bất kỳ nào tuân theo phân phối chuẩn, diện tích dưới đường cong trong các khoảng đối xứng quanh tâm luôn tuân thủ quy tắc thực nghiệm:
| Khoảng giá trị | Độ lệch quanh tâm | Tỉ lệ diện tích (Xác suất) |
|---|---|---|
| Trong vòng | ||
| Trong vòng | ||
| Trong vòng |
Định lý Giới hạn Trung tâm (Central Limit Theorem - CLT)
Tại sao phân phối Chuẩn lại xuất hiện khắp mọi nơi trong tự nhiên, từ sai số đo đạc thiên văn, chỉ số thông minh, chiều cao con người cho đến doanh thu tài chính?
Câu trả lời nằm ở một trong những định lý vĩ đại và đáng kinh ngạc nhất của khoa học toán học: Định lý Giới hạn Trung tâm (Central Limit Theorem).
Định lý Giới hạn Trung tâm (Central Limit Theorem)
Cho
Khi cỡ mẫu
- Tổng mẫu
có phân phối tiệm cận phân phối chuẩn: - Trung bình mẫu
có phân phối tiệm cận phân phối chuẩn:
Ý nghĩa sư phạm và trực giác sâu xa của CLT
Điểm phi thường của Định lý Giới hạn Trung tâm nằm ở chữ bất kể phân phối gốc:
- Các tấm vé trong chiếc hộp ban đầu có thể có phân phối bất kỳ: Rời rạc, liên tục, lệch nặng sang một bên, đa đỉnh hay thậm chí mang hình chữ U.
- Chỉ cần ta rút thăm độc lập đủ nhiều lần (
đủ lớn), tổng và trung bình của các lượt rút sẽ tự động hội tụ về hình dáng quả chuông chuẩn tắc đối xứng hoàn hảo!
Giải mã bài toán người say rượu bằng CLT
Giờ đây ta có thể quay lại giải quyết dứt điểm bài toán người say rượu ở đầu bài học:
- Vị trí của người say sau
phút là tổng của IID: với . - Kỳ vọng:
. - Độ lệch chuẩn:
bước.
Theo Định lý Giới hạn Trung tâm, phân phối vị trí
Áp dụng quy tắc thực nghiệm 68-95-99.7:
- Xác suất người say nằm trong phạm vi 1 độ lệch chuẩn quanh quán bar (tức trong khoảng
) là khoảng . - Do đó, xác suất người say đi xa hơn 1 độ lệch chuẩn khỏi quán bar là:
. - Vì đường cong chuẩn hoàn toàn đối xứng qua 0:
- Xác suất người say tiến xa về phía nhà mình hơn 1 độ lệch chuẩn (
) là: . - Xác suất người say đi ngược hướng về phía xa hơn 1 độ lệch chuẩn (
) cũng là: .
- Xác suất người say tiến xa về phía nhà mình hơn 1 độ lệch chuẩn (
Tính toán phân phối chuẩn trong ngôn ngữ R
Trong môi trường phân tích dữ liệu, ta không cần tra bảng số thủ công mà sử dụng các hàm tích hợp sẵn của R:
pnorm(q, mean, sd): Tính xác suất tích lũy(diện tích bên trái điểm ). qnorm(p, mean, sd): Tìm phân vị (quantile) ứng với diện tích tích lũy. dnorm(x, mean, sd): Tính tung độ của hàm mật độ xác suất tại. rnorm(n, mean, sd): Sinh ngẫu nhiêngiá trị từ phân phối chuẩn.
r
# Tinh xac suat nguoi say di xa ve phia truoc hon 5 buoc sau 30 phut:
# P(S_30 > 5) = 1 - P(S_30 <= 5)
1 - pnorm(5, mean = 0, sd = sqrt(30))
# Ket qua: 0.1808 (khoang 18.1%)
Tóm tắt kiến thức cốt lõi
- IID: Độc lập và cùng phân phối xác suất.
- Mô hình hộp: Quy đổi mọi quá trình ngẫu nhiên rời rạc về việc rút thăm có hoàn lại từ một chiếc hộp vé.
- Quy luật căn bậc hai:
- Đối với tổng:
, . - Đối với trung bình:
, .
- Đối với tổng:
- liên tục: Được định nghĩa bởi hàm mật độ xác suất
với . Xác suất tại một điểm luôn bằng 0, trong khi xác suất trên một khoảng bằng diện tích. - Quy tắc 68-95-99.7: Trong phân phối chuẩn, khoảng
lần lượt chứa xấp xỉ tổng khối lượng xác suất. - Định lý Giới hạn Trung tâm (CLT): Tổng và trung bình của các IID tiệm cận phân phối chuẩn khi cỡ mẫu
đủ lớn, bất kể hình dạng phân phối ban đầu của từng biến đơn lẻ.
Bài tập rèn luyện
Bài tập 1: Nhận diện phân phối mẫu và kỳ vọng của tổng
Xét hai :
. là giá trị của một tấm vé rút ngẫu nhiên từ chiếc hộp chứa 5 tấm vé: .
Thực hiện lấy tổng của 100 độc lập cùng phân phối đối với cả hai biến, ký hiệu lần lượt là
- Tính kỳ vọng và sai số chuẩn của
và . - Giả sử ta vẽ hai biểu đồ phân phối thực nghiệm của
và , làm thế nào để nhận biết biểu đồ nào thuộc về nào?
Lời giải chi tiết
1. Tính kỳ vọng và sai số chuẩn:
- Đối với
: .
E(X) &= n_0 p = 10 \times 0.2 = 2 \ \text{Var}(X) &= n_0 p (1 - p) = 10 \times 0.2 \times 0.8 = 1.6 \ \text{SD}(X) &= \sqrt{1.6} \approx 1.2649 \end
\begin{aligned} E(S_{X, 100}) &= 100 \times E(X) = 100 \times 2 = 200 \ \text{Var}(S_{X, 100}) &= 100 \times \text{Var}(X) = 100 \times 1.6 = 160 \ \text{SE}(S_{X, 100}) &= \sqrt{160} = 4\sqrt{10} \approx 12.65 \end
E(Y) = \frac{0 + 2 + 3 + 4 + 6}{5} = \frac{15}{5} = 3
\begin{aligned} \text{Var}(Y) &= \frac{(0 - 3)^2 + (2 - 3)^2 + (3 - 3)^2 + (4 - 3)^2 + (6 - 3)^2}{5} \ &= \frac{9 + 1 + 0 + 1 + 9}{5} = \frac{20}{5} = 4 \ \text{SD}(Y) &= \sqrt{4} = 2 \end
\begin{aligned} E(S_{Y, 100}) &= 100 \times E(Y) = 100 \times 3 = 300 \ \text{Var}(S_{Y, 100}) &= 100 \times \text{Var}(Y) = 100 \times 4 = 400 \ \text{SE}(S_{Y, 100}) &= \sqrt{100} \times \text{SD}(Y) = 10 \times 2 = 20 \end
Bài tập 2: Rút thăm 100 lần từ hộp vé
Một chiếc hộp chứa 5 tấm vé mang các giá trị:
- Tính kỳ vọng và sai số chuẩn của tổng
. - Tính kỳ vọng và sai số chuẩn của trung bình mẫu
. - Dùng xấp xỉ phân phối chuẩn, ước lượng xác suất để tổng
vượt quá 600.
Lời giải chi tiết
1. Kỳ vọng và sai số chuẩn của tổng
Trước hết ta tính trung bình và độ lệch chuẩn của các vé trong hộp:
Phương sai của chiếc hộp:
Độ lệch chuẩn của chiếc hộp:
Với
2. Kỳ vọng và sai số chuẩn của trung bình mẫu
3. Ước lượng xác suất
Theo Định lý Giới hạn Trung tâm, vì
Giá trị
- Diện tích giữa
và là khoảng . - Phần diện tích nằm ngoài hai phía là
. - Do tính đối xứng, phần diện tích vượt quá
là: (Nếu tính chính xác qua hàm chuẩn tắc,).
Bài tập 3: Trò chơi đổ xúc xắc và Quy luật căn bậc hai
Một người tham gia một trò chơi đổ một con xúc xắc cân đối 6 mặt
Người chơi được quyền tự do lựa chọn số lần đổ:
- Bạn sẽ khuyên người chơi nên chọn
hay để giảm thiểu số tiền phạt kỳ vọng? Giải thích bản chất dựa trên quy luật căn bậc hai. - Giả sử luật chơi thay đổi: Người chơi cần đoán trung bình số nút của mỗi lần đổ thay vì tổng số nút, và tiền phạt tỉ lệ thuận với độ lệch của giá trị trung bình. Khi đó người chơi nên chọn
hay ?
Lời giải chi tiết
1. Trường hợp đoán tổng số nút:
Một con xúc xắc cân đối có các mặt mang giá trị từ 1 đến 6. Trung bình và phương sai của một lần đổ:
Để tối thiểu hóa tiền phạt kỳ vọng, dự đoán tối ưu của người chơi là chọn đúng giá trị kỳ vọng của tổng:
Theo quy luật căn bậc hai cho tổng:
- Khi
: - Khi
:
Vì
2. Trường hợp đoán trung bình số nút:
Khi luật chơi yêu cầu đoán trung bình số nút
- Khi
: nút. - Khi
: nút.
Khi cỡ mẫu
Tài liệu tham khảo
- UC Berkeley STAT 20: Introduction to Probability and Statistics, Department of Statistics, UC Berkeley.
- Freedman, D., Pisani, R., & Purves, R. (2007). Statistics (4th ed.). W. W. Norton & Company.