Giao diện
Dẫn nhập: Tái hiện Mô hình Giả thuyết Không bằng Mô hình Hộp
Trong bài học trước, chúng ta đã tiếp cận cấu trúc bốn bước kinh điển của một kiểm định giả thuyết thống kê:
- Thiết lập mô hình giả định: Đặt ra giả thuyết không
mô tả cơ chế sinh dữ liệu thuần túy ngẫu nhiên. - Chọn thống kê kiểm định: Lựa chọn một đại lượng số tóm tắt dữ liệu phù hợp với câu hỏi nghiên cứu.
- Xây dựng phân phối dưới
(Null Distribution): Ước lượng phân phối của thống kê kiểm định trong một thế giới mà giả thuyết không là đúng. - Đánh giá mức độ tương thích: Đối chiếu thống kê thực tế quan sát được với phân phối Null thông qua giá trị
-value.
Để xây dựng phân phối Null ở Bước 3 trong vụ án Kristen Gilbert, chúng ta đã sử dụng phép thử hoán vị (Permutation Test / Shuffling). Phương pháp hoán vị đặc biệt đắc dụng khi giả thuyết không khẳng định rằng hai biến số độc lập với nhau, cho phép ta bẻ gãy mối liên hệ bằng cách xáo trộn nhãn giữa hai nhóm.
Tuy nhiên, trong thực tế khoa học, chúng ta thường xuyên đối mặt với một dạng giả thuyết không khác: Giả thuyết quy định cụ thể tỉ lệ của nhiều nhóm danh mục (Test of Many Proportions). Khi đó, phép xáo trộn hai cột không còn áp dụng được nữa. Thay vào đó, chúng ta quay trở lại một công cụ quen thuộc đầy quyền năng: Mô hình hộp rút thăm (The Box Model).
Để làm chủ phương pháp này, chúng ta sẽ khảo sát một cuộc tranh luận phân tích dữ liệu nổi tiếng xoay quanh cuộc bầu cử tổng thống Iran năm 2009 và quy luật toán học mang tên Luật Benford.
Nghiên cứu thực tế: Cuộc bầu cử Tổng thống Iran năm 2009
Năm 2009, Iran tổ chức cuộc bầu cử tổng thống đầy kịch tính. Tổng thống đương nhiệm Mahmoud Ahmadinejad đối đầu với ba ứng viên thách thức, nổi bật là hai gương mặt thuộc phe cải cách: Mir-Hossein Mousavi và Mehdi Karroubi.
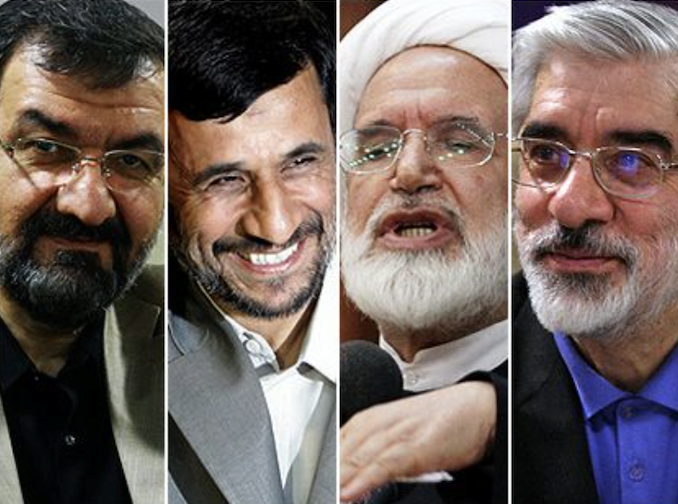
Hình 19.1: Bốn ứng viên tổng thống Iran năm 2009 (từ trái sang phải: Rezai, Ahmadinejad, Karroubi và Mousavi).
Trước ngày bầu cử, các cuộc thăm dò dư luận cho thấy sự ủng hộ rất mạnh mẽ dành cho Mousavi và Karroubi. Tuy nhiên, khi kết quả chính thức được công bố, phe cầm quyền tuyên bố Ahmadinejad giành chiến thắng áp đảo với
Các cuộc biểu tình rầm rộ nổ ra khắp đất nước, cáo buộc cuộc bầu cử đã bị thao túng gian lận. Các nhà quan sát quốc tế và các nhà khoa học dữ liệu lập tức vào cuộc kiểm tra tính trung thực của các con số. Một nhóm nghiên cứu độc lập đã áp dụng một phương pháp phân tích số học đặc biệt: Luật Benford.
Quy luật Chữ số Đầu tiên của Benford (Benford's Law)
Luật Benford là một định luật toán học mô tả phân phối tần suất xuất hiện của các chữ số đầu tiên (từ 1 đến 9) trong các tập dữ liệu số xuất hiện tự nhiên trải dài qua nhiều bậc độ lớn (orders of magnitude) như: Dân số các thành phố, diện tích các con sông, giá cổ phiếu, hoặc số liệu kế toán tài chính.
Theo Luật Benford, chữ số đầu tiên
Bảng phân phối xác suất theo Luật Benford:
| Chữ số đầu tiên | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| Tần suất lý thuyết |
Chữ số
Nhiều nhà phân tích cho rằng: Nếu một cuộc bầu cử diễn ra công bằng, chữ số đầu tiên của số phiếu bầu tại hàng trăm đô thị sẽ tuân theo Luật Benford, trong khi hành vi gian lận (như nhồi thêm phiếu giả) sẽ làm sai lệch phân phối này.
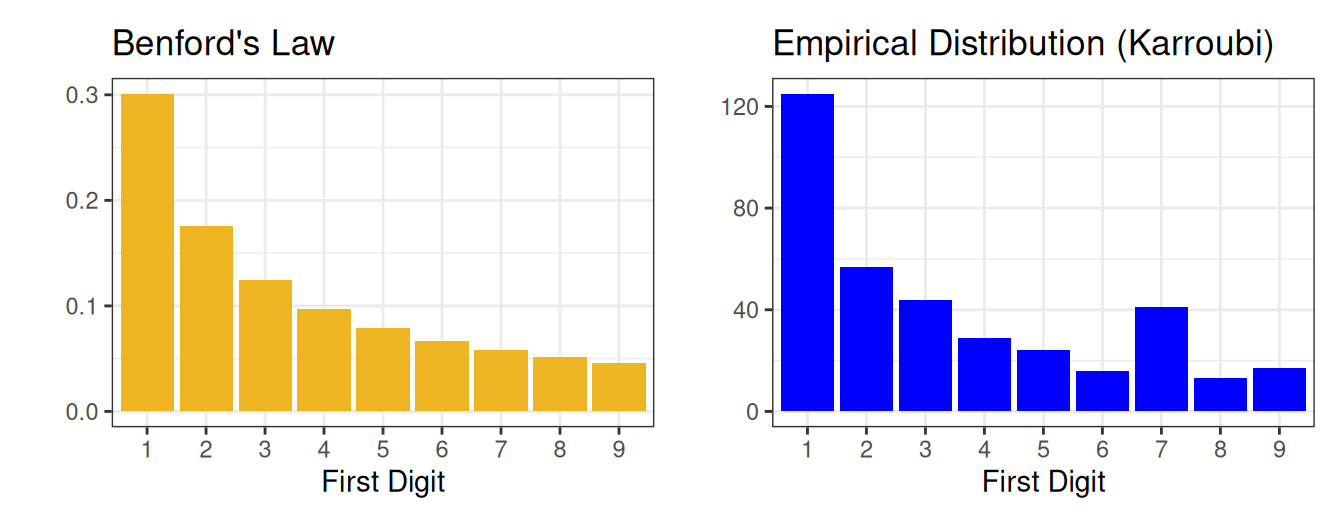
Hình 19.2: Trái: Phân phối lý thuyết theo Luật Benford. Phải: Phân phối thực tế chữ số đầu tiên trong số phiếu của ứng viên Karroubi tại 366 đô thị.
Quan sát Hình 19.2 (phải), các nhà phân tích phát hiện một sự bất thường rõ rệt: Chữ số 7 xuất hiện với tần suất cao đột biến, vượt xa mức kỳ vọng
Liệu đây có phải là bằng chứng của gian lận phiếu bầu, hay sự bất thường này chỉ đơn giản là do biến thiên ngẫu nhiên?
Thiết lập Kiểm định và Mô phỏng bằng Mô hình Hộp
Ta phát biểu bài toán kiểm định giả thuyết:
- Giả thuyết không (
): Chữ số đầu tiên trong số phiếu của Karroubi được sinh ra hoàn toàn tuân thủ Luật Benford: - Giả thuyết đối (
): Phân phối chữ số đầu tiên sai khác với Luật Benford (có ít nhất một tỉ lệ khác với giá trị lý thuyết).
Mô phỏng Phân phối Null bằng Mô hình Hộp
Để tạo ra một thế giới mà trong đó
- Ta chuẩn bị một chiếc hộp gồm
tấm vé: Trong đó có vé ghi số 1, vé ghi số 2, , và vé ghi số 9. - Vì toàn bộ Iran có
đơn vị bầu cử (đô thị), ta rút ngẫu nhiên có hoàn lại đúng tấm vé từ chiếc hộp này. Mẫu này mô phỏng một kết quả bầu cử có thể xảy ra dưới .
Mô phỏng máy tính tạo ra 9 mẫu ngẫu nhiên độc lập được minh họa dưới đây:
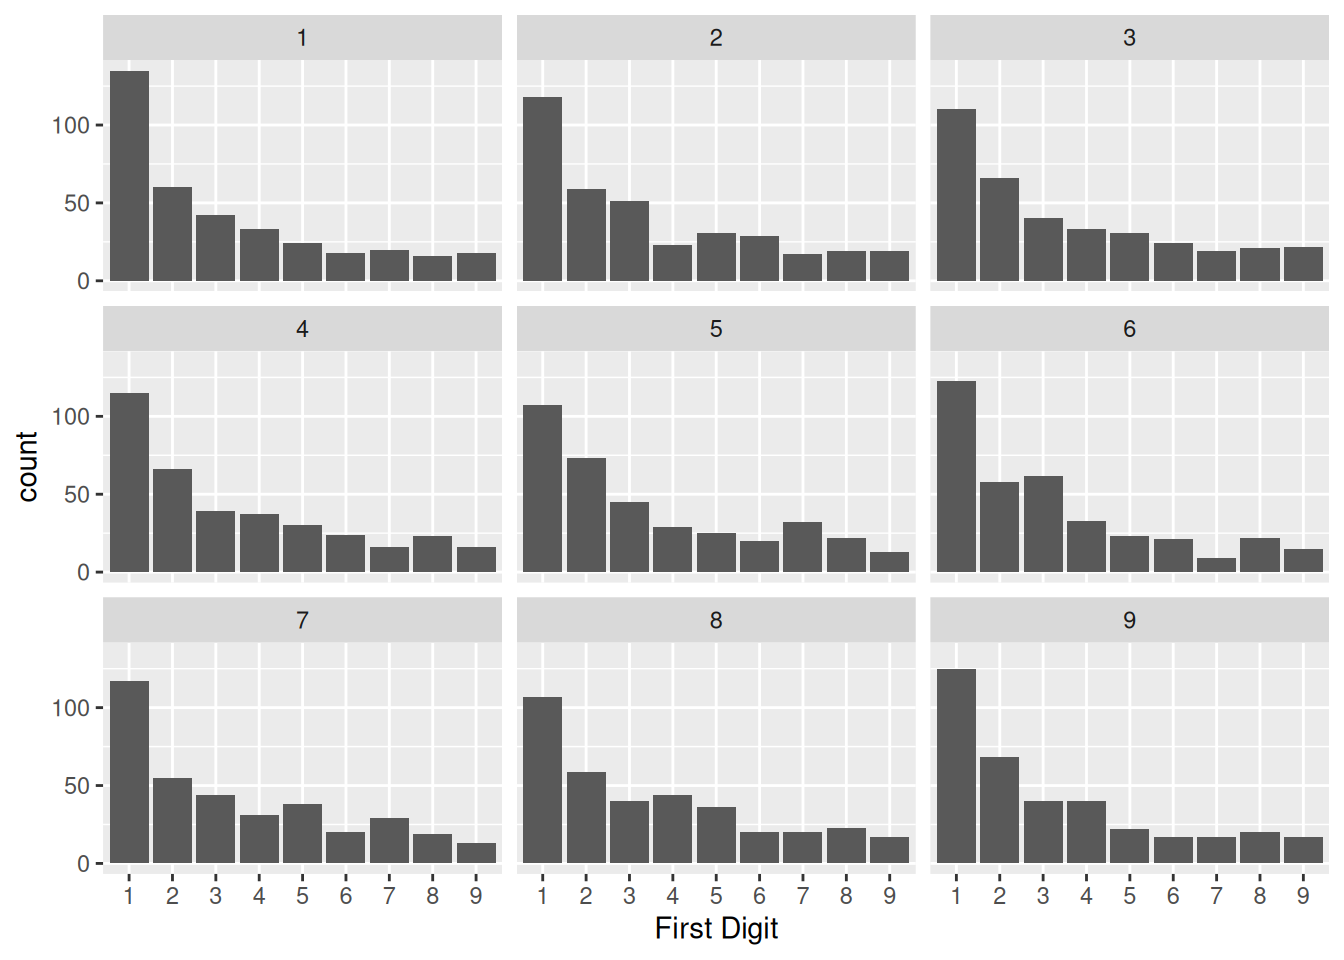
Hình 19.3: Chín phân phối thực nghiệm mô phỏng từ việc rút 366 vé có hoàn lại từ hộp Benford.
Biến thiên ngẫu nhiên luôn tồn tại: Mẫu thứ 6 có nhiều số 3 bất thường, còn mẫu thứ 5 tình cờ có số lượng chữ số 7 tăng vọt giống như dữ liệu thực tế của Karroubi.
Làm thế nào để đo lường chính xác xem mẫu thực tế của Karroubi khác biệt với Luật Benford ở mức độ nào?
Thống kê Khoảng cách: Chi bình phương (
Khi so sánh hai biểu đồ cột (biểu đồ quan sát thực tế và biểu đồ lý thuyết kỳ vọng), ta cần nén toàn bộ sự sai lệch trên tất cả các cột thành một chỉ số số học duy nhất đo lường khoảng cách. Đại lượng tiêu chuẩn cho nhiệm vụ này là Thống kê Chi bình phương (
Định nghĩa: Thống kê Chi bình phương (
Cho một biến định tính gồm
Thống kê Chi bình phương đo lường khoảng cách giữa phân phối quan sát và phân phối kỳ vọng được xác định bởi:
Phân tích ý nghĩa cấu trúc toán học của
- Hiệu số
: Đo lường độ chênh lệch chiều cao giữa cột quan sát và cột kỳ vọng. - Bình phương
: Đảm bảo các sai lệch âm và dương đều đóng góp giá trị dương vào khoảng cách (tránh triệt tiêu lẫn nhau). - Chia cho
: Chuẩn hóa độ lệch theo quy mô kỳ vọng của từng cột. Một độ lệch 10 đơn vị ở một cột có kỳ vọng 100 sẽ ít nghiêm trọng hơn nhiều so với độ lệch 10 đơn vị ở một cột chỉ có kỳ vọng 2!
Tính toán trên dữ liệu của Karroubi
Với tổng số
- Chữ số 1: Quan sát được
lần, với kỳ vọng lần . - Lặp lại cho toàn bộ 9 chữ số và cộng dồn lại:
Khoảng cách tính được là
Phân phối Null của Thống kê
Để trả lời câu hỏi trên, ta tiến hành mô phỏng rút
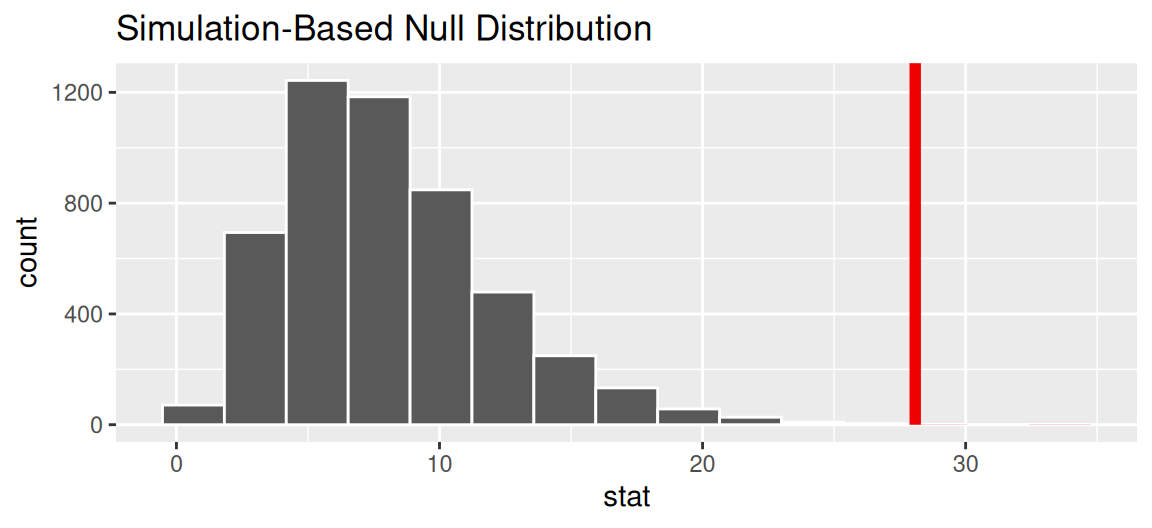
Hình 19.4: Phân phối Null của thống kê Chi bình phương qua 5.000 lần mô phỏng. Đường thẳng đứng màu đỏ biểu thị giá trị thực tế $\chi^2 = 28.1$.
Bức tranh phân phối Null chỉ rõ:
- Trong một thế giới mà số phiếu thực sự tuân theo Luật Benford, giá trị
thường dao động trong khoảng từ đến , hiếm khi vượt quá . - Giá trị quan sát thực tế
nằm vượt xa khỏi toàn bộ phạm vi của phân phối Null. - Trong toàn bộ
lần rút ngẫu nhiên, không có bất kỳ lần nào khoảng cách đạt tới con số . - Do đó:
Dữ liệu phiếu bầu của Karroubi hoàn toàn không tương thích với Luật Benford.
Bằng chứng của điều gì? Bài học về Giới hạn của Giả thuyết
Một
Câu trả lời đòi hỏi tư duy phản biện khoa học sâu sắc:
- Luật Benford chỉ là một mô hình toán học trừu tượng. Để một tập dữ liệu tuân theo Luật Benford, các con số phải trải rộng qua nhiều bậc độ lớn và hình thành từ các quá trình nhân ngẫu nhiên không bị giới hạn.
- Phiếu bầu cử tại các đô thị thường bị giới hạn bởi quy mô dân số của các quận huyện (thường chỉ dao động trong một khoảng nhất định), quy trình kiểm phiếu và ranh giới địa lý.
- Khi các nhà khoa học áp dụng phép thử Benford lên các cuộc bầu cử tại Hoa Kỳ và nhiều quốc gia dân chủ khác (nơi tính liêm chính của bầu cử được giám sát nghiêm ngặt), họ nhận thấy nhiều bang cũng có độ lệch
lớn không kém!
::: important Bài học phương pháp luận Bác bỏ
Kiểm định một phía (One-tailed) hay Hai phía (Two-tailed)?
Trong kiểm định so sánh hai nhóm, ta thường đứng trước ba cách thiết lập giả thuyết đối:
(Kiểm định một phía bên trái). (Kiểm định một phía bên phải). (Kiểm định hai phía).
Tại sao các nhà thống kê luôn khuyến nghị sử dụng kiểm định hai phía làm mặc định chuẩn mực khoa học?
- Tránh thổi phồng sai lầm loại I (Type I Error): Nếu ta chỉ nhìn vào dữ liệu rồi mới chọn hướng của
theo hướng dữ liệu đang nghiêng, ta đang "bắn súng rồi mới vẽ bia", làm tăng gấp đôi xác suất kết luận sai. - Tránh thiên kiến xác nhận (Confirmation Bias): Kiểm định khoa học chân chính phải cởi mở với mọi khả năng khách quan (kể cả khả năng hiệu ứng ngược lại với kỳ vọng ban đầu).
- Trường hợp ngoại lệ của
: Kiểm định Chi bình phương luôn là kiểm định một phía bên phải, bởi vì khoảng cách . Vùng bên trái (gần 0) đại diện cho sự trùng khớp hoàn hảo với , chỉ có đuôi bên phải (giá trị rất lớn) mới đại diện cho sự sai lệch nghiêm trọng.
Nghiên cứu mở rộng: Hiệu ứng Bouba/Kiki
Một ứng dụng kinh điển khác của kiểm định tỉ lệ thông qua thực nghiệm tâm lý học ngôn ngữ: Hiệu ứng Bouba/Kiki.
Năm 1929, nhà tâm lý học Wolfgang Köhler thực hiện một thí nghiệm nổi tiếng: Cho người tham gia quan sát hai hình vẽ dưới đây và yêu cầu gán hai cái tên vô nghĩa: Bouba và Kiki.
%20--%3e%3c!DOCTYPE%20svg%20PUBLIC%20'-//W3C//DTD%20SVG%201.1//EN'%20'http://www.w3.org/Graphics/SVG/1.1/DTD/svg11.dtd'%3e%3csvg%20version='1.1'%20id='svg2'%20xmlns:svg='http://www.w3.org/2000/svg'%20xmlns='http://www.w3.org/2000/svg'%20xmlns:xlink='http://www.w3.org/1999/xlink'%20x='0px'%20y='0px'%20width='500px'%20height='255px'%20viewBox='0%200%20500%20255'%20enable-background='new%200%200%20500%20255'%20xml:space='preserve'%3e%3cg%20id='layer1'%20transform='translate(-125,-404.86218)'%3e%3cpath%20id='path2480'%20fill='%239C9C9C'%20stroke='%231B1B1B'%20stroke-miterlimit='6'%20d='M248.599,576.716%20c-31.647,15.417-46.259,22.331-85.027,39.894c19.285-21.204,39.446-43.555,58.428-65.636l-77.705-42.509l83.506,13.93%20l-18.271-59.74l42.984,38.913l54.95-77.342l-18.171,104.264l55.664-3.277l-50.614,31.103L327,600.815l-51.578-12.708l-21.547,46.54%20L248.599,576.716z'/%3e%3cpath%20id='path2478'%20fill='%239C9C9C'%20stroke='%231B1B1B'%20stroke-miterlimit='6'%20d='M509,626.239c-1.375-0.981-3.063-2.48-3.752-3.33%20c-2.943-3.635-7.394-14.498-11.283-27.547c-2.296-7.699-4.718-14.574-5.381-15.275c-0.965-1.02-3.003,0.369-10.146,6.914%20c-9.688,8.875-18.525,15.075-24.127,16.924c-1.949,0.644-5.851,0.948-8.668,0.678c-4.685-0.45-5.536-0.952-9.923-5.85%20C428.89,591.126,425,582.908,425,576.104c0-11.9,4.828-16.15,29.353-25.832c15.08-5.954,18.125-9.107,11.049-11.442%20c-2.004-0.661-13.851-1.535-26.75-1.972c-24.274-0.823-29.65-1.723-35.595-5.955c-4.073-2.9-6.057-6.947-6.057-12.356%20c0-12.213,11.053-14.281,46.399-8.68c20.776,3.292,30.184,3.751,33.104,1.616c1.782-1.303,1.794-1.519,0.216-3.928%20c-0.919-1.402-8.46-7.832-16.758-14.289c-16.246-12.642-21.637-18.038-25.036-25.06c-4.392-9.072-0.61-17.939,10.144-23.786%20c4.396-2.39,6.941-3.022,13.566-3.37c7.502-0.394,8.573-0.199,13.401,2.428c6.916,3.764,10.25,7.874,17.464,21.527%20c3.3,6.246,6.45,11.356,7,11.356s3.855-5.802,7.345-12.893c7.295-14.822,13.165-21.725,20.052-23.58%20c5.377-1.448,10.354-0.455,13.269,2.647c3.343,3.557,3.734,15.401,0.938,28.325c-7.068,32.67-7.41,39.056-2.229,41.629%20c3.945,1.959,7.815-0.274,17.04-9.833c9.763-10.118,16.987-14.466,22.277-13.408c5.412,1.083,11.526,5.397,16.118,11.376%20c6.312,8.217,8.689,13.375,8.689,18.851c0,4.14-0.452,5.125-3.822,8.331c-4.412,4.198-10.726,6.495-23.675,8.613%20c-18.739,3.065-21.638,3.73-23.768,5.455c-2.037,1.649-2.086,1.967-0.712,4.588c0.812,1.549,7.156,8.732,14.099,15.961%20c16.806,17.502,20.641,24.129,17.489,30.222c-1.57,3.036-5.843,5.216-10.226,5.216c-3.461,0-10.666-2.642-22.386-8.208%20c-18.58-8.825-20.133-8.345-11.999,3.71c10.685,15.834,12.265,22.434,6.702,27.996c-4.164,4.163-8.765,5.533-20.703,6.162%20C512.954,627.947,511.117,627.751,509,626.239z'/%3e%3c/g%3e%3c/svg%3e)
Hình 19.5: Hai hình vẽ trong thí nghiệm Bouba/Kiki: Một hình góc cạnh sắc nhọn và một hình uốn lượn cong tròn.
Khung kiểm định giả thuyết:
- Giả thuyết không (
): Việc gán tên cho hình vẽ là hoàn toàn tùy tiện và ngẫu nhiên. Người tham gia chọn tên như tung đồng xu: - Giả thuyết đối (
): Con người có xu hướng gán âm sắc nhọn "Kiki" cho hình sắc nhọn một cách phi ngẫu nhiên:
Khi thực hiện trên hàng nghìn người thuộc nhiều nền văn hóa và ngôn ngữ khác nhau trên toàn cầu, hơn
Tóm tắt kiến thức cốt lõi
- Mô hình hộp cho nhiều tỉ lệ: Khi
quy định tỉ lệ xuất hiện của nhiều nhóm danh mục, ta tạo một chiếc hộp với số lượng vé tương ứng với các tỉ lệ lý thuyết và rút ngẫu nhiên có hoàn lại để tạo phân phối Null. - Khoảng cách Chi bình phương: Đây là thước đo khoảng cách chuẩn hóa giữa phân phối thực tế quan sát và phân phối kỳ vọng lý thuyết, xác định bởi công thức
. - Quy tắc đuôi: Phép thử Chi bình phương luôn tính
-value trên đuôi bên phải của phân phối Null. - Cảnh báo về giải thích: Bác bỏ
chỉ chứng minh dữ liệu không phù hợp với mô hình lý thuyết, không tự động chứng minh kết luận nguyên nhân - kết quả nếu mô hình lý thuyết chưa phản ánh đúng thực tế.
Bài tập rèn luyện
Bài tập 1: So sánh Khoảng cách Chi bình phương
Xét hai cặp phân phối tần số giữa giá trị quan sát (
Cặp phân phối A:
- Nhóm 1: Quan sát
, Kỳ vọng . - Nhóm 2: Quan sát
, Kỳ vọng . - Nhóm 3: Quan sát
, Kỳ vọng .
- Nhóm 1: Quan sát
Cặp phân phối B:
- Nhóm 1: Quan sát
, Kỳ vọng . - Nhóm 2: Quan sát
, Kỳ vọng . - Nhóm 3: Quan sát
, Kỳ vọng .
- Nhóm 1: Quan sát
- Tính toán giá trị thống kê Chi bình phương
cho cả hai cặp phân phối. - Cặp phân phối nào có khoảng cách Chi bình phương lớn hơn? Nêu trực giác toán học giải thích tại sao sự chênh lệch lại lớn đến như vậy.
Lời giải chi tiết
1. Tính toán thống kê Chi bình phương:
- Đối với Cặp phân phối A:
\chi^2_A &= \frac{(O_1 - E_1)^2}{E_1} + \frac{(O_2 - E_2)^2}{E_2} + \frac{(O_3 - E_3)^2}{E_3} \ &= \frac{(1 - 1)^2}{1} + \frac{(10 - 1)^2}{1} + \frac{(1 - 10)^2}{10} \ &= 0 + \frac{81}{1} + \frac{81}{10} = 81 + 8.1 = 89.1 \end
\begin{aligned} \chi^2_B &= \frac{(O_1 - E_1)^2}{E_1} + \frac{(O_2 - E_2)^2}{E_2} + \frac{(O_3 - E_3)^2}{E_3} \ &= \frac{(3 - 5)^2}{5} + \frac{(4 - 4)^2}{4} + \frac{(5 - 3)^2}{3} \ &= \frac{(-2)^2}{5} + 0 + \frac{2^2}{3} = \frac{4}{5} + \frac{4}{3} = 0.8 + 1.333 \approx 2.13 \end
Bài tập 2: Kiểm định Luật Benford trên Dữ liệu Thuế
Một thanh tra viên thuế nghi ngờ một công ty làm giả sổ sách hóa đơn đầu vào. Thanh tra viên thu thập chữ số đầu tiên của
Dưới giả thuyết không
- Tính số lượng hóa đơn kỳ vọng bắt đầu bằng chữ số 1 và số lượng kỳ vọng bắt đầu bằng chữ số 9.
- Thiết kế một mô hình hộp rút thăm bằng vé để mô phỏng một mẫu gồm 200 hóa đơn dưới giả thuyết không
. - Nếu giá trị
tính được từ mẫu của công ty là , trong khi phân phối Null mô phỏng cho thấy các giá trị nằm trong khoảng từ đến , thanh tra viên nên đưa ra kết luận gì?
Lời giải chi tiết
1. Số lượng hóa đơn kỳ vọng: Theo Luật Benford:
- Tỉ lệ lý thuyết của chữ số 1:
. Số hóa đơn kỳ vọng: hóa đơn. - Tỉ lệ lý thuyết của chữ số 9:
. Số hóa đơn kỳ vọng: hóa đơn.
2. Thiết kế mô hình hộp rút thăm:
- Chuẩn bị một chiếc hộp gồm
tấm vé đánh số từ 1 đến 9: - 301 vé ghi số 1, 176 vé ghi số 2, 125 vé ghi số 3, 97 vé ghi số 4, 79 vé ghi số 5, 67 vé ghi số 6, 58 vé ghi số 7, 51 vé ghi số 8 và 46 vé ghi số 9.
- Mỗi lần mô phỏng, rút ngẫu nhiên có hoàn lại
tấm vé từ chiếc hộp này.
3. Kết luận của thanh tra viên:
- Giá trị
nằm hoàn toàn trong vùng dao động thông thường của phân phối Null ( ). - Giá trị
-value sẽ khá lớn (chắc chắn lớn hơn ). - Kết luận: Chưa có đủ bằng chứng thống kê để bác bỏ giả thuyết không
. Dữ liệu hóa đơn của công ty hoàn toàn tương thích với Luật Benford, đồng thời không có dấu hiệu bất thường về mặt tần suất chữ số đầu tiên.
Bài tập 3: Thiết lập Kiểm định cho Hiệu ứng Bouba/Kiki
Trong một lớp học gồm
- Hãy phát biểu giả thuyết không
và giả thuyết đối một phía theo tham số tỉ lệ . - Nếu giả thuyết không
là đúng, số sinh viên kỳ vọng chọn tên "Kiki" là bao nhiêu? Độ lệch chuẩn của số người chọn "Kiki" dưới là bao nhiêu? - Tính giá trị chuẩn hóa Z-score của kết quả quan sát được dưới
và ước lượng -value. Nêu kết luận thực nghiệm.
Lời giải chi tiết
1. Phát biểu giả thuyết: Gọi
- Giả thuyết không:
(Lựa chọn ngẫu nhiên, tên gọi và hình dạng độc lập). - Giả thuyết đối:
(Xu hướng gán tên "Kiki" cho hình sắc nhọn cao hơn ngẫu nhiên).
2. Kỳ vọng và độ lệch chuẩn của số người chọn Kiki dưới
3. Chuẩn hóa Z-score và ước lượng
Giá trị quan sát được nằm cách kỳ vọng hơn
Kết luận: Vì
Tài liệu tham khảo
- UC Berkeley STAT 20: Introduction to Probability and Statistics, Department of Statistics, UC Berkeley.
- Benford, F. (1938). The law of anomalous numbers. Proceedings of the American Philosophical Society, 78(4), 551–572.
- Köhler, W. (1929). Gestalt Psychology. Horace Liveright.