Giao diện
Dẫn nhập: Định lượng độ bất định trong suy rộng
Tiến trình suy rộng từ một đại lượng thống kê của mẫu sang một tham số chưa biết của được gọi là Suy diễn thống kê (Statistical Inference).
Tham số mà chúng ta quan tâm có thể là giá trị trung bình
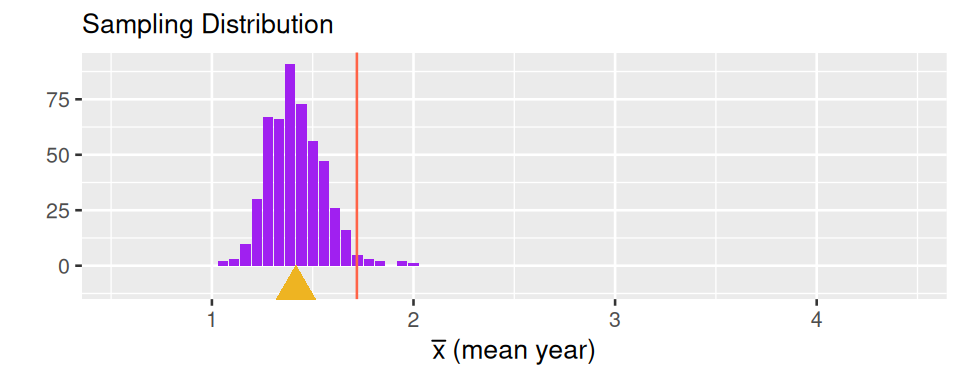
Hình 16.1: Phân phối chọn mẫu thâu tóm hai nguồn gốc sai số: Độ lệch (khoảng cách ngang từ đường thẳng đứng đỏ biểu thị tham số thực đến tam giác vàng biểu thị tâm phân phối) và Độ biến thiên (độ dàn trải của phân phối).
Để định lượng chính xác độ biến thiên lấy mẫu khi phương pháp thu thập dữ liệu không chứa độ lệch, các nhà thống kê sử dụng hai công cụ tiêu chuẩn:
Hai công cụ định lượng độ biến thiên lấy mẫu
- Sai số chuẩn (Standard Error - SE): Độ lệch chuẩn của phân phối chọn mẫu của một đại lượng thống kê.
- Khoảng tin cậy (Confidence Interval - CI): Một khoảng giới hạn gồm hai giá trị (cận dưới và cận trên) bao quát phần lớn khối lượng xác suất của phân phối chọn mẫu, dùng để định lượng độ tin cậy của ước lượng tham số.
Để tập trung sâu sắc vào độ biến thiên lấy mẫu mà không bị phân tâm bởi độ lệch, chúng ta sẽ khảo sát một nghiên cứu điển hình sử dụng phương pháp lấy mẫu ngẫu nhiên đơn giản (Simple Random Sampling - SRS).
Nghiên cứu thực tế: Điểm an toàn thực phẩm tại San Francisco
Hằng năm, Sở Y tế thành phố San Francisco tiến hành thanh tra toàn bộ các nhà hàng trên địa bàn thành phố về tiêu chuẩn vệ sinh an toàn thực phẩm. Mỗi nhà hàng sau khi kiểm tra sẽ được chấm một điểm số từ 48 (nguy cơ ô nhiễm nghiêm trọng) đến 100 (hoàn toàn sạch sẽ, đạt chuẩn tuyệt đối).
Bộ dữ liệu năm 2016 được công khai trực tuyến trên cổng thông tin thành phố. Đây là một cơ hội hiếm có để ta xây dựng từng mảnh ghép của bức tranh thống kê.
1. Phân phối của Tổng thể (Population Distribution)
nghiên cứu bao gồm toàn bộ các nhà hàng hoạt động tại San Francisco. Vì dữ liệu được ghi nhận cho mọi nhà hàng, ta đang nắm trong tay dữ liệu tổng điều tra (census).
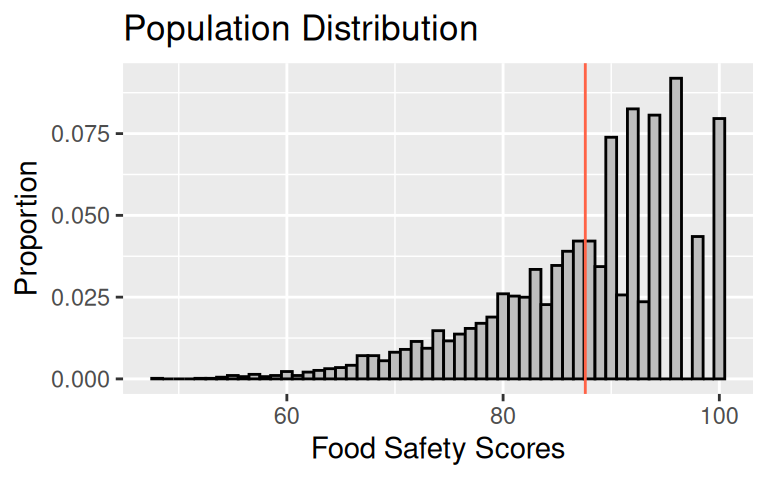
Hình 16.2: Phân phối tổng thể của điểm an toàn thực phẩm tại San Francisco (lệch trái với đuôi dài về bên trái).
Phân phối của bị lệch trái rõ rệt với đuôi dài kéo về phía điểm thấp. Điểm số tối đa là 100. Đáng chú ý, các điểm chẵn xuất hiện phổ biến hơn các điểm lẻ ở vùng trên 90 điểm (thực tế hoàn toàn không có điểm 99, 97 hay 95).
Từ này, ta tính được hai tham số tổng thể (thường ký hiệu bằng chữ cái Hy Lạp):
- Điểm trung bình :
. - Độ lệch chuẩn :
.
2. Phân phối Thực nghiệm của Mẫu (Empirical Distribution)
Dù trên thực tế thành phố lưu trữ hồ sơ của mọi nhà hàng, hãy tưởng tượng bạn là một thanh tra viên độc lập chỉ có đủ nguồn lực để đến kiểm tra một mẫu ngẫu nhiên đơn giản gồm
Phân phối thực nghiệm của mẫu 100 nhà hàng này có dạng:
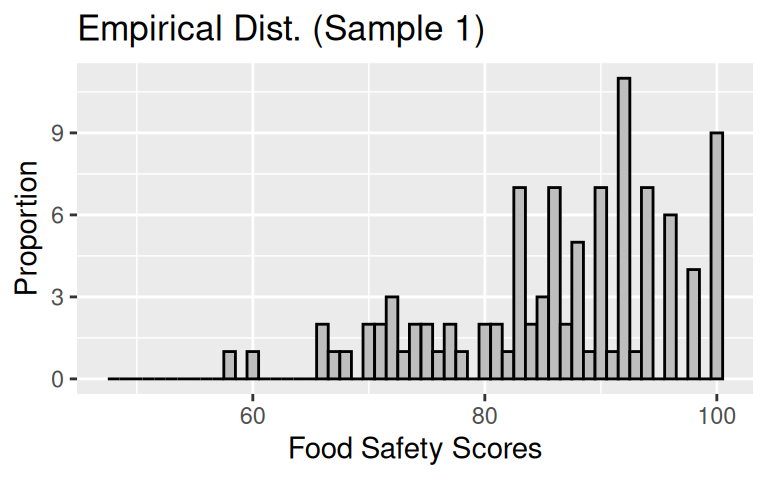
Hình 16.3: Phân phối thực nghiệm của một mẫu ngẫu nhiên gồm 100 nhà hàng.
Từ mẫu này, ta tính được hai thống kê mẫu (thường ký hiệu bằng chữ cái Latinh):
- Trung bình mẫu:
. - Độ lệch chuẩn mẫu:
.
Vì mẫu được rút ngẫu nhiên không thiên lệch, hình dạng của phân phối thực nghiệm mô phỏng khá sát hình dạng của (cùng có đuôi lệch trái). Các đại lượng thống kê
3. Phân phối Chọn mẫu (Sampling Distribution)
Nếu một thanh tra viên khác cũng rút một mẫu ngẫu nhiên đơn giản gồm 100 nhà hàng, mẫu của người đó chắc chắn không trùng hệt với bạn. Điểm trung bình mẫu
Tập hợp tất cả các giá trị có thể có của
Để quan sát hình dạng của phân phối này, ta thực hiện mô phỏng máy tính bằng cách lặp lại quy trình rút mẫu 100 nhà hàng
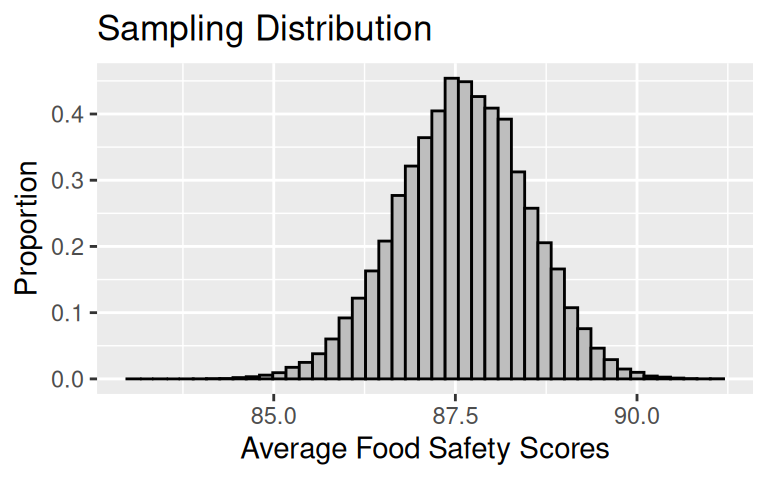
Hình 16.4: Phân phối chọn mẫu của trung bình mẫu $\bar{x}$ qua 100.000 mẫu ngẫu nhiên gồm 100 nhà hàng.
Các chỉ số tóm tắt của phân phối chọn mẫu:
- Tâm của phân phối chọn mẫu:
(trùng khít với ). - Độ lệch chuẩn của phân phối chọn mẫu (Sai số chuẩn - SE):
.
Quan sát Hình 16.4, ta thấy phân phối chọn mẫu không hề bị lệch trái như hay mẫu đơn lẻ! Trái lại, nó hoàn toàn đối xứng, mang hình quả chuông chuẩn tắc hoàn mỹ với độ phân tán cực kỳ hẹp quanh
Bộ ba bức tranh Thống kê (The Three Panels)
Hãy đặt ba khía cạnh của quá trình thống kê này cạnh nhau để so sánh trực diện:
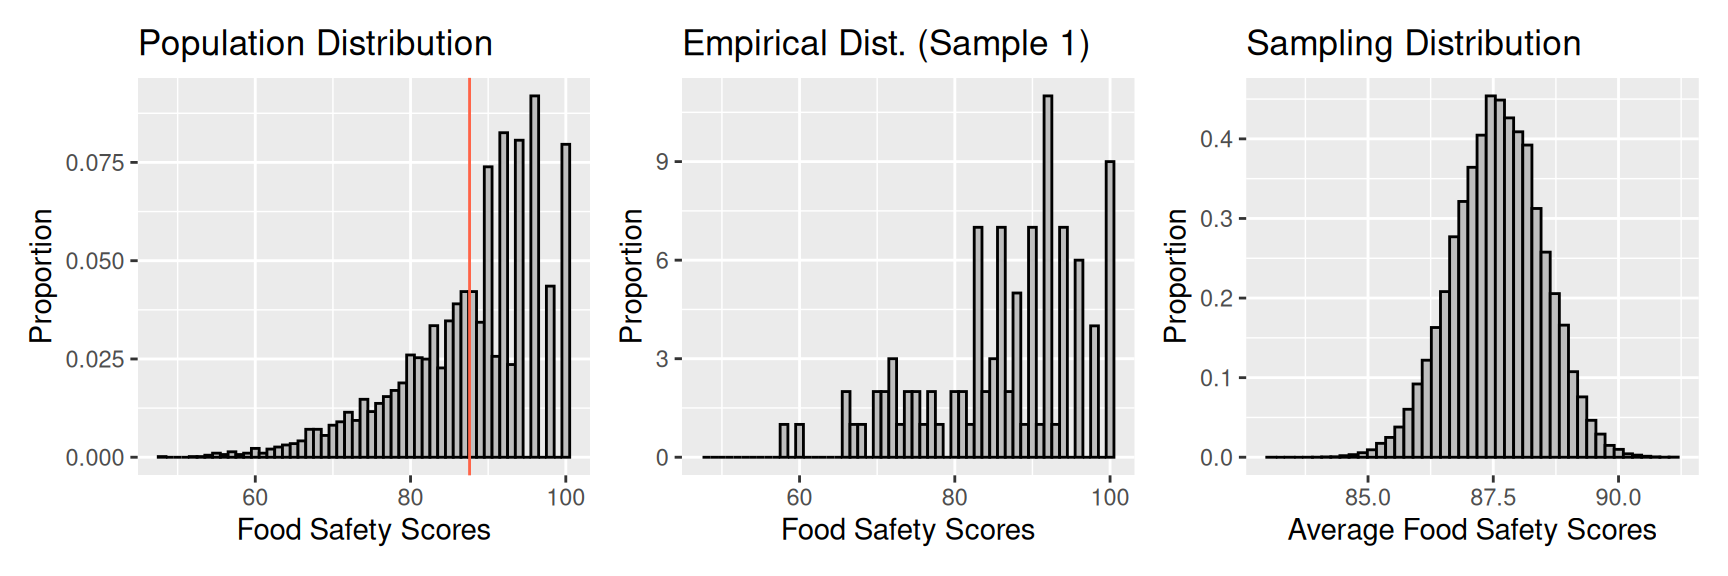
Hình 16.5: Bộ ba bức tranh thống kê: Phân phối tổng thể (trái), Phân phối thực nghiệm mẫu (giữa) và Phân phối chọn mẫu (phải).
| Đặc trưng | (Population) | Dữ liệu mẫu (Empirical Sample) | Phân phối chọn mẫu (Sampling Dist.) |
|---|---|---|---|
| Bản chất | Toàn bộ | Hàng nghìn thống kê | |
| Hình dạng | Lệch trái nặng | Lệch trái (giống ) | Dạng chuông đối xứng (Chuẩn Gauss) |
| Tâm (Trung bình) | |||
| Độ phân tán |
Ba quy luật nền tảng xuất hiện:
: Tâm của phân phối chọn mẫu luôn bằng đúng trung bình . : Sai số chuẩn tỉ lệ nghịch với căn bậc hai của cỡ mẫu. - Định lý Giới hạn Trung tâm: Dù lệch trái rõ rệt, phân phối chọn mẫu của trung bình mẫu
vẫn mang hình quả chuông chuẩn tắc đối xứng.
Bài toán thực tế: Khi ta chỉ nhìn thấy một bức tranh duy nhất
Trong thực tế nghiên cứu khoa học và kinh doanh, chúng ta không bao giờ có bức tranh và cũng không thể rút hàng trăm nghìn mẫu để vẽ phân phối chọn mẫu.
Chúng ta chỉ có duy nhất một bức tranh ở giữa: Một mẫu dữ liệu thực nghiệm duy nhất!
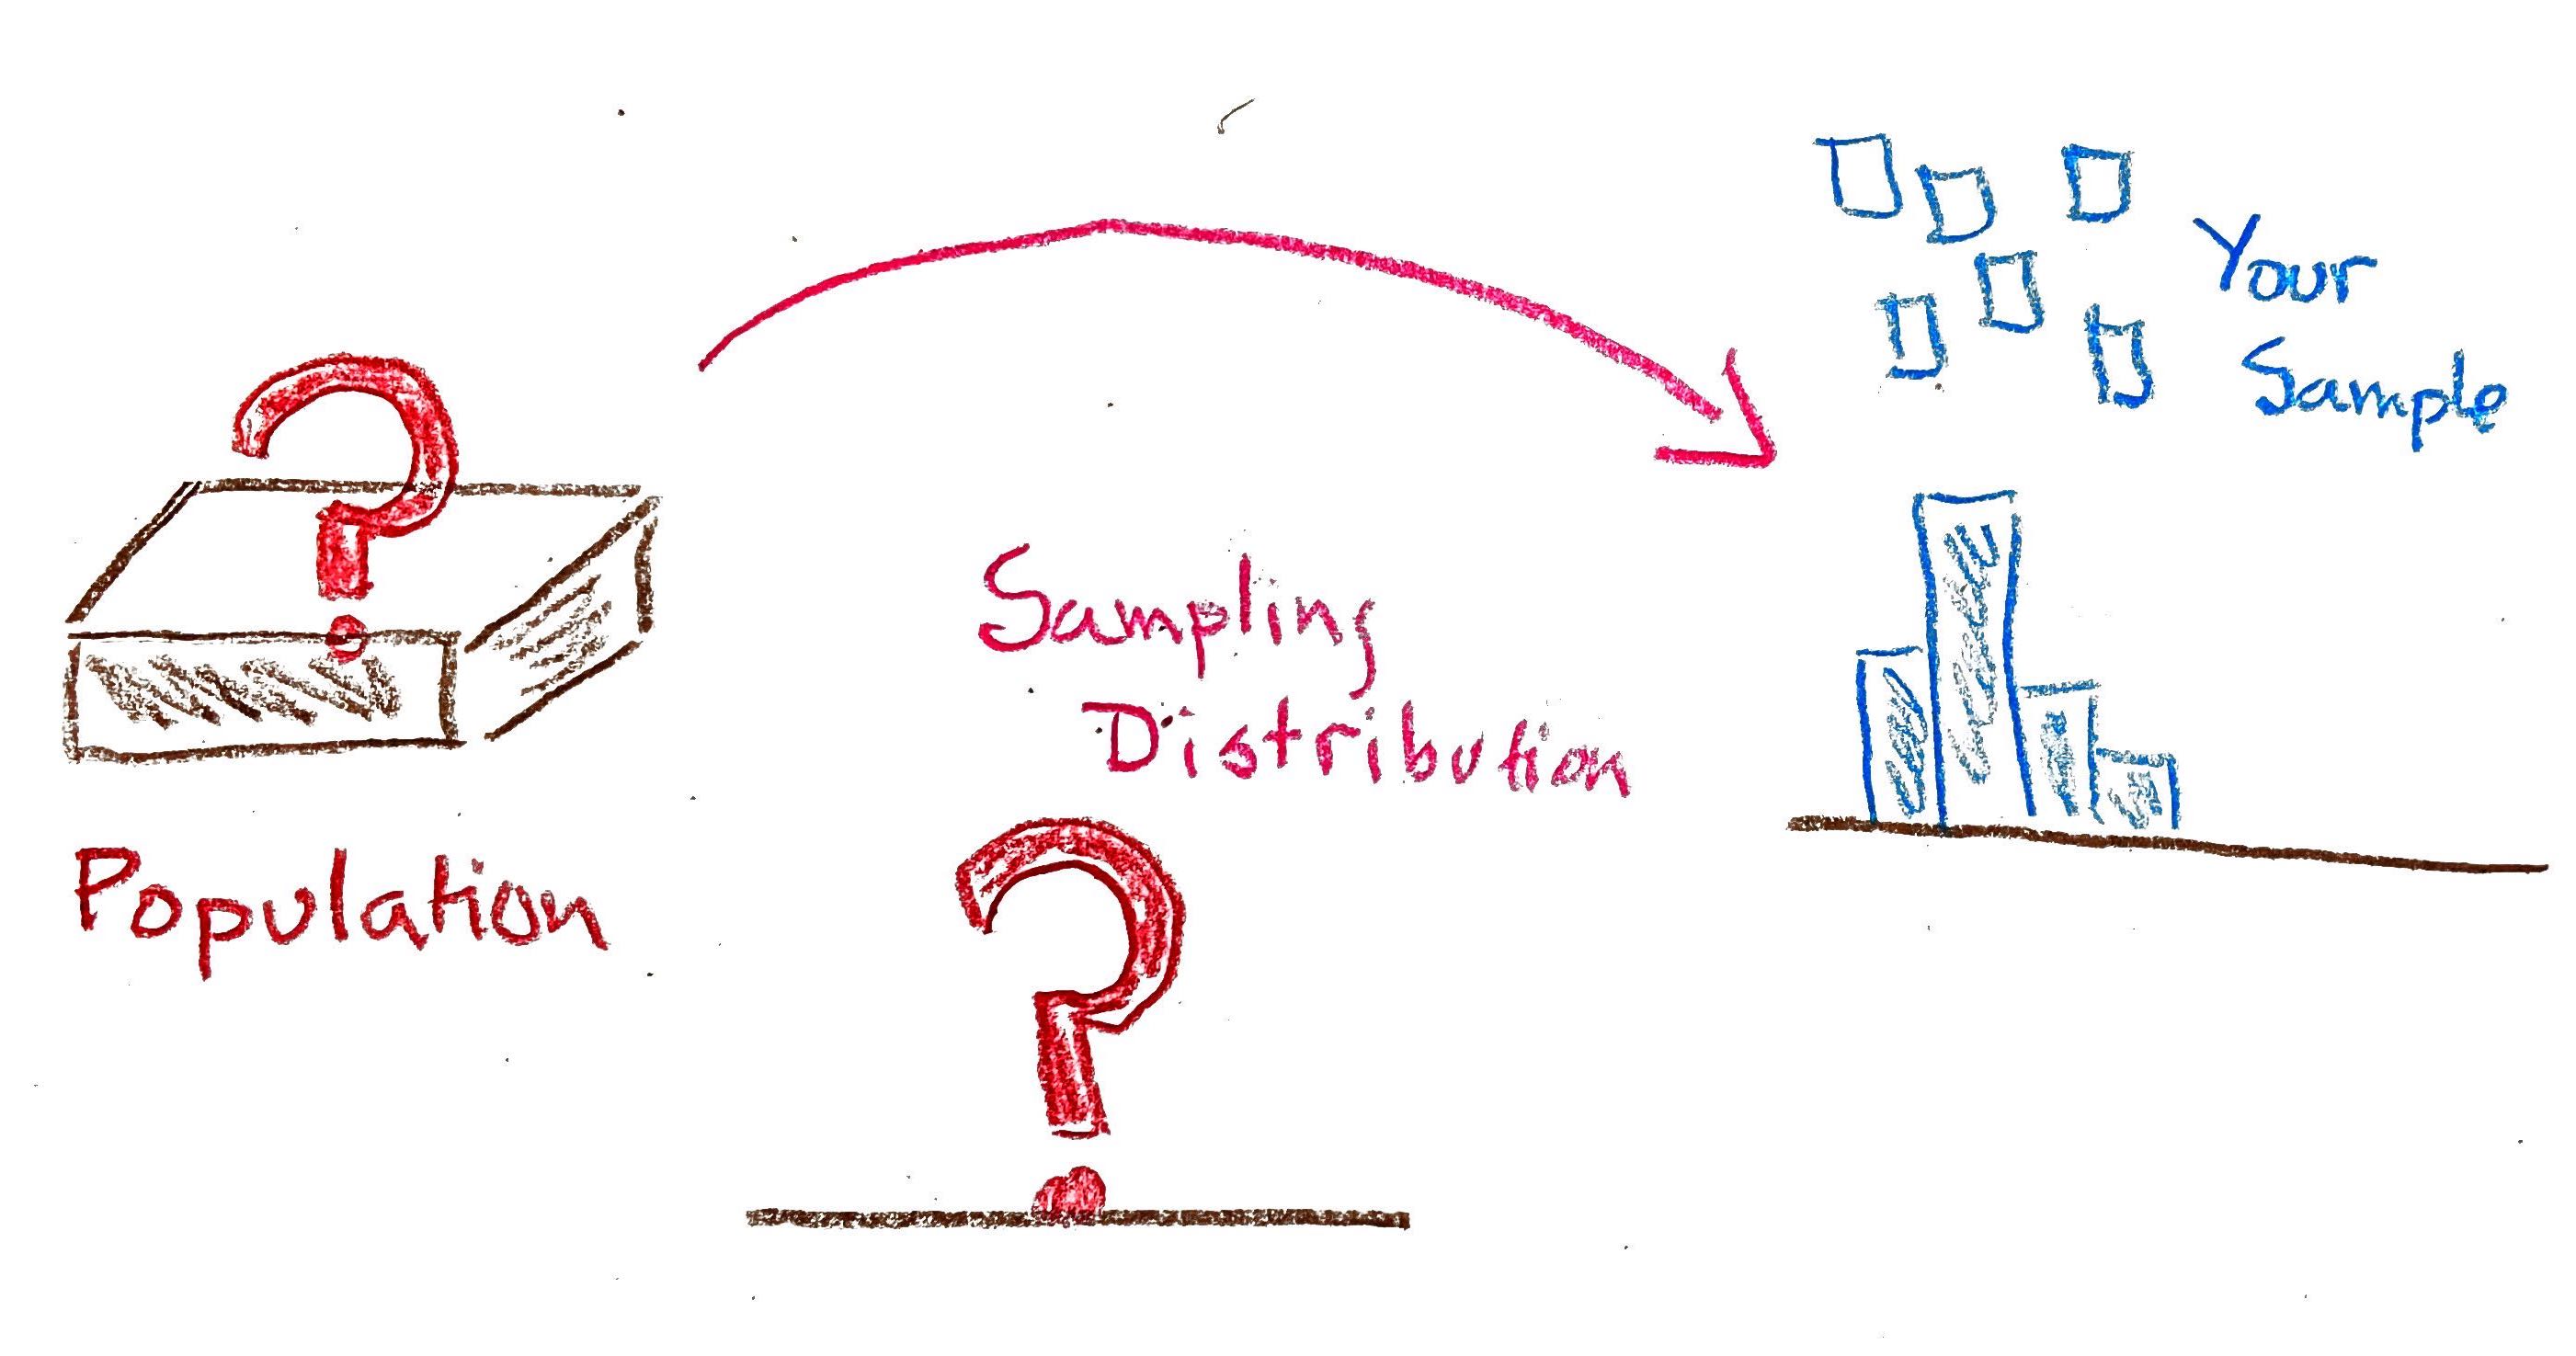
Hình 16.6: Thực tế nghiên cứu khoa học: Tổng thể và Phân phối chọn mẫu đều là những thực thể ẩn giấu, trong khi ta chỉ nắm giữ duy nhất một mẫu dữ liệu thực nghiệm.
Làm thế nào để suy diễn về tham số
Phép thế Thống kê (Statistical Substitution)
Lời giải đến từ chính mối quan hệ giữa ba bức tranh:
- Vì
tương đối lớn ( ), ta dùng làm ước lượng điểm (point estimate) cho : . - Vì mẫu mang tính đại diện, độ lệch chuẩn mẫu
xấp xỉ độ lệch chuẩn : . - Do đó, ta thay thế
bằng vào công thức sai số chuẩn:
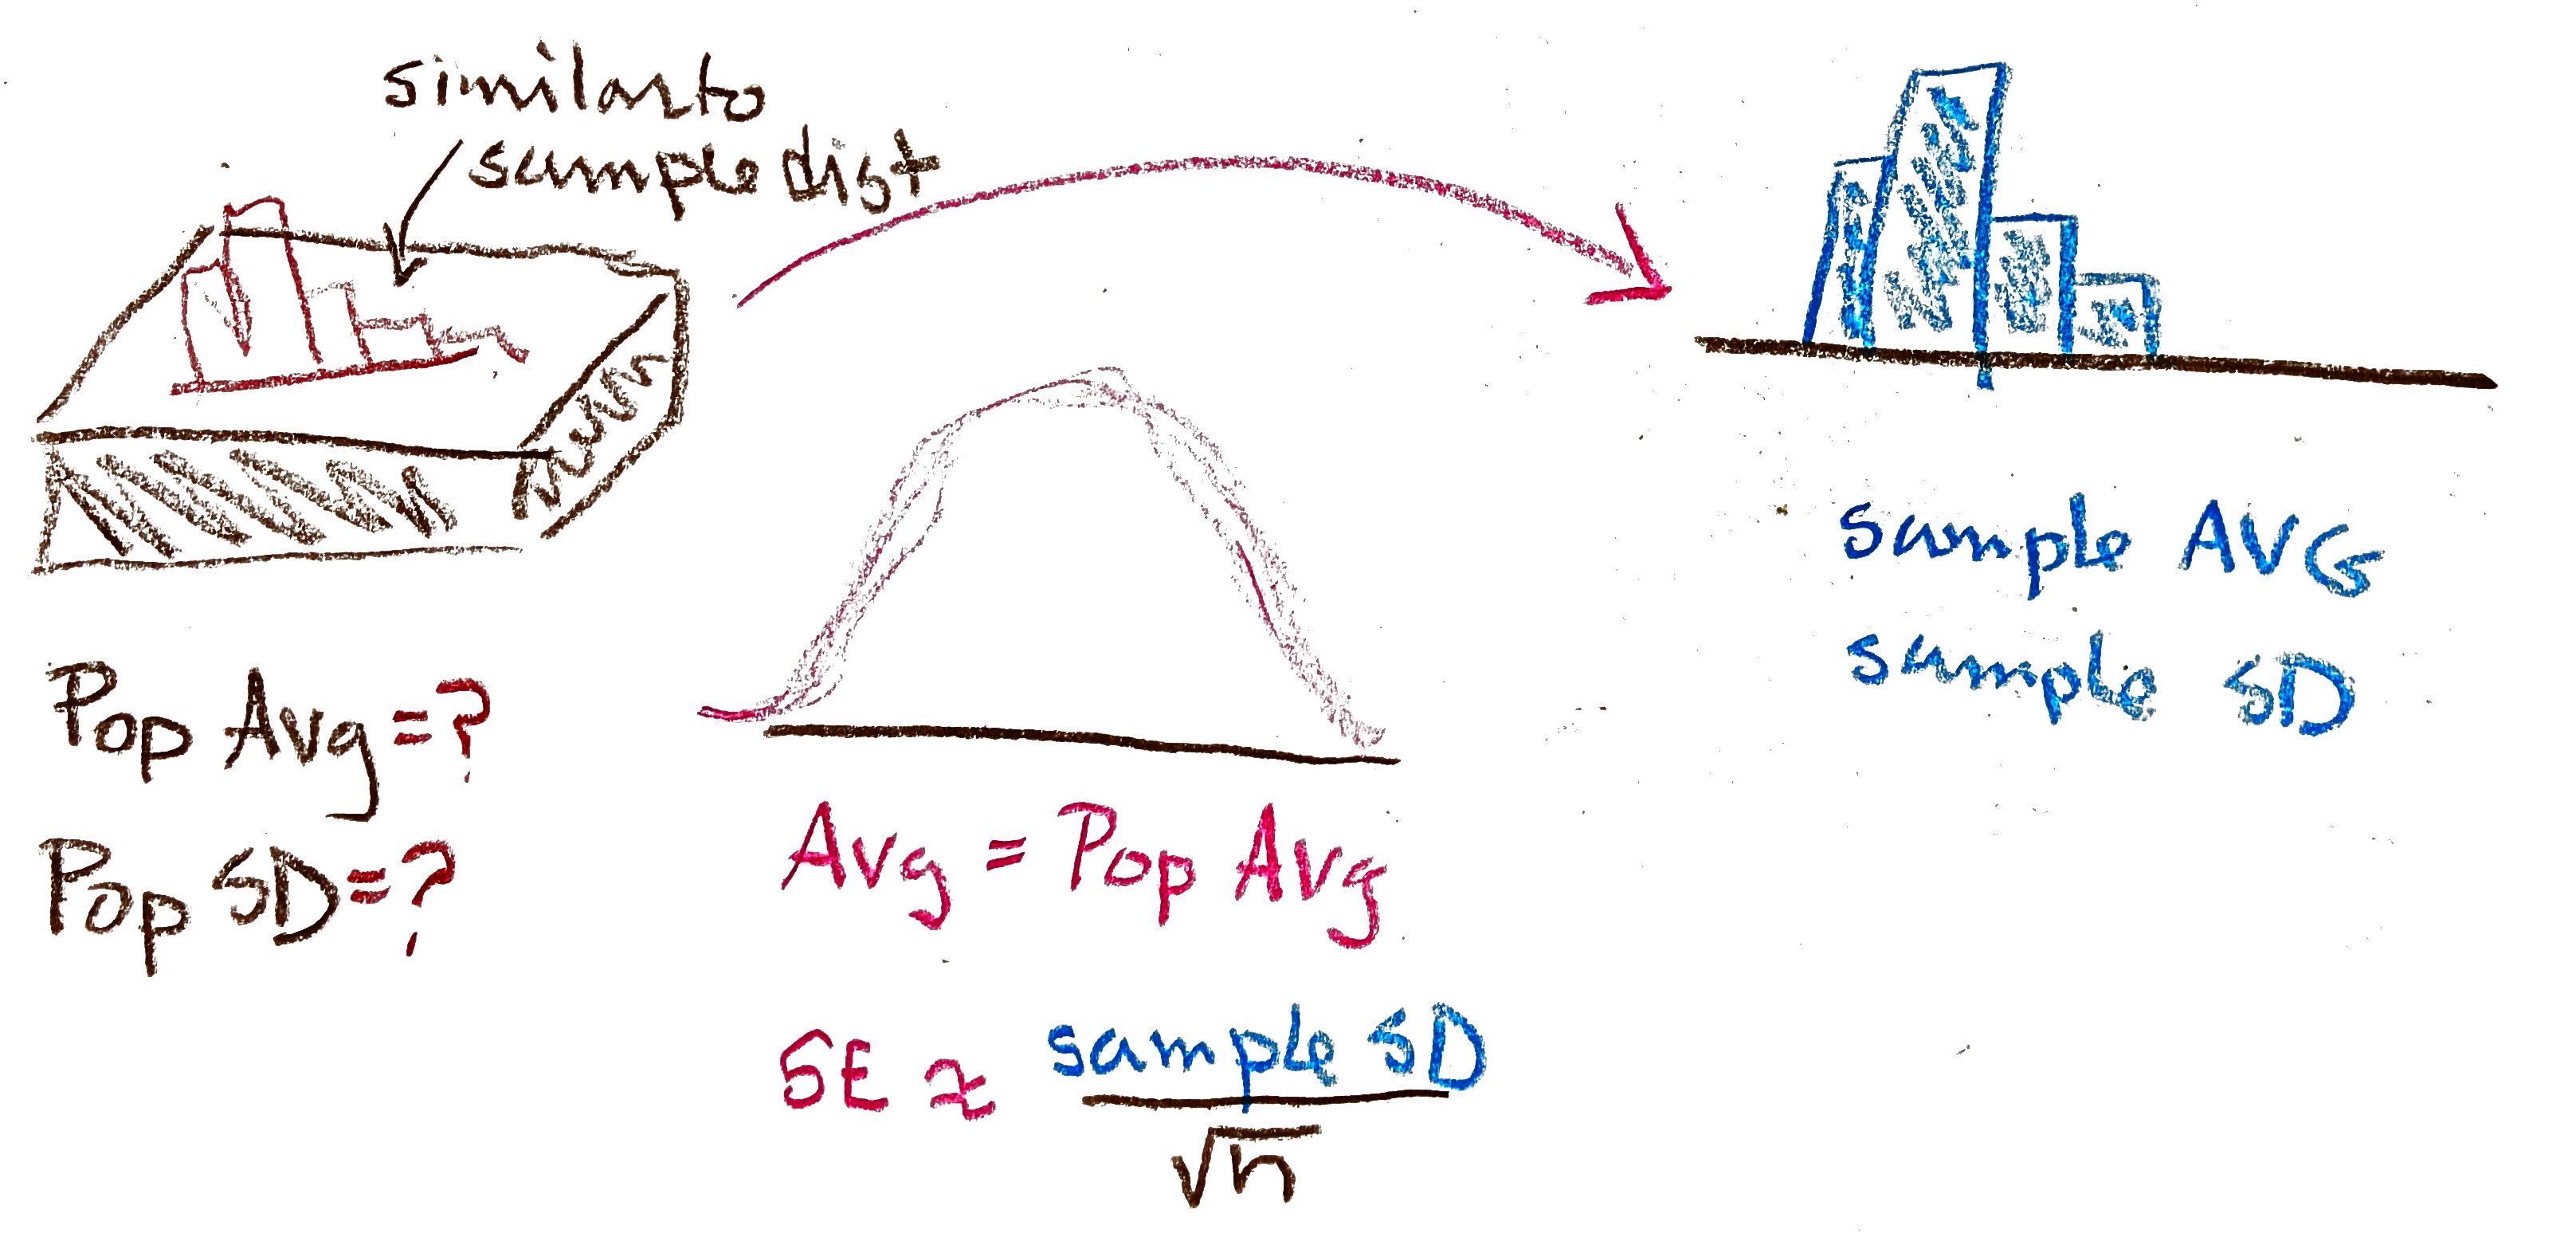
Hình 16.7: Nguyên lý thế thống kê: Sử dụng thống kê mẫu ($\bar{x}, s$) để lấp đầy những khoảng trống chưa biết trong phân phối chọn mẫu.
Trong nghiên cứu các nhà hàng San Francisco với mẫu
Nhà nghiên cứu có thể công bố: Dựa trên mẫu ngẫu nhiên 100 nhà hàng, điểm an toàn thực phẩm trung bình của thành phố ước lượng là
Cỡ mẫu, Quy mô Tổng thể và Độ chính xác
Một câu hỏi thường gặp: Giả sử một nhà nghiên cứu khác khảo sát 100 nhà hàng tại New York (nơi có hơn 50,000 nhà hàng). Liệu ước lượng của họ có kém chính xác hơn gấp nhiều lần vì New York lớn hơn San Francisco gấp hàng chục lần hay không?
Hãy quan sát bảng so sánh sai số chuẩn dưới đây:
| Quy mô ( | |||
|---|---|---|---|
::: important Quy luật về Quy mô và Cỡ mẫu
- Quy mô
hầu như không ảnh hưởng đến độ chính xác của ước lượng, miễn là cỡ mẫu nhỏ hơn nhiều so với tổng thể ( ). Một mẫu người tại New York cho độ chính xác tương đương một mẫu người tại San Francisco! - Độ chính xác chỉ phụ thuộc vào cỡ mẫu
: Mẫu có sai số chuẩn nhỏ bằng một nửa mẫu , tức là độ chính xác tăng gấp đôi, theo đúng quy luật . :::
(Lưu ý kỹ thuật: Khi lấy mẫu không hoàn lại mà
Xây dựng Khoảng tin cậy 95% (95% Confidence Interval)
Thay vì chỉ đưa ra một ước lượng điểm đơn độc
Nhờ Định lý Giới hạn Trung tâm, phân phối chọn mẫu có dạng phân phối chuẩn. Theo tính chất phân phối chuẩn, khoảng đối xứng chứa đúng
Biến đổi bất đẳng thức trên về tham số
Công thức: Khoảng tin cậy 95% cho Trung bình tổng thể
Khoảng tin cậy 95% cho trung bình
Áp dụng cho mẫu 100 nhà hàng San Francisco (
Phát biểu chuẩn mực học thuật: "Chúng ta tin tưởng 95% rằng điểm an toàn thực phẩm trung bình của toàn bộ các nhà hàng tại San Francisco nằm trong khoảng từ 84.3 đến 88.2 điểm".
Bản chất của "Độ tin cậy" (Confidence vs Probability)
Tại sao ta lại dùng từ "tin cậy" (confidence) mà không nói "xác suất để
Đây là một ranh giới khái niệm tối quan trọng:
- Tham số
là một hằng số cố định của tự nhiên, không phải là một biến ngẫu nhiên. Nó không hề di chuyển. - Khi mẫu dữ liệu đã được thu thập và khoảng
đã được tính ra, hai đầu mút của khoảng đã trở thành các con số cố định. - Do đó, khoảng cụ thể này hoặc chứa
, hoặc không chứa . Không còn bất kỳ sự may rủi nào ở đây. Xác suất để khoảng này chứa chỉ có thể là hoặc , chứ không phải .
Yếu tố ngẫu nhiên
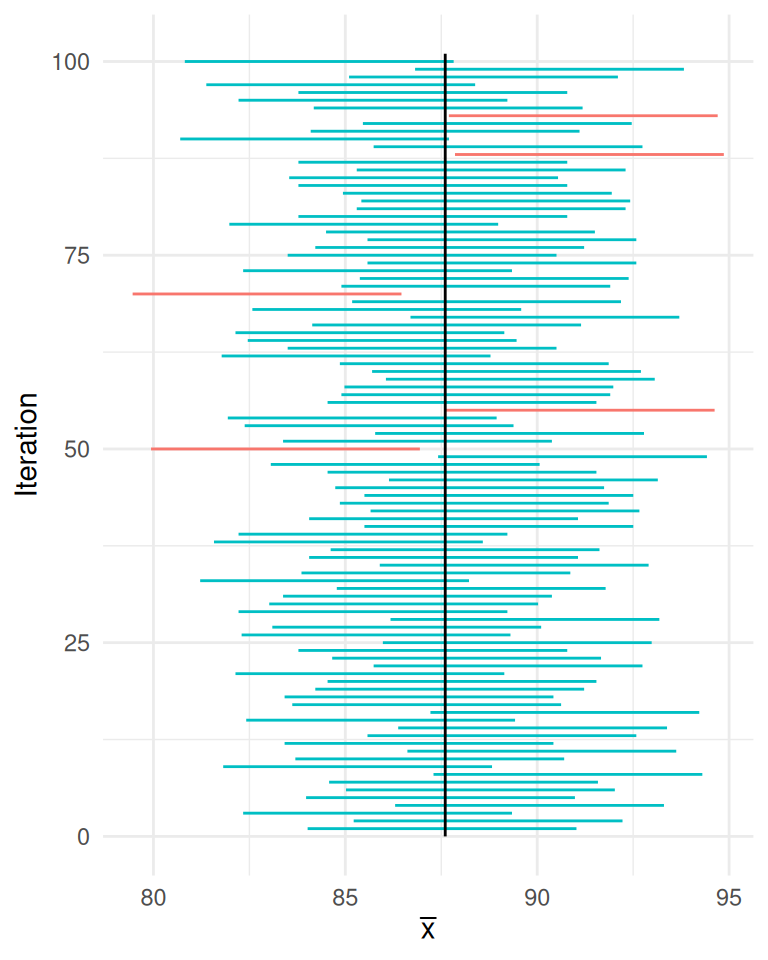
Hình 16.8: Mô phỏng 100 khoảng tin cậy 95% từ 100 mẫu ngẫu nhiên độc lập. Có đúng 95 khoảng bao phủ tham số thực $\mu$ (đường thẳng đứng màu đen) và 5 khoảng trượt ra ngoài.
Suy diễn cho Tỉ lệ Tổng thể (Population Proportion)
Phương pháp xây dựng khoảng tin cậy chuẩn tắc áp dụng tương tự cho tỉ lệ
Giả sử ta chỉ muốn đến ăn tại các nhà hàng có điểm an toàn thực phẩm "xuất sắc" (trên 95 điểm). Ta quan tâm đến tỉ lệ các nhà hàng đạt chuẩn xuất sắc trong toàn thành phố.
Đây là trường hợp của mô hình hộp 0-1:
- Mỗi nhà hàng được gán nhãn 1 (nếu điểm
) hoặc 0 (nếu điểm ). - Rút mẫu ngẫu nhiên
nhà hàng. Gọi là tỉ lệ nhà hàng đạt chuẩn xuất sắc trong mẫu. - Thống kê
thực chất là trung bình mẫu của các số 0 và 1: - Sai số chuẩn của tỉ lệ mẫu:
Công thức: Khoảng tin cậy 95% cho Tỉ lệ tổng thể
Ví dụ: Trong một mẫu
Khoảng tin cậy 95%:
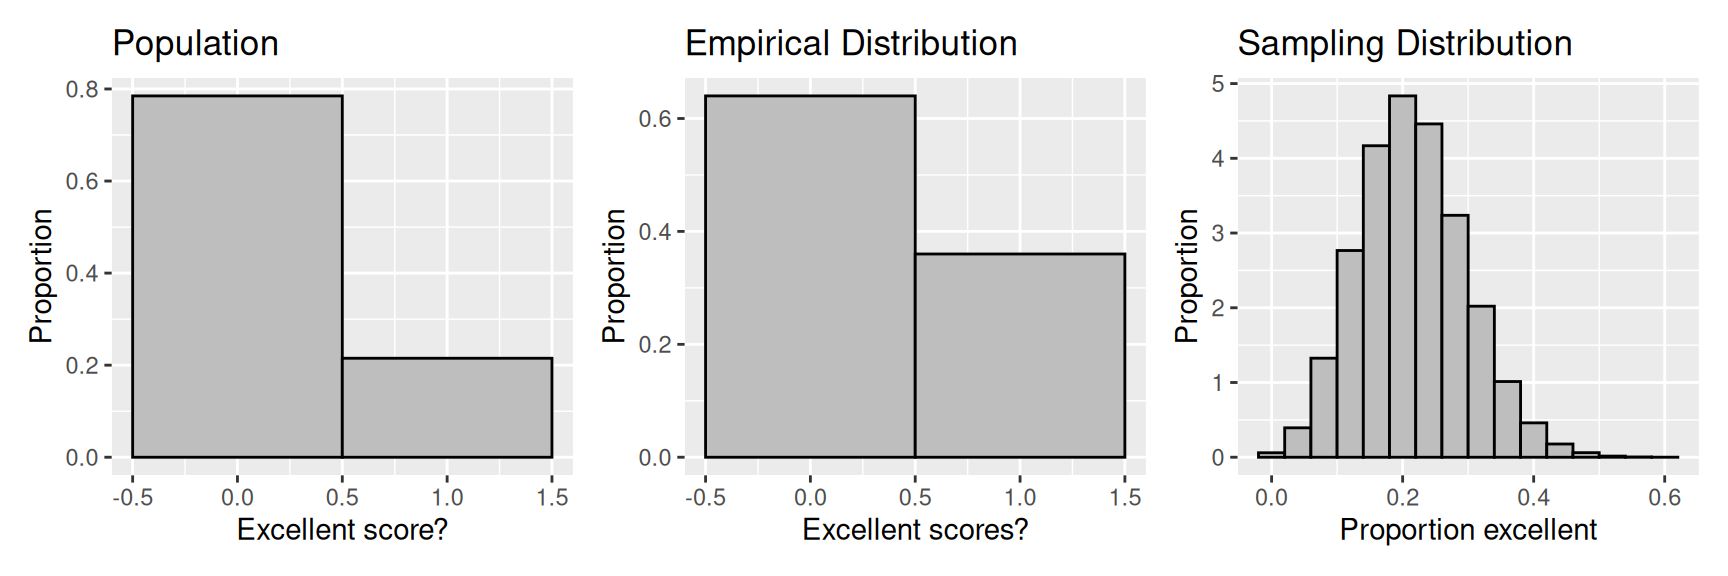
Hình 16.9: Bộ ba bức tranh cho bài toán ước lượng tỉ lệ: Hộp 0-1 của tổng thể (trái), mẫu dữ liệu (giữa) và phân phối chọn mẫu chuẩn tắc của tỉ lệ mẫu (phải).
Tóm tắt kiến thức cốt lõi
- Bộ ba bức tranh: Phân biệt rành mạch giữa Phân phối (chứa tham số
), Phân phối thực nghiệm mẫu (chứa thống kê ), và Phân phối chọn mẫu (chứa sai số chuẩn ). - Nguyên lý thế thống kê: Vì ta chỉ quan sát được một mẫu duy nhất, ta dùng
thay thế cho để ước lượng sai số chuẩn: . - Quy luật cỡ mẫu: Độ chính xác ước lượng tỉ lệ với
, không phụ thuộc vào quy mô (khi ). Muốn tăng độ chính xác lên gấp lần, phải tăng cỡ mẫu lên gấp lần. - Khoảng tin cậy 95%:
. Độ tin cậy 95% mô tả khả năng bao phủ tham số thực của quy trình lấy mẫu lặp lại trong dài hạn, không phải xác suất của một khoảng cố định cụ thể.
Bài tập rèn luyện
Bài tập 1: Ước lượng Thời gian Bay bằng Khoảng tin cậy 95%
Một nhà phân tích dữ liệu hàng không rút ngẫu nhiên một mẫu gồm
- Trung bình thời gian bay trong mẫu: Đạt
phút. - Độ lệch chuẩn trong mẫu: Đạt
phút.
- Tính sai số chuẩn ước lượng
của trung bình thời gian bay. - Xây dựng khoảng tin cậy 95% cho thời gian bay trung bình của toàn bộ các chuyến bay.
- Nhà phân tích muốn tăng độ chính xác của ước lượng lên gấp 3 lần (tức là giảm sai số chuẩn đi 3 lần). Hỏi cần phải thu thập một mẫu có kích thước bằng bao nhiêu?
Lời giải chi tiết
1. Tính sai số chuẩn ước lượng: Áp dụng công thức tính sai số chuẩn cho trung bình mẫu:
2. Xây dựng khoảng tin cậy 95%: Dựa trên xấp xỉ chuẩn tắc của Định lý Giới hạn Trung tâm, khoảng tin cậy 95% là:
Kết luận: Ta tin tưởng 95% rằng thời gian bay trung bình của toàn bộ các chuyến bay nằm trong khoảng từ
3. Xác định cỡ mẫu để tăng độ chính xác lên 3 lần: Độ chính xác của ước lượng tỉ lệ nghịch với sai số chuẩn. Muốn độ chính xác tăng gấp 3 lần, sai số chuẩn mới phải bằng
Bình phương hai vế:
Do đó, nhà phân tích cần khảo sát một mẫu gồm
Bài tập 2: Quy mô Tổng thể và Chi phí Sinh hoạt Gia đình
Một nhà kinh tế học muốn ước lượng chi phí mua sắm thực phẩm trung bình hằng tuần của mỗi hộ gia đình tại hai thành phố thuộc bang California:
- Thành phố Oakland: Quy mô dân số khoảng
hộ gia đình ( ). - Thành phố Fremont: Quy mô dân số khoảng
hộ gia đình ( ).
Giả sử độ lệch chuẩn về chi phí thực phẩm giữa các hộ gia đình ở cả hai thành phố là tương đương nhau (
- Khoảng tin cậy của Oakland sẽ rộng hơn, hẹp hơn hay có độ rộng tương đương so với khoảng tin cậy của Fremont? Giải thích cặn kẽ.
- Giả sử nghiên cứu được thực hiện tại hai thị trấn nhỏ: Thị trấn Grimes (
hộ) và Thị trấn Tranquility ( hộ), cùng lấy mẫu hộ tại mỗi thị trấn. Khi đó khoảng tin cậy của Tranquility sẽ rộng hơn hay hẹp hơn so với Grimes? Rộng hơn khoảng bao nhiêu phần trăm?
Lời giải chi tiết
1. So sánh độ rộng khoảng tin cậy giữa Oakland và Fremont: Tại cả hai thành phố, kích thước đều rất lớn (
Vì độ lệch chuẩn
2. Trường hợp hai thị trấn nhỏ Grimes và Tranquility: Ở hai thị trấn nhỏ này, cỡ mẫu
- Thị trấn Grimes:
. - Thị trấn Tranquility:
.
Bắt buộc phải áp dụng hệ số hiệu chỉnh hữu hạn
- Đối với Grimes (
): - Đối với Tranquility (
):
So sánh độ rộng khoảng tin cậy:
Khoảng tin cậy của Tranquility sẽ rộng hơn khoảng 8% (gần 10%) so với Grimes. Lý do là việc lấy mẫu
Bài tập 3: Phân tích các Phát biểu Ngộ nhận về Khoảng tin cậy
Sau khi khảo sát một mẫu ngẫu nhiên gồm 100 sinh viên tại một trường đại học, nhóm nghiên cứu công bố khoảng tin cậy 95% cho số giờ ngủ trung bình mỗi đêm của sinh viên là
Hãy đánh giá tính ĐÚNG / SAI về mặt khoa học của các phát biểu sau và giải thích cặn kẽ:
- "Có 95% sinh viên của trường đại học này ngủ từ 6.4 đến 7.2 giờ mỗi đêm".
- "Xác suất để số giờ ngủ trung bình của toàn bộ sinh viên trong trường nằm trong khoảng [6.4, 7.2] là 95%".
- "Nếu lặp lại cuộc khảo sát này nhiều lần với các mẫu ngẫu nhiên cùng cỡ mẫu 100, khoảng 95% các khoảng tin cậy được tính toán sẽ chứa số giờ ngủ trung bình thực sự của sinh viên".
Lời giải chi tiết
1. Phát biểu 1 là SAI HOÀN TOÀN:
- Khoảng tin cậy là ước lượng cho tham số trung bình của
, chứ không phải là khoảng chứa các cá thể sinh viên trong trường. - Phân phối của từng cá nhân sinh viên có độ biến thiên lớn hơn nhiều (được đo bởi
), trong khi khoảng tin cậy dao động theo sai số chuẩn của trung bình mẫu ( nhỏ hơn rất nhiều). Do đó, khoảng không thể chứa số sinh viên của trường.
2. Phát biểu 2 là SAI VỀ MẶT BẢN CHẤT XÁC SUẤT:
- Tham số trung bình của toàn trường
là một hằng số xác định (dù ta chưa biết giá trị chính xác). Khoảng cũng là một khoảng với hai đầu mút cố định sau khi đã tính toán từ dữ liệu mẫu. - Một hằng số cố định nằm trong một khoảng cố định thì không còn tính ngẫu nhiên: Nó hoặc nằm trong đó (xác suất bằng 1) hoặc không nằm trong đó (xác suất bằng 0). Việc gán xác suất
cho một biến cố đã hoàn thành là ngộ nhận triết học thống kê phổ biến.
3. Phát biểu 3 là ĐÚNG CHUẨN MỰC HỌC THUẬT:
- Đây là định nghĩa và cách diễn giải chính xác duy nhất của mức độ tin cậy
: Độ tin cậy là thuộc tính của quy trình suy diễn trong dài hạn. - Nếu tiến hành lặp lại quy trình lấy mẫu ngẫu nhiên độc lập 100 lần và tính 100 khoảng tin cậy khác nhau, thì trung bình sẽ có khoảng 95 khoảng bao bọc đúng tham số thực
.
Tài liệu tham khảo
- UC Berkeley STAT 20: Introduction to Probability and Statistics, Department of Statistics, UC Berkeley.
- Freedman, D., Pisani, R., & Purves, R. (2007). Statistics (4th ed.). W. W. Norton & Company.