Giao diện
1. Giới thiệu: Khi phương pháp đúng vẫn dẫn đến kết luận sai
Kiểm định giả thuyết thống kê là một công cụ suy luận chặt chẽ, song bản chất của nó không phải là một chiếc chìa khóa vạn năng đảm bảo tính đúng đắn tuyệt đối. Ngay cả khi nhà phân tích tuân thủ chuẩn xác mọi quy chuẩn toán học, từ việc phát biểu giả thuyết không bị lệch lạc cho đến tính toán
Nguyên nhân cốt lõi nằm ở chỗ: Ta buộc phải đưa ra một phán quyết mang tính nhị phân (chấp nhận duy trì hay bác bỏ giả thuyết không
- Giả thuyết không
: Bị cáo hoàn toàn vô tội (nguyên tắc suy đoán vô tội). - Giả thuyết đối
: Bị cáo thực sự có tội. - Bồi thẩm đoàn chỉ có hai phán quyết: Tuyên có tội (bác bỏ
) hoặc tuyên vô tội / không đủ bằng chứng kết tội (không bác bỏ ).
Trong hệ thống tư pháp, một người vô tội có thể bị kết án oan, hoặc một kẻ phạm tội thực sự có thể được tha bổng do thiếu chứng cứ. Điểm ưu việt của thống kê học so với phiên tòa thông thường là: Khuôn khổ toán học cho phép ta định lượng và kiểm soát chủ động xác suất xảy ra các sai lầm này ngay từ khâu thiết kế nghiên cứu.
2. Hai loại sai lầm thống kê (Statistical Errors)
Trong kiểm định giả thuyết thống kê, ta đặt lên bàn cân hai giả thuyết đối nghịch: Giả thuyết không
Khi đối chiếu quyết định thống kê với chân lý khách quan trong tự nhiên, ta thu được bốn tình huống khả dĩ:
| Chân lý khách quan | Phán quyết: Bác bỏ | Phán quyết: Không bác bỏ |
|---|---|---|
| Sai lầm loại I (Dương tính giả) Xác suất | Quyết định đúng đắn (Độ đặc hiệu) Xác suất | |
| Quyết định đúng đắn (Lực kiểm định) Xác suất | Sai lầm loại II (Âm tính giả) Xác suất |
Sai lầm loại I (Type I Error / False Positive)
- Định nghĩa: Là hành vi bác bỏ giả thuyết không
trong khi thực sự đúng trong tự nhiên. - Tên gọi khác: Dương tính giả (False Positive) hoặc cảnh báo nhầm.
- Ẩn dụ phòng xử án: Tòa án tuyên bị cáo có tội và kết án tù, trong khi người này hoàn toàn vô tội.
- Xác suất xảy ra: Ký hiệu là
(chính là mức ý nghĩa của kiểm định).
Sai lầm loại II (Type II Error / False Negative)
- Định nghĩa: Là hành vi không bác bỏ giả thuyết không
trong khi thực chất giả thuyết đối mới là sự thật. - Tên gọi khác: Âm tính giả (False Negative) hoặc bỏ sót hiệu ứng.
- Ẩn dụ phòng xử án: Tòa án tuyên trả tự do cho bị cáo vì thiếu bằng chứng, mặc dù người này thực chất là kẻ phạm tội.
- Xác suất xảy ra: Ký hiệu là
.
Đánh đổi tất yếu giữa hai loại sai lầm
Nếu ta muốn giảm thiểu sai lầm loại I trong tòa án (tức là không bao giờ kết án oan người vô tội), ta buộc phải nâng chuẩn mực chứng cứ lên cực cao: Phải có bằng chứng video sắc nét, ADN trùng khớp tuyệt đối, nhiều nhân chứng chứng kiến. Khi chuẩn mực bị đẩy lên quá khắt khe, hầu hết tội phạm tinh vi sẽ không đủ bằng chứng để kết tội, dẫn đến sai lầm loại II tăng vọt (bỏ lọt tội phạm).
Ngược lại, nếu ta muốn hạ thấp sai lầm loại II (tức là kiên quyết không bỏ sót bất kỳ kẻ phạm tội nào), ta sẽ hạ thấp chuẩn mực chứng cứ: Chỉ cần một nghi vấn nhỏ là kết án. Hậu quả tất yếu là số lượng người vô tội bị kết án oan (sai lầm loại I) sẽ tăng vọt.
Quy luật đánh đổi:
Với một dung lượng mẫu cố định, việc giảm xác suất sai lầm loại này tất yếu sẽ kéo theo sự gia tăng xác suất sai lầm loại kia. Cách duy nhất để đồng thời giảm cả hai loại sai lầm là thu thập thêm dữ liệu (tăng kích thước mẫu
3. Mức ý nghĩa
Ngưỡng xác suất dùng để đưa ra phán quyết bác bỏ
Theo quy ước truyền thống do Ronald Fisher đề xuất vào thập niên 1920, giá trị
- Khi nào nên chọn mức ý nghĩa rất nhỏ (
hoặc )? - Khi cái giá phải trả của sai lầm loại I là đắt đỏ hoặc gây nguy hiểm tính mạng.
- Ví dụ: Cấp phép một loại thuốc mới có độc tính cao hoặc triển khai dự án đầu tư hàng chục tỷ đô la có nguy cơ phá sản. Khi đó, ta đòi hỏi bằng chứng ủng hộ
phải vượt trội hoàn toàn trước khi quyết định bác bỏ .
- Khi nào có thể chấp nhận mức ý nghĩa nới lỏng hơn (
)? - Khi cái giá phải trả của sai lầm loại II nghiêm trọng hơn nhiều so với sai lầm loại I.
- Ví dụ: Hệ thống sàng lọc chẩn đoán sớm ung thư giai đoạn đầu hoặc cảnh báo rò rỉ khí độc trong hầm mỏ. Nếu báo động nhầm (sai lầm loại I), cơ sở chỉ mất chi phí xét nghiệm lại, trái lại nếu bỏ sót một ca bệnh hiểm nghèo hoặc bỏ sót rò rỉ khí độc (sai lầm loại II), hậu quả sẽ là tử vong. Do đó, ta sẵn sàng chấp nhận mức
cao hơn để tối đa hóa độ nhạy phát hiện.
4. Nghiên cứu thực nghiệm: Thuốc làm tan huyết khối sau hô hấp nhân tạo (CPR)
Để thấy rõ cơ chế vận hành của sai lầm thống kê, hãy cùng phân tích một nghiên cứu y khoa thực tế về hiệu quả của thuốc làm tan huyết khối đối với bệnh nhân ngừng tim.
Hô hấp nhân tạo (CPR) là biện pháp ép tim ngoài lồng ngực khẩn cấp khi người bệnh bị ngừng tim đột ngột ngoài bệnh viện. Dù cứu sống nhiều nạn nhân, các động tác ép tim thô bạo thường gây ra các chấn thương nội tạng và dập mô kín. Khi bệnh nhân được đưa đến bệnh viện cấp cứu, các bác sĩ đứng trước một quyết định sinh tử: Liệu có nên tiêm thuốc làm tan huyết khối (blood thinner) để khơi thông động mạch vành hay không?
- Một mặt, thuốc làm tan huyết khối giúp thông mạch máu nuôi tim, tăng cơ hội sống sót.
- Mặt khác, thuốc lại làm mất khả năng đông máu tự nhiên, có thể gây xuất huyết nội tạng trầm trọng từ chính các vết thương dập do CPR trước đó, dẫn đến tử vong nhanh hơn.
Dữ liệu thử nghiệm lâm sàng
Thử nghiệm ngẫu nhiên có đối chứng được tiến hành trên
- Nhóm đối chứng (Control): Không sử dụng thuốc làm tan huyết khối (
). - Nhóm can thiệp (Treatment): Có sử dụng thuốc làm tan huyết khối (
).
Biến số kết cục là việc bệnh nhân có sống sót qua 24 giờ đầu tiên hay không. Kết quả ghi nhận tại bệnh viện như sau:
| Phân nhóm bệnh nhân | Tử vong | Sống sót | Tổng số | Tỉ lệ sống sót quan sát ( |
|---|---|---|---|---|
| Nhóm đối chứng (Control) | 39 | 11 | 50 | |
| Nhóm can thiệp (Treatment) | 26 | 14 | 40 | |
| Tổng cộng | 65 | 25 | 90 |
Chênh lệch tỉ lệ sống sót quan sát được giữa hai nhóm là:
Con số
Thiết lập giả thuyết và nguyên tắc kiểm định hai phía
Vì thuốc có thể vừa có tiềm năng cứu mạng vừa có nguy cơ gây xuất huyết dẫn đến tử vong, ta bắt buộc phải mở rộng nhận thức đối với cả hai chiều biến thiên:
Nếu giả thuyết không
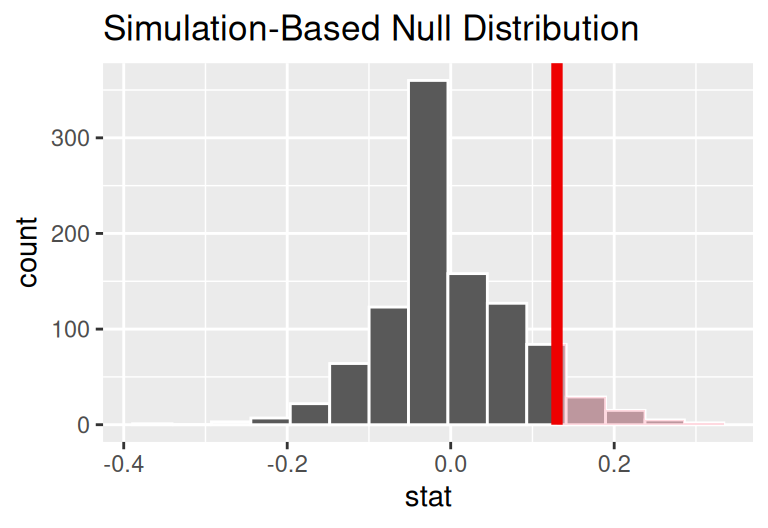 Hình 20.1: Phân phối giả thuyết không của chênh lệch tỉ lệ
Trong Hình 20.1, diện tích đuôi phải tương ứng với các giá trị chênh lệch
Định nghĩa chuẩn mực của
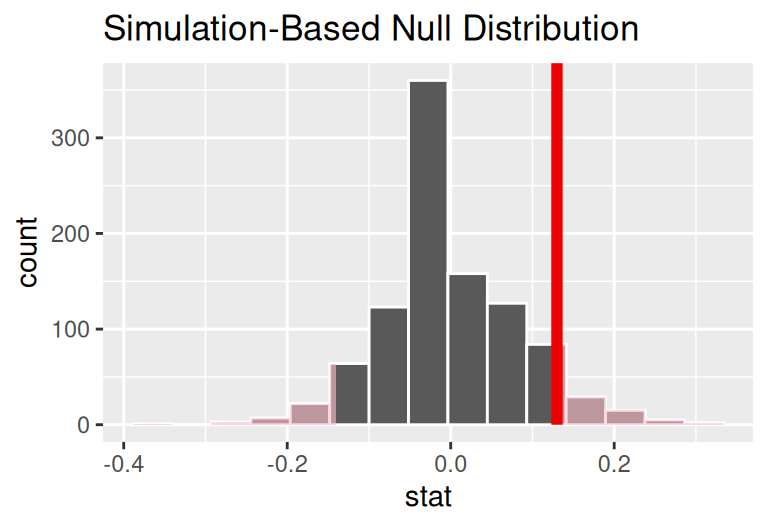 Hình 20.2: Trực quan hóa
Để tính
Vì
5. Cạm bẫy đổi kiểm định sau khi xem dữ liệu: Nhân đôi sai lầm loại I
Một sai sót phương pháp luận vô cùng phổ biến là việc nhà nghiên cứu chuyển đổi tùy tiện từ kiểm định hai phía sang kiểm định một phía sau khi đã quan sát dữ liệu.
Hãy hình dung tình huống sau: Một nhà nghiên cứu ban đầu quan sát thấy
Khi đó, họ chỉ tính diện tích một đuôi phải (
Hậu quả toán học của hành vi này là gì?
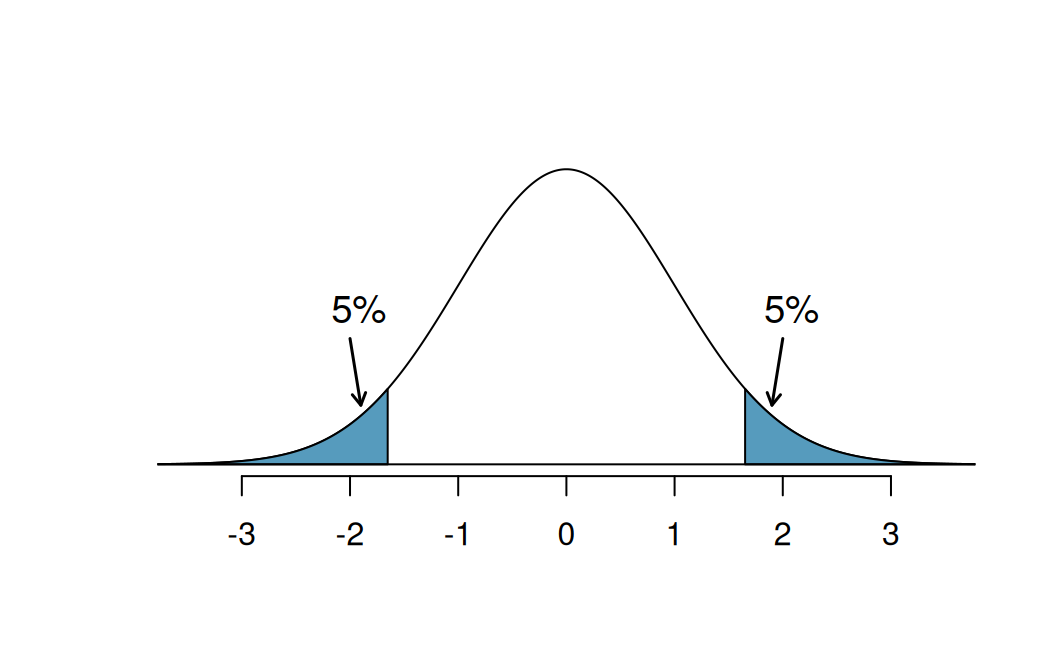 Hình 20.3: Nguy cơ nhân đôi sai lầm loại I khi chọn hướng kiểm định một phía dựa trên chiều quan sát được của dữ liệu.
Quan sát Hình 20.3:
- Nếu chênh lệch mẫu rơi vào vùng dương, nhà nghiên cứu chọn đuôi phải với mức ý nghĩa
. - Nếu chênh lệch mẫu rơi vào vùng âm, nhà nghiên cứu lại chọn đuôi trái với mức ý nghĩa
. - Tổng xác suất bác bỏ nhầm
khi thực sự đúng trên thực tế sẽ là:
Bài học phương pháp luận tối thượng:
Việc "đổi phe" hoặc chọn giả thuyết một phía sau khi đã nhìn thấy dữ liệu sẽ làm tăng gấp đôi xác suất mắc sai lầm loại I so với mức công bố danh nghĩa (
6. Lực kiểm định (Statistical Power) và Cỡ mẫu
Khi lập kế hoạch cho một nghiên cứu thực nghiệm, các nhà khoa học luôn phải dung hòa hai áp lực trái ngược:
- Cần thu thập đủ dữ liệu để phát hiện ra hiệu ứng thực sự nếu nó tồn tại.
- Chi phí thu thập dữ liệu (ngân sách, thời gian, số lượng động vật thí nghiệm, sức khỏe của người bệnh) có hạn và cần được tối thiểu hóa.
Để giải quyết bài toán tối ưu này, thống kê học đưa ra khái niệm Lực kiểm định (Statistical Power).
Khái niệm Lực kiểm định
- Định nghĩa: Lực kiểm định là xác suất bác bỏ thành công giả thuyết không
khi giả thuyết đối thực sự đúng. - Mối liên hệ toán học: Vì sai lầm loại II có xác suất là
(bỏ sót khi đúng), nên lực kiểm định chính là biến cố bù của sai lầm loại II:
Ba yếu tố quyết định lực kiểm định
Lực kiểm định của một bài toán phụ thuộc chặt chẽ vào ba thông số:
- Kích thước hiệu ứng thực tế (Effect Size): Nếu một loại thuốc giảm tỉ lệ tử vong từ
xuống (hiệu ứng khổng lồ), ta chỉ cần cỡ mẫu rất nhỏ cũng dễ dàng phát hiện ra. Nhưng nếu thuốc chỉ giảm từ xuống , ta cần một mẫu cực lớn mới có thể phân biệt được tín hiệu đó với nhiễu ngẫu nhiên. - Kích thước mẫu (
): Cỡ mẫu càng lớn, sai số chuẩn của đại lượng thống kê càng thu hẹp lại, phân phối mẫu dưới và dưới càng tách rời nhau rõ rệt, giúp đẩy lực kiểm định lên cao. - Mức ý nghĩa lựa chọn (
): Việc nới lỏng (ví dụ từ lên ) mở rộng miền bác bỏ, giúp tăng lực kiểm định (nhưng đổi lại là tăng rủi ro sai lầm loại I).
Đạo đức khoa học trong thiết kế cỡ mẫu
Xét ví dụ thử nghiệm thuốc ức chế khối u trên chuột bạch:
- Nếu nghiên cứu có lực kiểm định quá thấp (Underpowered Study): Chẳng hạn cỡ mẫu chỉ có 10 con chuột, dẫn đến lực kiểm định chỉ đạt
. Điều này có nghĩa là ngay cả khi thuốc có tác dụng thật, có tới khả năng nghiên cứu sẽ kết luận "không thấy hiệu ứng". Hàng chục con chuột bị hi sinh vô ích mà không mang lại đóng góp tri thức nào cho y học. Thiết kế này bị coi là vi phạm đạo đức nghiên cứu. - Nếu nghiên cứu lạm dụng cỡ mẫu quá mức: Dùng tới 100,000 con chuột để đạt lực kiểm định
. Việc này gây lãng phí khổng lồ về tài chính và sinh mạng động vật một cách không cần thiết, trong khi một cỡ mẫu 300 con có thể đã đạt lực kiểm định chuẩn mực hoặc .
Nguyên tắc đọc hiểu nghiên cứu:
"Sự vắng mặt của bằng chứng không đồng nghĩa với bằng chứng của sự vắng mặt" (Absence of evidence is not evidence of absence). Khi một nghiên cứu đưa ra kết luận
7. Mở rộng tư duy: Bẫy so sánh bội (Multiple Testing) và Hiệu chỉnh Bonferroni
Khi phân tích dữ liệu hiện đại, đặc biệt trong thời đại Big Data, tin sinh học và trí tuệ nhân tạo, các nhà phân tích thường không chỉ kiểm định một giả thuyết đơn lẻ mà kiểm định hàng trăm, thậm chí hàng triệu giả thuyết đồng thời (ví dụ: So sánh biểu hiện của
Điều gì sẽ xảy ra nếu ta vẫn áp dụng ngưỡng
Giả sử ta thực hiện
- Xác suất một phép thử đưa ra kết luận đúng (không bác bỏ
) là: - Xác suất để cả
phép thử đều không mắc sai lầm là: - Do đó, xác suất để có ít nhất một kết luận dương tính giả (Family-Wise Error Rate - FWER) là:
Hãy nhìn vào bảng số liệu dưới đây:
| Số lượng phép thử ( | Xác suất có ít nhất một dương tính giả |
|---|---|
| 1 | |
| 5 | |
| 10 | |
| 20 | |
| 50 | |
| 100 |
Chỉ với 20 phép thử độc lập hoàn toàn ngẫu nhiên, xác suất bắt gặp một kết quả "có ý nghĩa thống kê giả mạo" đã lên tới hơn
Giải pháp: Hiệu chỉnh Bonferroni (Bonferroni Correction)
Để kiểm soát tỉ lệ sai lầm loại I tích lũy trên toàn bộ họ phép thử ở mức mong muốn
Ví dụ: Nếu thực hiện
8. Tóm tắt bài học
- Kiểm định giả thuyết là một quy trình ra quyết định nhị phân có kiểm soát rủi ro, nhưng không thể loại trừ hoàn toàn sai số ngẫu nhiên.
- Sai lầm loại I (
): Bác bỏ khi đúng (Dương tính giả). Được kiểm soát bằng mức ý nghĩa . - Sai lầm loại II (
): Không bác bỏ khi đúng (Âm tính giả). - Lực kiểm định (
): Khả năng phát hiện hiệu ứng thực. Tăng lên khi tăng cỡ mẫu hoặc khi hiệu ứng thực tế lớn. - Luôn mặc định kiểm định hai phía. Việc chuyển sang kiểm định một phía sau khi đã nhìn thấy dữ liệu sẽ làm nhân đôi xác suất sai lầm loại I thực tế.
- Trong các bài toán kiểm định nhiều giả thuyết đồng thời, bắt buộc phải sử dụng các kỹ thuật hiệu chỉnh mức ý nghĩa như Bonferroni để phòng ngừa bẫy so sánh bội.
Tài liệu tham khảo
- Çetinkaya-Rundel, M., & Hardin, J. (2021). Introduction to Modern Statistics (1st ed.). OpenIntro Project.
- Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd, Edinburgh.
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Gelman, A., & Loken, E. (2014). The statistical crisis in science: Data-dependent analysis (a "garden of forking paths") explains why many statistically significant findings don't hold up. American Scientist, 102(6), 460–465.
Bài tập tự luyện
Bài tập 1: Ma trận sai lầm và lực kiểm định trong kiểm định công nghiệp
Một tập đoàn sản xuất pin xe điện thiết lập quy trình kiểm tra chất lượng tự động trước khi đóng gói xuất xưởng. Giả thuyết kiểm định được đặt ra cho mỗi lô pin như sau:
: Lô pin đạt chuẩn chất lượng an toàn (tỉ lệ lỗi cell pin ). : Lô pin không đạt chuẩn an toàn, có nguy cơ quá nhiệt gây cháy nổ (tỉ lệ lỗi ).
Yêu cầu:
- Hãy mô tả cụ thể bản chất của Sai lầm loại I và Sai lầm loại II trong bối cảnh thực tế này.
- Giả sử hậu quả của một vụ cháy nổ xe điện là sự đe dọa sinh mạng người dùng và thiệt hại hàng tỷ USD tiền bồi thường, trong khi chi phí tiêu hủy một lô pin đạt chuẩn bị kết luận nhầm là vài ngàn USD. Ban quản lý chất lượng nên điều chỉnh mức ý nghĩa
theo hướng tăng lên hay giảm đi? Hãy giải thích dựa trên mối quan hệ đánh đổi giữa và . - Định nghĩa lực kiểm định (Statistical Power) trong bài toán này và nêu phương án duy nhất để nâng cao lực kiểm định mà không làm tăng nguy cơ sai lầm loại I.
Lời giải chi tiết
1. Mô tả hai loại sai lầm trong bối cảnh kiểm định pin:
- Sai lầm loại I (Dương tính giả): Là việc bác bỏ
khi thực sự đúng. Cụ thể: Lô pin thực tế hoàn toàn đạt chuẩn an toàn, nhưng quy trình kiểm tra lại kết luận lô pin bị lỗi và yêu cầu dừng xuất xưởng hoặc tiêu hủy. Hậu quả: Doanh nghiệp chịu thiệt hại tài chính do tiêu hủy hàng đạt chuẩn và chậm tiến độ giao hàng. - Sai lầm loại II (Âm tính giả): Là việc không bác bỏ
khi thực sự đúng. Cụ thể: Lô pin thực tế bị lỗi cell nguy hiểm, nhưng quy trình kiểm tra lại không phát hiện ra và cho phép xuất xưởng ra thị trường. Hậu quả: Pin lắp lên xe điện có nguy cơ bốc cháy trong quá trình vận hành, đe dọa tính mạng khách hàng, kéo theo các vụ kiện tụng pháp lý và hủy hoại danh tiếng của thương hiệu.
2. Điều chỉnh mức ý nghĩa
- So sánh tổn thất thực tế: Hậu quả của Sai lầm loại II (cháy nổ, mất mạng người, thiệt hại hàng tỷ USD) nghiêm trọng hơn gấp bội so với Sai lầm loại I (chi phí tiêu hủy vài ngàn USD).
- Do đó, ưu tiên sống còn của doanh nghiệp là giảm thiểu tối đa xác suất sai lầm loại II (
), tức là tối đa hóa độ nhạy phát hiện lỗi của hệ thống. - Vì tồn tại sự đánh đổi giữa
và khi cỡ mẫu cố định, để kéo xuống mức cực thấp, ban quản lý nên chủ động tăng mức ý nghĩa (chẳng hạn nâng từ lên hoặc ). Khi đó, chỉ cần một dấu hiệu nghi vấn nhỏ, hệ thống sẽ lập tức báo động và chặn lô pin lại để kiểm tra thủ công.
3. Lực kiểm định và giải pháp cải thiện:
- Lực kiểm định là xác suất hệ thống phát hiện chính xác và bác bỏ lô pin khi lô pin đó thực sự bị lỗi nguy hiểm:
- Để tăng lực kiểm định (
) mà không phải đánh đổi bằng việc tăng sai lầm loại I ( ), phương án duy nhất là thu thập thêm thông tin bằng cách tăng cỡ mẫu kiểm tra (ví dụ: Tăng số lượng cell pin được quét cảm biến trong mỗi lô hoặc tăng thời lượng đo chu kỳ nạp xả mô phỏng).
Bài tập 2: Phân tích kiểm định một phía và nguy cơ nhân đôi sai lầm loại I
Một nhóm nghiên cứu muốn đánh giá một loại thuốc mới nhằm giảm nồng độ cholesterol xấu (LDL) trong máu so với giả dược.
Yêu cầu:
- Hãy phát biểu giả thuyết không
và giả thuyết đối cho kiểm định hai phía. Tại sao trong y học, kiểm định hai phía luôn được khuyến nghị làm chuẩn mực ban đầu? - Giả sử sau khi thu thập dữ liệu trên 100 bệnh nhân, nhóm nghiên cứu nhận thấy nồng độ LDL trung bình ở nhóm dùng thuốc giảm nhiều hơn nhóm đối chứng. Một thành viên đề xuất: "Dữ liệu thực tế rõ ràng cho thấy thuốc làm giảm cholesterol, vậy ta hãy đổi sang kiểm định một phía với
để thu được nhỏ hơn một nửa, giúp bài báo dễ được nghiệm thu hơn." Hãy phân tích sai lầm phương pháp luận của đề xuất trên và giải thích tại sao hành vi này làm nhân đôi xác suất sai lầm loại I.
Lời giải chi tiết
1. Phát biểu giả thuyết và lý do mặc định kiểm định hai phía:
- Đặt
là nồng độ LDL trung bình của nhóm dùng thuốc và là của nhóm đối chứng. - Giả thuyết kiểm định hai phía:
H_0 : \mu_T - \mu_C &= 0 \quad (\text{No effect on LDL}) \ &H_A : \mu_T - \mu_C \neq 0 \quad (\text{Effect on LDL}) \end
- Kết luận: Việc đổi sang kiểm định một phía sau khi xem dữ liệu đã làm xác suất dương tính giả thực tế tăng gấp đôi so với mức
công bố danh nghĩa, vi phạm nghiêm trọng tính minh bạch của phương pháp khoa học.
Bài tập 3: Vấn nạn so sánh bội trong phân tích hệ gen (Genomics)
Trong một công trình nghiên cứu di truyền học ung thư, các nhà khoa học tiến hành đo mức độ biểu hiện của
: Gen thứ không có sự khác biệt về mức độ biểu hiện giữa hai nhóm ( ). : Gen thứ có sự khác biệt về mức độ biểu hiện.
Yêu cầu:
- Giả sử trong thực tế, không có bất kỳ gen nào trong số 50 gen này thực sự liên quan đến bệnh ung thư (nghĩa là cả 50 giả thuyết không
đều đúng). Hãy tính xác suất để có ít nhất một gen bị kết luận nhầm là có liên quan đến ung thư (xuất hiện ít nhất một sai lầm loại I). - Hãy nêu nguyên lý của hiệu chỉnh Bonferroni và xác định ngưỡng ý nghĩa
cần áp dụng cho từng phép thử để kiểm soát xác suất xuất hiện sai lầm loại I trên toàn bộ nghiên cứu ở mức .
Lời giải chi tiết
1. Tính xác suất xuất hiện ít nhất một dương tính giả:
- Với mỗi gen thứ
, vì đúng, xác suất kiểm định đưa ra kết luận chính xác (không bác bỏ ) với mức là: - Do 50 phép thử được giả định là độc lập, xác suất để cả 50 phép thử đều đưa ra kết luận chính xác (không có bất kỳ sai lầm loại I nào) là:
- Do đó, xác suất để có ít nhất một gen bị kết luận sai là có liên quan đến ung thư (xuất hiện ít nhất một dương tính giả) là:
- Nhận xét: Dù không có bất kỳ gen nào thực sự gây bệnh, nghiên cứu vẫn có tới
xác suất đưa ra ít nhất một kết luận sai lầm mang tính giật gân nếu không có biện pháp hiệu chỉnh.
2. Hiệu chỉnh Bonferroni:
- Nguyên lý: Để đảm bảo xác suất xuất hiện ít nhất một sai lầm loại I trên toàn bộ họ 50 phép thử không vượt quá ngưỡng trần
, phương pháp Bonferroni chia đều ngưỡng ý nghĩa cho tổng số lượng phép thử : - Áp dụng số học: Với
và : - Kết luận: Một gen chỉ được tuyên bố là có ý nghĩa thống kê nếu giá trị
riêng lẻ của nó nhỏ hơn . Kỹ thuật này giúp loại bỏ gần như toàn bộ các phát hiện giả mạo phát sinh từ việc kiểm định đồng thời nhiều biến số.