Giao diện
1. Giới thiệu: Chuyển giao sang bài toán dự báo
Trong suốt hành trình đã qua, chúng ta đã tiếp cận ba cấp độ phân tích dữ liệu: Bắt đầu từ việc mô tả các mẫu hình trong quá khứ (khẳng định mô tả), kiểm tra xem các mẫu hình đó có thể mở rộng cho toàn bộ tổng thể hay không (khẳng định suy rộng), và đi sâu tìm hiểu xem liệu một biến số có phải là nguyên nhân trực tiếp thúc đẩy biến số kia hay không (khẳng định nhân quả).
Giờ đây, chúng ta bước vào chương cuối cùng của khoa học dữ liệu: Bài toán dự báo (Prediction).
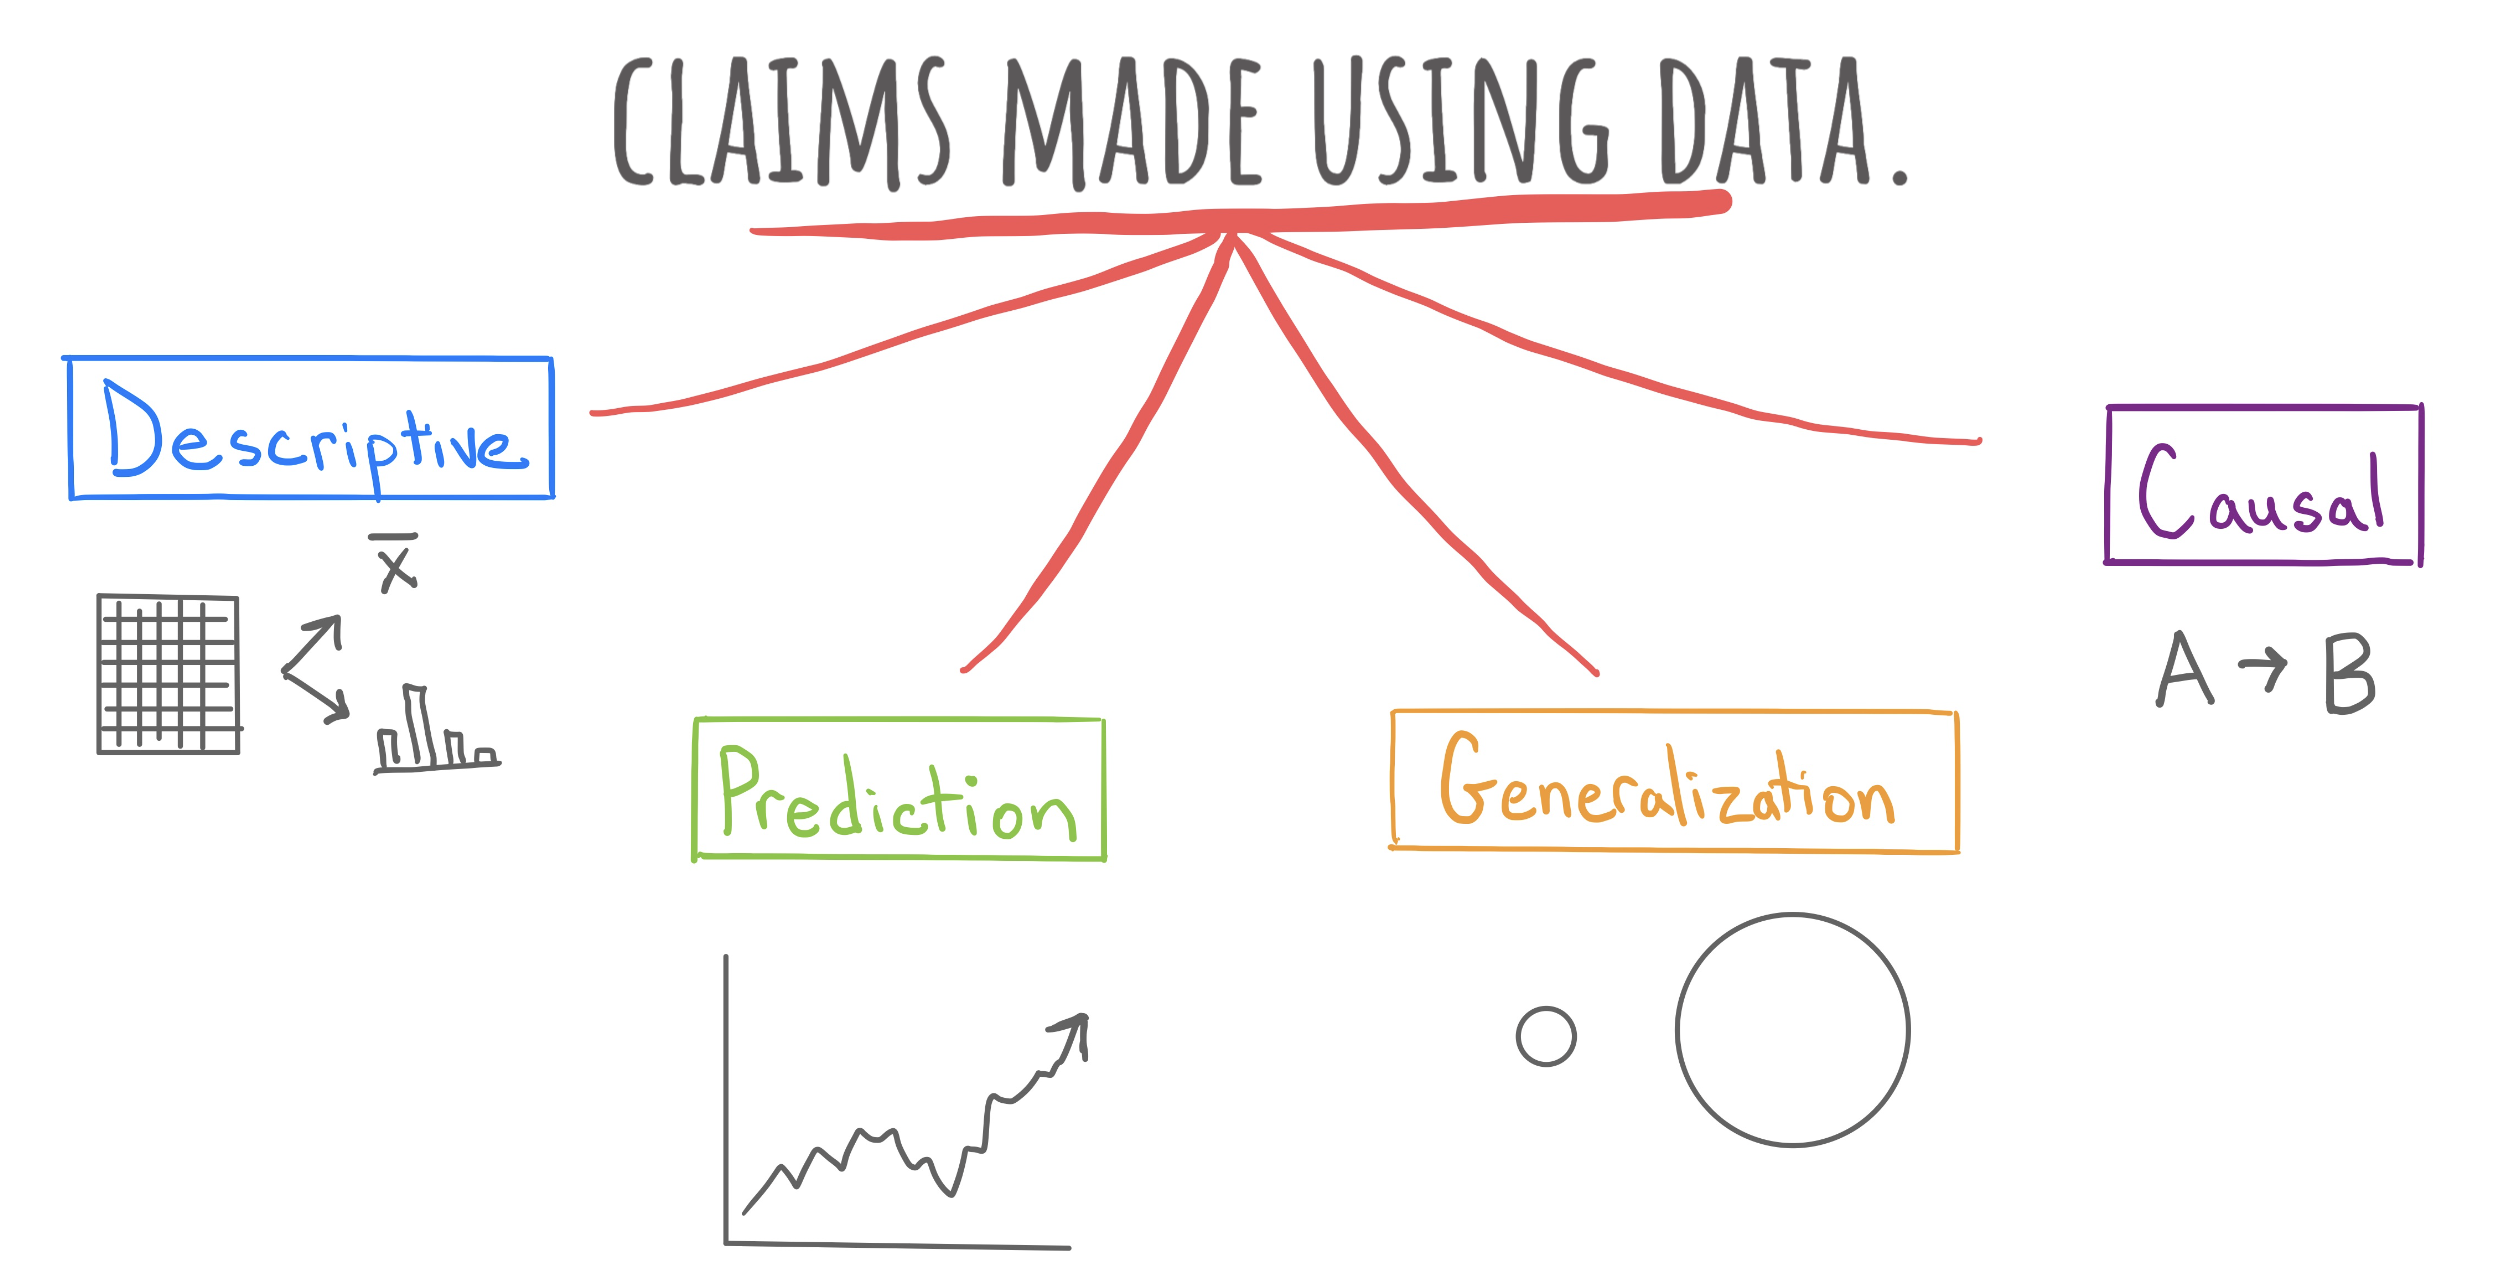 Hình 24.1: Bốn tầng bậc khẳng định tri thức trong khoa học dữ liệu: Khẳng định mô tả, khẳng định suy rộng, khẳng định nhân quả và khẳng định dự báo.
Hãy cùng quan sát đồ thị theo dõi Chỉ số Giá Tiêu dùng (CPI) được công bố trên các phương tiện truyền thông:
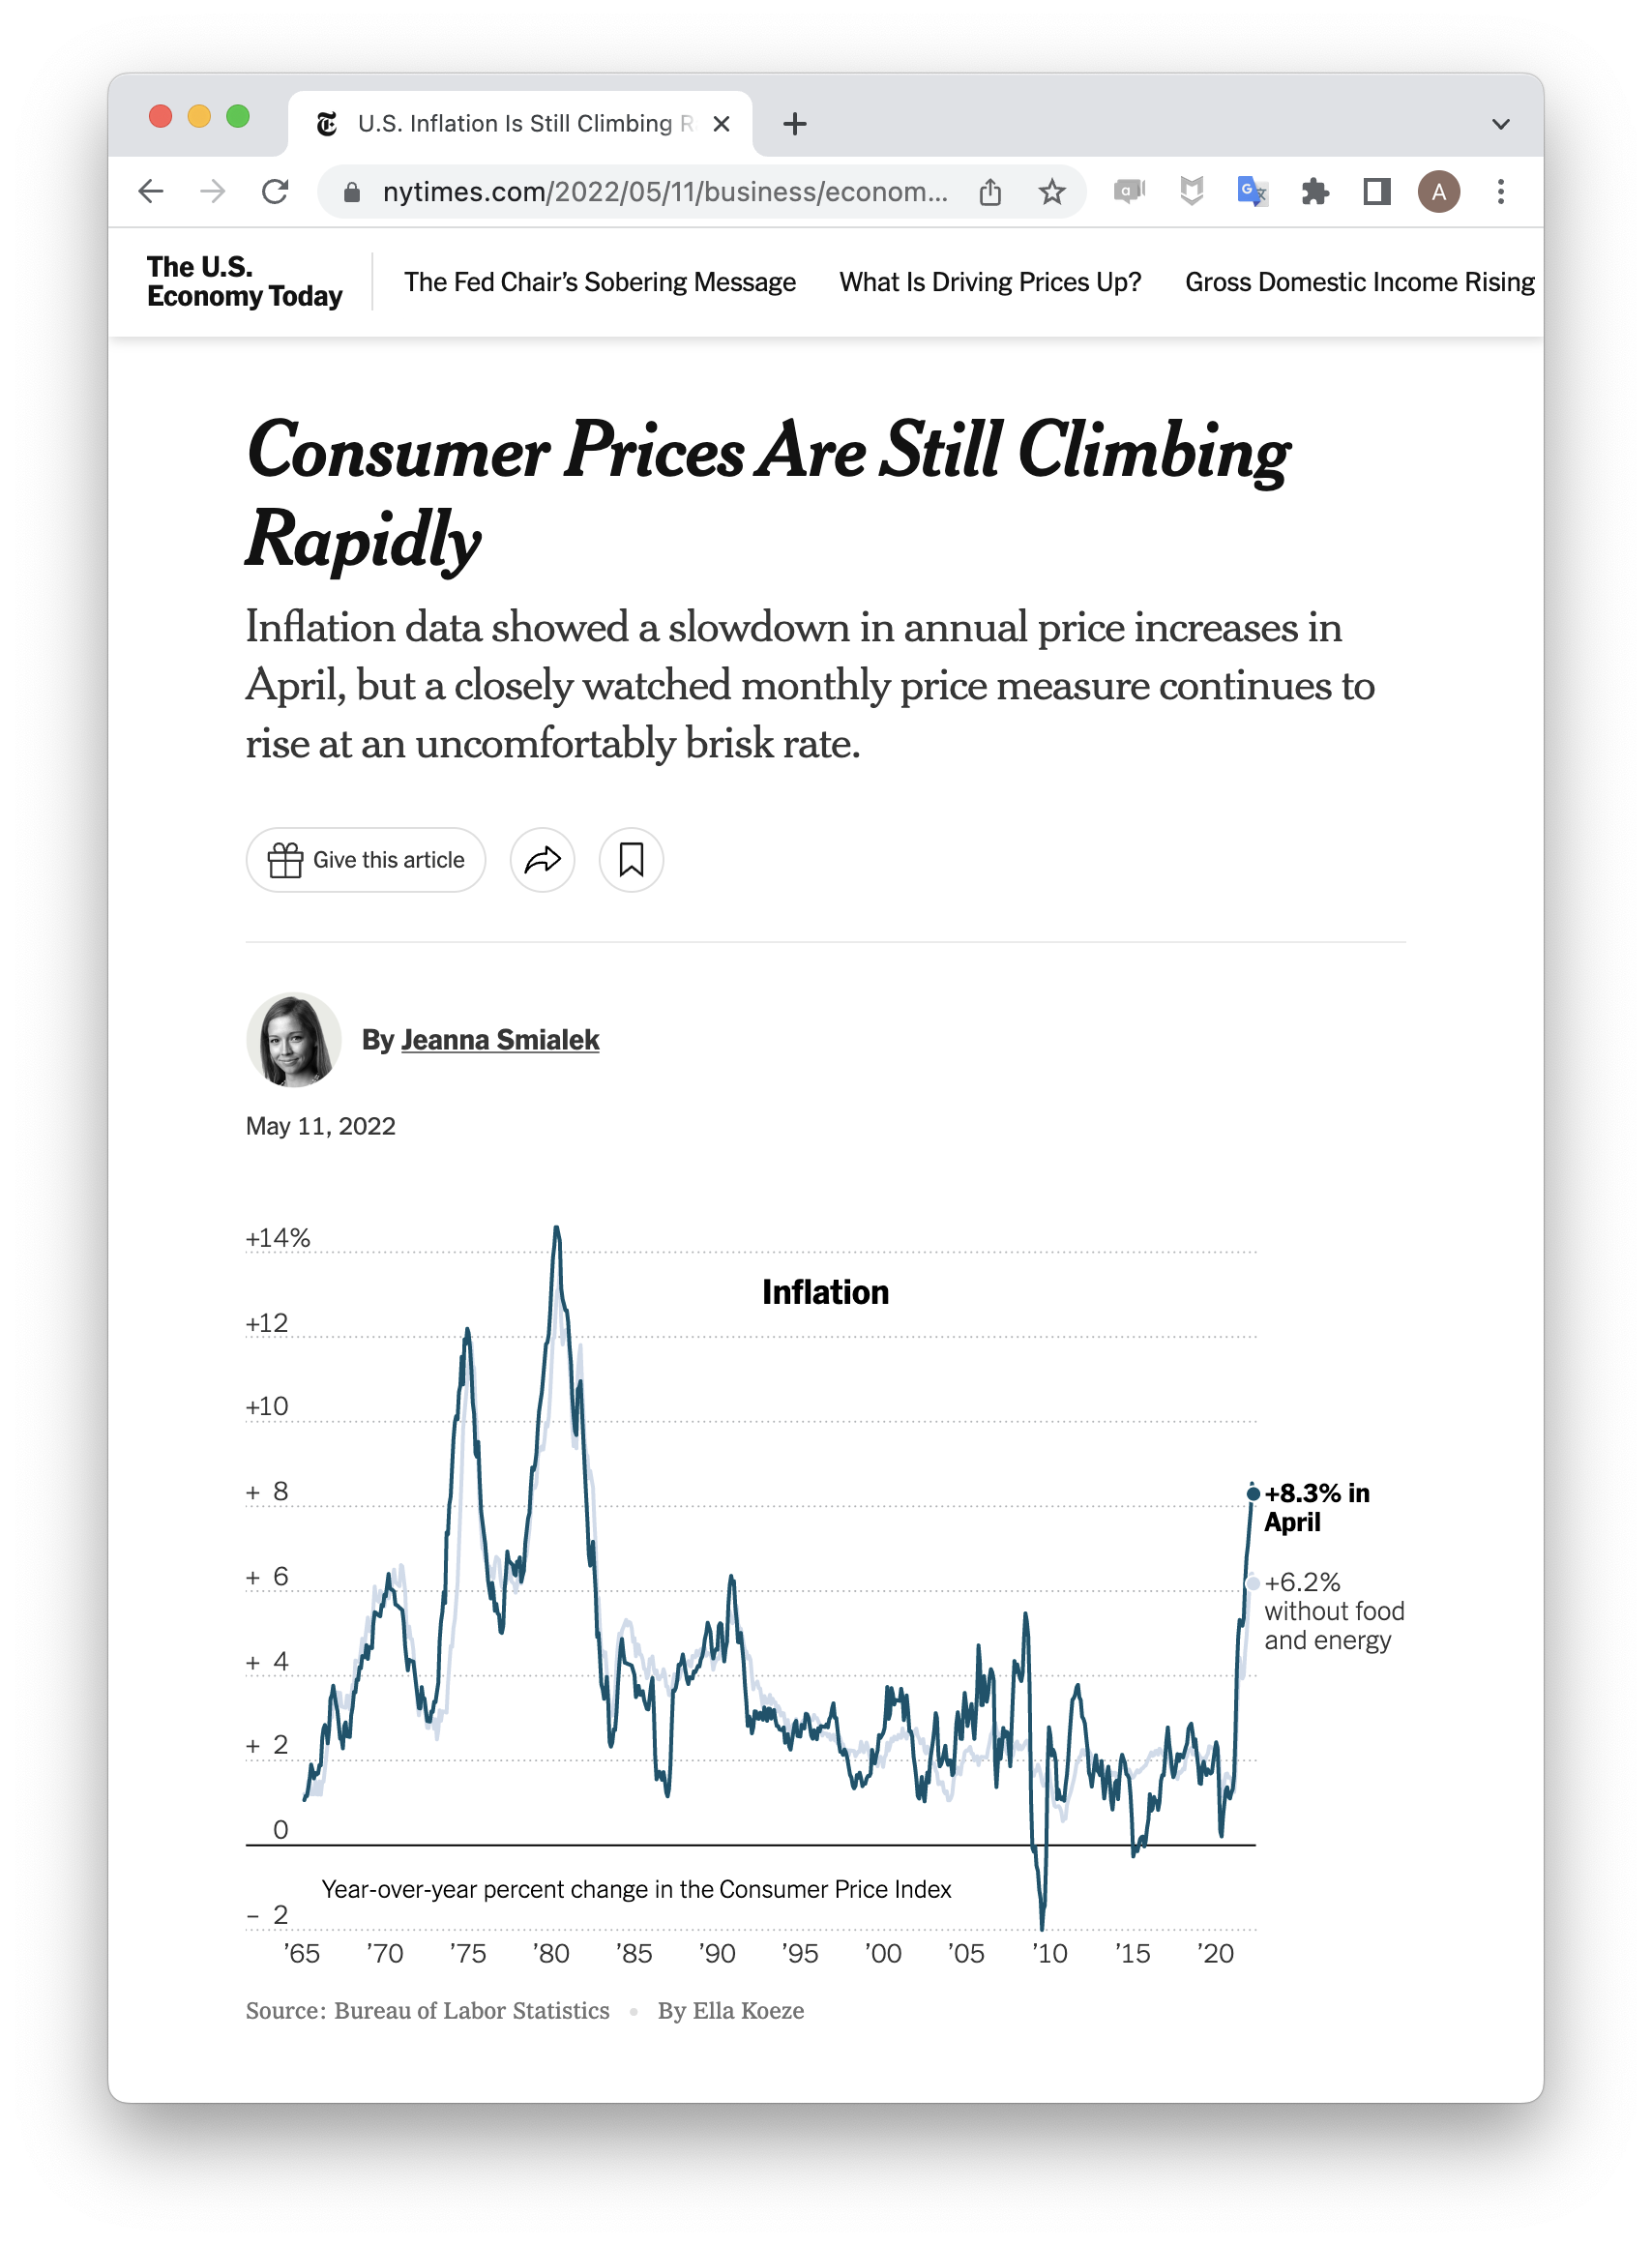 Hình 24.2: Biến động của Chỉ số Giá Tiêu dùng (CPI) theo thời gian. Từ dữ liệu quá khứ, làm sao để dự phóng tương lai?
Từ đồ thị này, bốn khẳng định khác nhau có thể được phát biểu:
- “Chỉ số Giá Tiêu dùng đã tăng
trong tháng 4.” (Khẳng định mô tả). - “Chỉ số giá tiêu dùng trên toàn cầu cũng tăng trong tháng 4.” (Khẳng định suy rộng).
- “Chỉ số CPI tăng
là do tác động của gián đoạn chuỗi cung ứng toàn cầu.” (Khẳng định nhân quả). - “Chỉ số CPI nhiều khả năng sẽ tiếp tục tăng trong suốt mùa hè tới.” (Khẳng định dự báo).
Khẳng định thứ tư là một dự báo: Ta tận dụng cấu trúc toán học của các dữ liệu đã biết trong quá khứ để ước lượng giá trị của một quan sát mà ta mới chỉ nắm giữ thông tin một phần. Vào giữa mùa hè, ta biết rõ ngày tháng là 15 tháng 7 (tọa độ
Toàn bộ cuộc cách mạng của Trí tuệ nhân tạo (AI) và Học máy (Machine Learning) ngày nay (từ chẩn đoán y khoa, xe tự hành cho đến các mô hình ngôn ngữ lớn) về bản chất đều xoay quanh các thuật toán dự báo. Tuy nhiên, đằng sau sự phức tạp của các mạng nơ-ron hàng tỷ tham số là những nguyên lý toán học nền tảng bắt đầu từ Phương pháp bình phương bé nhất.
2. Hai thành phần cốt lõi và Phân loại bài toán dự báo
Để thiết lập một bài toán dự báo, hai câu hỏi nền tảng bắt buộc phải được trả lời:
Biến phản hồi (Response Variable)
- Định nghĩa: Là biến số mục tiêu mà mô hình cần giá trị.
- Tên gọi khác: Biến phụ thuộc (Dependent Variable) hoặc kết cục (Outcome). Ký hiệu là
, hoặc khi được xem như một biến ngẫu nhiên.
Biến dự báo / Đặc trưng (Predictor Variables / Features)
- Định nghĩa: Là tập hợp các biến số đã biết được sử dụng làm dữ liệu đầu vào để biến phản hồi.
- Tên gọi khác: Biến độc lập (Independent Variables) hoặc đặc trưng (Features). Ký hiệu là
.
Dựa trên bản chất của biến phản hồi
| Tiêu chí | Bài toán Hồi quy (Regression) | Bài toán Phân loại (Classification) |
|---|---|---|
| Bản chất biến phản hồi | Biến định lượng liên tục (Số thực) | Biến định tính rời rạc (Nhãn danh mục) |
| Mục tiêu | một giá trị số đo lường cụ thể | một nhãn danh mục hoặc xác suất thuộc nhóm |
| Ví dụ thực tế 1 | Dự báo chỉ số CPI hoặc tỉ lệ lạm phát ( | Dự báo nền kinh tế có rơi vào suy thoái hay không ( |
| Ví dụ thực tế 2 | Dự báo giá bán của một căn nhà (triệu USD) | Dự báo thư điện tử là thư rác hay thư hợp lệ |
| Ví dụ thực tế 3 | Dự báo nhiệt độ ngày mai tại Hà Nội ( | Xe tự hành phân loại vật thể phía trước là người đi bộ hay chướng ngại vật tĩnh |
Trong phạm vi của môn học, chúng ta tập trung vào hai mô hình chuẩn mực đại diện cho hai họ bài toán này: Hồi quy Tuyến tính Bình phương bé nhất cho bài toán hồi quy, và Hồi quy Logistic cho bài toán phân loại.
3. Mô hình Hồi quy Tuyến tính Bội
Mô hình hồi quy tuyến tính giả định rằng giá trị kỳ vọng của biến phản hồi
Trong đó:
là hệ số chặn (Intercept): Giá trị dự báo của khi tất cả các đặc trưng đều bằng . là các hệ số hồi quy (Slope Coefficients): Cho biết mức thay đổi kỳ vọng của khi biến dự báo tương ứng tăng thêm một đơn vị, với điều kiện giữ cố định tất cả các biến dự báo còn lại.
Trong Phần II, chúng ta đã dùng mô hình hồi quy để mô tả cấu trúc của tập dữ liệu hiện có. Trong bài toán dự báo, ta đưa vào một quan sát hoàn toàn mới trong tương lai
Nhưng câu hỏi cốt tử là: Làm thế nào để tìm ra các hệ số
4. Phương pháp Bình phương bé nhất (Ordinary Least Squares - OLS)
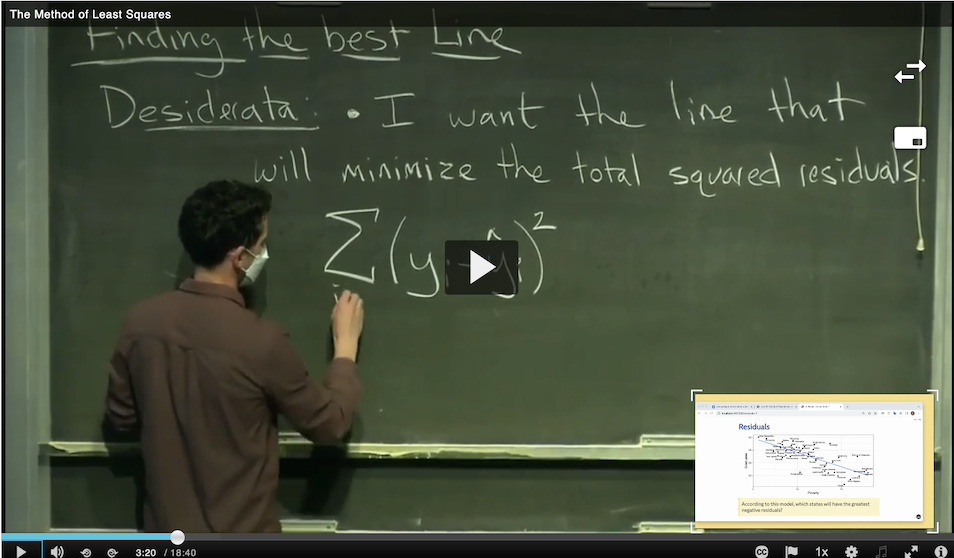 Hình 24.3: Đường hồi quy OLS là đường thẳng duy nhất tối thiểu hóa tổng diện tích các hình vuông biểu diễn bình phương phần dư theo phương thẳng đứng.
Với mỗi điểm dữ liệu quan sát
Hàm tổn thất Tổng bình phương phần dư (RSS)
Để đánh giá mức độ sai lệch của toàn bộ mô hình trên toàn bộ
Tại sao lại bình phương phần dư thay vì lấy giá trị tuyệt đối
- Khử dấu triệt tiêu: Nếu chỉ lấy tổng các phần dư
, các sai số dương và âm sẽ triệt tiêu lẫn nhau, khiến một đường thẳng dự báo tồi tệ vẫn có thể có tổng sai số bằng . Bình phương đảm bảo mọi sai lệch đều mang giá trị không âm. - Khả vi trơn tru (Smooth Differentiability): Hàm số bậc hai
có đạo hàm trơn tru và liên tục ở mọi nơi ( ), trong khi hàm trị tuyệt đối có điểm gấp khúc không khả vi tại . Tính khả vi trơn tru cho phép ta áp dụng giải tích vi tích phân để tìm nghiệm cực trị một cách dễ dàng. - Cơ chế phạt nặng sai số lớn: Bình phương phần dư trừng phạt rất nặng những điểm dữ liệu bị dự báo sai lệch lớn (sai số 4 đơn vị bị phạt
, trong khi sai số 2 đơn vị chỉ bị phạt ). - Mối liên hệ với Phân phối chuẩn: Dưới giả định sai số ngẫu nhiên tuân theo phân phối chuẩn Gauss
, nghiệm tối thiểu hóa RSS hoàn toàn trùng khớp với nghiệm của phương pháp Ước lượng hợp lý cực đại (Maximum Likelihood Estimation - MLE).
5. Hai con đường tìm hệ số tối ưu OLS
Để tìm tập hệ số
Con đường 1: Nghiệm giải tích tường minh (Analytical Solution via Calculus)
Vì
Trong trường hợp hồi quy tuyến tính đơn biến (
Trong đó:
là hệ số tương quan tuyến tính Pearson giữa và . và là độ lệch chuẩn của và . và là trung bình mẫu của và .
Hai tính chất hình học bất biến của đường hồi quy OLS:
- Đường hồi quy luôn đi qua điểm trọng tâm mẫu
. - Tổng đại số của các phần dư luôn bằng chính xác số
:
Con đường 2: Thuật toán tối ưu hóa số trị lặp (Algorithmic Numerical Optimization)
Khi số lượng biến dự báo
Thay vào đó, ta sử dụng các thuật toán tối ưu hóa số trị lặp:
- Thuật toán Gradient Descent (Hạ độ dốc):
- Là thuật toán tối ưu hóa quan trọng nhất của toàn bộ Trí tuệ nhân tạo hiện đại.
- Nguyên lý: Bắt đầu từ một bộ trọng số ban đầu
. Tại mỗi bước lặp , ta tính gradient (vector đạo hàm riêng) của hàm tổn thất và di chuyển các trọng số ngược chiều gradient một khoảng tỉ lệ với tốc độ học (Learning Rate ): - Thuật toán di chuyển dần dần xuống đáy của "thung lũng tổn thất" cho đến khi hội tụ về nghiệm tối ưu.
- Thuật toán Nelder-Mead (Đơn hình Simplex):
- Phương pháp tìm kiếm hình học không đòi hỏi tính đạo hàm, thường được dùng cho các bài toán tối ưu phi tuyến kích thước nhỏ.
6. Tóm tắt bài học
- Bài toán dự báo sử dụng cấu trúc toán học của các đặc trưng đã biết để ước lượng giá trị của biến phản hồi cho các quan sát mới.
- Dự báo được phân chia thành Hồi quy (biến phản hồi là số thực liên tục) và Phân loại (biến phản hồi là nhãn danh mục rời rạc).
- Phương pháp bình phương bé nhất (OLS) xác định đường hồi quy tối ưu bằng cách tối thiểu hóa hàm tổn thất Tổng bình phương phần dư (RSS).
- Việc bình phương phần dư giúp khử dấu triệt tiêu, tạo hàm khả vi trơn tru và gắn kết tự nhiên với phân phối chuẩn Gauss.
- Nghiệm OLS có thể được tìm thấy bằng công thức giải tích đạo hàm trong các bài toán đơn giản, hoặc bằng các thuật toán tối ưu hóa số trị như Gradient Descent trong học máy hiện đại quy mô lớn.
Tài liệu tham khảo
- Legendre, A. M. (1805). Nouvelles méthodes pour la détermination des orbites des comètes. Firmin Didot, Paris.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser, Hamburg.
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R (2nd ed.). Springer.
- Smialek, J. (2022, May 11). Consumer Prices are Still Climbing Rapidly. The New York Times.
Bài tập tự luyện
Bài tập 1: Nhận diện và phân loại bài toán dự báo trong thực tế
Hãy phân loại các bài toán ứng dụng sau đây vào hai họ bài toán: Hồi quy (Regression) hoặc Phân loại (Classification). Với mỗi bài toán, hãy chỉ rõ biến phản hồi
- Một hệ thống định giá sách tự động của trang thương mại điện tử Amazon tính toán mức giá bán đề xuất của một cuốn sách dựa trên khối lượng trang, số trang, thể loại sách và loại bìa (bìa cứng hay bìa mềm).
- Nhóm kỹ sư của hãng xe tự hành Waymo xây dựng mô hình cảm biến quang học lidar để xác định xem hình ảnh trước đầu xe là một chiếc xe thật đang lưu thông hay chỉ là ảo ảnh phản chiếu từ cửa kính tòa nhà.
- Trung tâm dự báo khí tượng thủy văn lượng mưa trong 24 giờ tới (tính bằng milimét) dựa trên độ ẩm không khí, áp suất khí quyển, nhiệt độ mặt đất và tốc độ gió.
- Hội đồng tuyển sinh đại học liệu một thí sinh trúng tuyển có xác nhận nhập học hay không dựa trên điểm thi đầu vào, tỉnh thành nơi cư trú và mức thu nhập gia đình.
Lời giải chi tiết
1. Hệ thống định giá sách của Amazon:
- Loại bài toán: Bài toán Hồi quy (Regression).
- Biến phản hồi
: Mức giá bán đề xuất của cuốn sách (biến định lượng liên tục, đơn vị: USD hoặc VNĐ). - Biến dự báo
: Khối lượng sách ( , gram), số trang ( ), thể loại ( , biến định tính), loại bìa ( , nhị phân: Bìa cứng hoặc bìa mềm).
2. Hệ thống cảm biến xe tự hành Waymo:
- Loại bài toán: Bài toán Phân loại (Classification).
- Biến phản hồi
: Nhãn định tính nhị phân của vật cản ( ). - Biến dự báo
: Tọa độ phản xạ chùm tia lidar, mật độ điểm mây lidar, cường độ xung phản xạ, vector vận tốc chuyển động tương đối.
3. Dự báo lượng mưa của trung tâm khí tượng:
- Loại bài toán: Bài toán Hồi quy (Regression).
- Biến phản hồi
: Lượng mưa tích lũy trong 24 giờ (biến định lượng liên tục không âm, đơn vị đo: Milimét). - Biến dự báo
: Độ ẩm không khí ( , ), áp suất ( , hPa), nhiệt độ ( , ), tốc độ gió ( , km/h).
4. xác nhận nhập học của hội đồng tuyển sinh:
- Loại bài toán: Bài toán Phân loại (Classification).
- Biến phản hồi
: Trạng thái xác nhận nhập học của thí sinh ( ). - Biến dự báo
: Điểm thi chuẩn hóa ( ), khoảng cách địa lý từ nhà đến trường ( , km), phân vị thu nhập gia đình ( ).
Bài tập 2: Tính toán giải tích OLS và kiểm chứng các tính chất hình học
Xét một tập dữ liệu nhỏ gồm
| Quan sát | ||
|---|---|---|
| 1 | 1 | 2 |
| 2 | 2 | 3 |
| 3 | 3 | 5 |
| 4 | 4 | 7 |
| 5 | 5 | 8 |
Yêu cầu:
- Hãy tính trung bình mẫu
và . - Áp dụng công thức giải tích bình phương bé nhất, tính toán hệ số góc
và hệ số chặn . Viết phương trình đường hồi quy tuyến tính OLS . - Tính toán các giá trị dự báo
và phần dư cho từng quan sát. Kiểm chứng tính chất và tính Tổng bình phương phần dư (RSS). - Dự báo điểm kiểm tra của một sinh viên dành ra
giờ ôn tập.
Lời giải chi tiết
1. Tính trung bình mẫu:
- Trung bình của
: - Trung bình của
:
2. Tính toán hệ số góc
- Ta lập bảng tính các đại lượng độ lệch:
| 1 | ||||
| 2 | ||||
| 3 | ||||
| 4 | ||||
| 5 | ||||
| Tổng |
- Hệ số góc
: - Hệ số chặn
: - Phương trình đường hồi quy OLS:
3. Tính giá trị dự báo, phần dư và RSS:
- Bảng phần dư:
| 1 | 1 | 2 | |||
| 2 | 2 | 3 | |||
| 3 | 3 | 5 | |||
| 4 | 4 | 7 | |||
| 5 | 5 | 8 | |||
| Tổng |
- Kiểm chứng tổng phần dư:
- Tổng bình phương phần dư:
4. Dự báo điểm số cho
- Điểm dự báo:
Bài tập 3: Mô phỏng thuật toán Gradient Descent cho bài toán tối ưu RSS
Vẫn với tập dữ liệu gồm 5 quan sát ở Bài tập 2, giả sử ta không dùng công thức giải tích mà sử dụng thuật toán tối ưu hóa số trị Gradient Descent để tìm các hệ số
Hàm tổn thất RSS được định nghĩa là:
Yêu cầu:
- Hãy tính đạo hàm riêng của
theo và theo dưới dạng biểu thức liên hệ với phần dư . - Giả sử ta khởi tạo các hệ số ban đầu là
và . Hãy tính vector gradient tại điểm xuất phát: - Với tốc độ học (Learning Rate)
, hãy thực hiện một bước cập nhật của thuật toán Gradient Descent để tìm bộ hệ số mới . Nhận xét về hướng di chuyển của các hệ số so với nghiệm giải tích tối ưu .
Lời giải chi tiết
1. Đạo hàm riêng của hàm tổn thất RSS:
- Áp dụng quy tắc đạo hàm hàm hợp cho tổng:
\frac{\partial \text{RSS}}{\partial b_0} &= \sum_{i=1}^n 2(y_i - (b_0 + b_1 x_i)) \cdot (-1) = -2 \sum_{i=1}^n (y_i - \hat{y}i) = -2 \sum^n e_i \ \frac{\partial \text{RSS}}{\partial b_1} &= \sum_{i=1}^n 2(y_i - (b_0 + b_1 x_i)) \cdot (-x_i) = -2 \sum_{i=1}^n x_i (y_i - \hat{y}i) = -2 \sum^n x_i e_i \end
\begin{aligned} \sum_{i=1}^5 e_i &= 1 + 1 + 2 + 3 + 3 = 10 \ \sum_{i=1}^5 x_i e_i &= 1 + 2 + 6 + 12 + 15 = 36 \end
\begin{aligned} \frac{\partial \text{RSS}}{\partial b_0} &= -2 \times 10 = -20.0 \ \frac{\partial \text{RSS}}{\partial b_1} &= -2 \times 36 = -72.0 \end
- Cập nhật hệ số chặn
: - Cập nhật hệ số góc
: - Bộ hệ số sau bước 1:
. - Nhận xét: Hệ số góc đã tăng từ
lên , vượt qua điểm và sẽ được kéo dần về trạng thái cân bằng trong các bước lặp tiếp theo. Hệ số chặn tăng chính xác từ lên . Thuật toán đang di chuyển rất nhanh về vùng lân cận của nghiệm tối ưu OLS .