Giao diện
Bài học này vận dụng các kỹ thuật xử lý dữ liệu vào 5 bài toán phân tích thực tế: Phân tích nhật ký truy cập web, đo lường mức độ bất đồng trong đánh giá phim, chuỗi thời gian tên khai sinh, dữ liệu dinh dưỡng phân cấp và hồ sơ tài chính quyên góp.
Song song với các bước làm sạch và biến đổi dữ liệu, bài học tập trung vào phương pháp kiểm chứng kết luận phân tích: Nhận diện nghịch lý Simpson khi tổng hợp dữ liệu gộp, kiểm soát mẫu số và tỷ trọng nhóm, phân biệt tương quan với nhân quả, và áp dụng quy trình thẩm định 4 bước để đánh giá độ tin cậy của các phát biểu định lượng.
1. Bài toán 1: Nhật ký truy cập và phân loại tác tử theo múi giờ
Dữ liệu nhật ký máy chủ (server logs) thường được ghi nhận dưới dạng chuỗi JSON thô (như nhật ký dịch vụ rút gọn liên kết 1.usa.gov). Mỗi dòng nhật ký ghi lại một sự kiện yêu cầu HTTP được gửi đến hệ thống, không tự động đại diện cho một người dùng duy nhất nếu chưa qua bước khử trùng lặp theo định danh hoặc phiên làm việc.
Đọc, chuẩn hóa và xử lý giá trị khuyết thiếu
Một bản ghi nhật ký điển hình chứa trường múi giờ (tz) và thông tin chuỗi tác tử (a, user-agent string). Hai thách thức lớn nhất khi làm sạch cột múi giờ là sự phân biệt giữa giá trị khuyết hoàn toàn (None hoặc NaN) với chuỗi rỗng (""):
python
import numpy as np
import pandas as pd

# Tập dữ liệu nhật ký mô phỏng nhỏ
ban_ghi = [
    {"tz": "Asia/Ho_Chi_Minh", "a": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"},
    {"tz": "Asia/Ho_Chi_Minh", "a": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7)"},
    {"tz": "America/New_York", "a": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"},
    {"tz": "", "a": "Mozilla/5.0 (X11; Ubuntu; Linux x86_64)"},
    {"a": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"} # Không có trường tz
]

df_nhat_ky = pd.DataFrame(ban_ghi)

# Chuẩn hóa giá trị thiếu: Phân biệt thiếu từ nguồn với chuỗi rỗng
tz_sach = df_nhat_ky["tz"].fillna("Missing").replace({"": "Unknown"})

print("Tần suất phân bố múi giờ:")
print(tz_sach.value_counts())
Phân loại heuristic hệ điều hành từ chuỗi tác tử
Chuỗi tác tử người dùng (User-Agent string) phản ánh thông tin trình duyệt và môi trường do trình khách khai báo. Việc kiểm tra chuỗi con "Windows" bằng str.contains("Windows") là một bộ phân loại phỏng đoán (heuristic classifier) phục vụ việc phân nhóm sơ bộ các yêu cầu HTTP, không phải là cơ chế xác thực danh tính hệ điều hành thực tế của người dùng (chuỗi User-Agent có thể bị chỉnh sửa hoặc chứa nhiều thông tin phụ):
python
# Phân loại sơ bộ yêu cầu từ môi trường Windows theo quy tắc heuristic
df_nhat_ky["he_dieu_hanh"] = np.where(
    df_nhat_ky["a"].fillna("").str.contains("Windows"),
    "Windows",
    "Khac"
)

# Tổng hợp số lượng yêu cầu theo múi giờ và hệ điều hành suy đoán
bang_he_dieu_hanh = df_nhat_ky.groupby(
    [tz_sach, "he_dieu_hanh"]
).size().unstack(fill_value=0)

print("Phân bố số lượng yêu cầu theo múi giờ và hệ điều hành:")
print(bang_he_dieu_hanh)
2. Bài toán 2: Đánh giá phim và đo lường mức độ bất đồng quan điểm
Trong hệ thống gợi ý và phân tích thị hiếu người tiêu dùng, dữ liệu thường được phân tán trên nhiều bảng quan hệ: Bảng người dùng (Users), bảng nội dung (Movies) và bảng nhật ký đánh giá (Ratings).
Hợp nhất dữ liệu và lập bảng xoay chiều
Quy trình phân tích bắt đầu bằng việc ghép nối các bảng theo khóa ngoại bằng pd.merge():
python
ratings = pd.DataFrame({
    "user_id": [1, 2, 3, 4, 1, 2, 3, 4],
    "movie_id": [10, 10, 10, 10, 20, 20, 20, 20],
    "rating": [5, 2, 4, 1, 4, 4, 3, 4]
})
users = pd.DataFrame({
    "user_id": [1, 2, 3, 4],
    "gender": ["F", "M", "F", "M"]
})
movies = pd.DataFrame({
    "movie_id": [10, 20],
    "title": ["Phim Hanh Dong A", "Phim Tam Ly B"]
})

# Hợp nhất ba bảng dữ liệu
du_lieu_phim = ratings.merge(users, on="user_id").merge(movies, on="movie_id")

# Lập bảng xoay chiều tính điểm trung bình theo giới tính
bang_diem = du_lieu_phim.pivot_table(
    index="title",
    columns="gender",
    values="rating",
    aggfunc="mean"
)
print("Điểm đánh giá trung bình theo giới tính:")
print(bang_diem)
Đo lường mức độ bất đồng quan điểm
Làm thế nào để phát hiện các tác phẩm gây tranh cãi trong cộng đồng? Ta sử dụng hai thước đo định lượng:
- Chênh lệch thị hiếu giữa các nhóm: Tính hiệu số điểm giữa khán giả nữ và nam (
diff = piv["F"] - piv["M"]). - Độ phân tán của toàn bộ khán giả: Tính độ lệch chuẩn (
std) của điểm số cho từng bộ phim. Phim có độ lệch chuẩn cao là phim mà người xem chia rẽ sâu sắc (người chấm 1 sao, người chấm 5 sao), trong khi phim có độ lệch chuẩn thấp nhận được sự đồng thuận cao.
python
# 1. Đo lường chênh lệch giới tính
bang_diem["chenh_lech"] = bang_diem["F"] - bang_diem["M"]

# 2. Đo lường độ phân tán bằng độ lệch chuẩn
do_phan_tan = du_lieu_phim.groupby("title")["rating"].std()
bang_diem["do_lech_chuan"] = do_phan_tan

print("Bảng đo lường bất đồng quan điểm:")
print(bang_diem[["chenh_lech", "do_lech_chuan"]])
3. Bài toán 3: Phân tích xu hướng đặt tên, tính đa dạng và sự dịch chuyển âm cuối
Tập dữ liệu đặt tên của cơ quan quản lý an sinh xã hội ghi nhận số lượng trẻ em sinh ra theo tên, giới tính và năm, kéo dài từ cuối thế kỷ 19 đến nay. Đây là ví dụ điển hình cho việc phân tích dữ liệu lịch sử dài hạn.
Chuẩn hóa tỷ trọng và phân tích xu hướng
Tổng số trẻ sinh ra thay đổi mạnh qua từng thập kỷ do bùng nổ dân số. Do đó, so sánh số lượng tuyệt đối sẽ làm sai lệch nhận định. Thao tác cần thiết là tính tỷ trọng phần trăm của từng tên trong từng năm và từng giới tính:
python
du_lieu_ten = pd.DataFrame({
    "nam": [1880, 1880, 1950, 1950, 2010, 2010],
    "ten": ["John", "Mary", "John", "Mary", "John", "Mary"],
    "gioi_tinh": ["M", "F", "M", "F", "M", "F"],
    "so_tre": [9655, 7065, 79428, 65482, 11498, 4073]
})

# Tính tỷ trọng trong từng nhóm năm và giới tính
du_lieu_ten["ty_trong"] = du_lieu_ten.groupby(
    ["nam", "gioi_tinh"]
)["so_tre"].transform(lambda x: x / x.sum())

print("Bảng tỷ trọng đặt tên:")
print(du_lieu_ten)
Đo lường tính đa dạng đặt tên
Một câu hỏi xã hội học đáng quan tâm: Thị hiếu đặt tên của cha mẹ ngày càng phong phú hay ngày càng thu hẹp? Ta có thể đo lường tính đa dạng bằng cách tính số lượng tên phổ biến nhất cần thiết để chiếm đủ 50% tổng số trẻ sinh ra trong năm. Ở thế kỷ 19, chỉ cần vài chục tên đứng đầu đã chiếm tới một nửa số trẻ em. Đến thế kỷ 21, số lượng tên cần thiết đã tăng lên hàng trăm, phản ánh sự mở rộng về tính đa dạng khi lựa chọn tên gọi.
Sự dịch chuyển của chữ cái kết thúc
Bằng cách trích xuất ký tự cuối cùng của chuỗi tên gọi bằng str[-1], ta quan sát thấy sự thay đổi rõ rệt trong phân bố chữ cái kết thúc của tên con trai. Tỷ trọng các tên kết thúc bằng chữ cái "n" (như John, Ryan, Ethan) đã tăng từ khoảng 14% ở thế kỷ 19 lên hơn 35% trong những năm gần đây.
python
du_lieu_ten["chu_cai_cuoi"] = du_lieu_ten["ten"].str[-1]
bang_chu_cai = du_lieu_ten.pivot_table(
    index="chu_cai_cuoi",
    columns=["nam", "gioi_tinh"],
    values="so_tre",
    aggfunc="sum",
    fill_value=0
)
print("Phân bố chữ cái kết thúc:")
print(bang_chu_cai)
4. Bài toán 4: Khai phá dữ liệu dinh dưỡng lồng nhau dạng JSON
Cơ sở dữ liệu dinh dưỡng (như dữ liệu thành phần thực phẩm) thường được phân phối dưới dạng các cấu trúc JSON phân cấp sâu: Mỗi món ăn là một đối tượng chứa các trường định danh cơ bản, kèm theo một mảng con lồng nhau gồm hàng chục chỉ số vi chất dinh dưỡng.
Phẳng hóa dữ liệu phân cấp
Để phân tích bằng các công cụ bảng, ta cần tách dữ liệu thành hai bảng liên kết:
- Bảng món ăn: Chứa thông tin chung (
id,ten_mon,nhom_thuc_pham). - Bảng thành phần dinh dưỡng: Chứa các dòng chi tiết liên kết qua khóa
id.
python
thuc_pham_raw = [
    {
        "id": 1001,
        "ten": "Bo lat",
        "nhom": "Sua",
        "dinh_duong": [
            {"chat": "protein", "luong": 0.85},
            {"chat": "chat_beo", "luong": 81.11},
            {"chat": "canxi", "luong": 24.0}
        ]
    },
    {
        "id": 1002,
        "ten": "Trung ga",
        "nhom": "Trung",
        "dinh_duong": [
            {"chat": "protein", "luong": 12.56},
            {"chat": "chat_beo", "luong": 9.51},
            {"chat": "canxi", "luong": 56.0}
        ]
    }
]

# Tách bảng thông tin món ăn
df_thuc_pham = pd.DataFrame([
    {"id": d["id"], "ten": d["ten"], "nhom": d["nhom"]}
    for d in thuc_pham_raw
])

# Phẳng hóa mảng lồng nhau thành bảng dinh dưỡng chi tiết
danh_sach_chat = []
for d in thuc_pham_raw:
    for n in d["dinh_duong"]:
        danh_sach_chat.append({
            "id": d["id"],
            "chat": n["chat"],
            "luong": n["luong"]
        })
df_dinh_duong = pd.DataFrame(danh_sach_chat)

# Hợp nhất hai bảng để phục vụ phân tích
bang_tong_hop = df_dinh_duong.merge(df_thuc_pham, on="id")
print("Bảng dinh dưỡng phẳng hóa hoàn chỉnh:")
print(bang_tong_hop)
Truy vấn thực phẩm giàu vi chất theo nhóm
Nhờ cấu trúc bảng phẳng, việc tìm kiếm thực phẩm có hàm lượng vi chất cao nhất theo từng nhóm trở nên trực diện thông qua groupby và idxmax:
python
# Tìm món ăn giàu protein nhất trong từng nhóm
protein_df = bang_tong_hop[bang_tong_hop["chat"] == "protein"]
top_protein = protein_df.sort_values("luong", ascending=False)
print("Thực phẩm giàu protein nhất:")
print(top_protein[["ten", "nhom", "luong"]])
5. Bài toán 5: Phân tích đóng góp tài chính và phân khoảng giá trị
Hồ sơ quyên góp tài chính chính trị và xã hội thường có phân phối số tiền lệch phải rõ rệt: Đa số các khoản quyên góp có quy mô nhỏ (vài chục đến vài trăm nghìn đồng), trong khi tổng giá trị đóng góp chịu ảnh hưởng lớn từ các khoản tài trợ quy mô lớn của các nhà tài trợ.
Chuẩn hóa trường nghề nghiệp và cơ quan
Dữ liệu tự khai báo thường chứa hàng trăm biến thể chính tả của cùng một nghề nghiệp (ví dụ: "KS", "Kỹ sư", "ENGINEER"). Kỹ thuật chuẩn hóa là xây dựng từ điển ánh xạ (mapping dictionary):
python
df_quyen_gop = pd.DataFrame({
    "nguoi_ung_ho": ["An", "Binh", "Chi", "Dung", "Em"],
    "nghe_nghiep": ["Kỹ sư", "KS", "Bác sĩ", "GIAO VIEN", "Giáo viên"],
    "ung_vien": ["UngVien_A", "UngVien_A", "UngVien_B", "UngVien_B", "UngVien_A"],
    "so_tien": [50, 250, 1500, 75, 12000]
})

anh_xa_nghe = {
    "Kỹ sư": "Kỹ thuật",
    "KS": "Kỹ thuật",
    "Bác sĩ": "Y tế",
    "GIAO VIEN": "Giáo dục",
    "Giáo viên": "Giáo dục"
}
df_quyen_gop["nghe_chuan"] = df_quyen_gop["nghe_nghiep"].map(anh_xa_nghe)
Phân khoảng số tiền đóng góp với pd.cut
Để quan sát cơ cấu nhà tài trợ, ta phân chia số tiền quyên góp thành các khoảng giá trị (buckets / bins) tăng theo cấp số nhân:
python
cac_nguong = [0, 100, 1000, 10000, 100000]
df_quyen_gop["khoang_tien"] = pd.cut(
    df_quyen_gop["so_tien"],
    bins=cac_nguong,
    right=True
)

# Tổng hợp dòng tiền theo ứng viên và khoảng tiền đóng góp
dong_tien_nhom = df_quyen_gop.groupby(
    ["ung_vien", "khoang_tien"],
    observed=False
)["so_tien"].sum().unstack(fill_value=0)

print("Phân bố dòng tiền quyên góp theo quy mô:")
print(dong_tien_nhom)
Bảng tổng hợp này cho thấy ngay ứng viên nào nhận được sự ủng hộ rộng rãi từ các cử tri bình dân (chi phối ở khoảng dưới 100) và ứng viên nào phụ thuộc vào các khoản tài trợ quy mô lớn (chi phối ở khoảng trên 1.000).
6. Thiên lệch tổng hợp, nghịch lý Simpson và thẩm định kết luận
Một báo cáo phân tích dữ liệu thất bại thường không phải do mã nguồn tính sai số học, mà do người phân tích chọn sai thước đo và diễn giải sai bản chất của kết quả.
Nghịch lý Simpson: Sự đảo chiều toán học khi gộp nhóm
Một hiện tượng đáng chú ý trong phân tích dữ liệu là nghịch lý Simpson (Simpson's Paradox): Xu hướng tăng trưởng hay suy giảm xuất hiện đồng nhất trong từng nhóm thành phần riêng lẻ có thể bị đảo ngược hoàn toàn khi dữ liệu được gộp chung lại ở cấp độ toàn bộ thị trường.
Cơ cấu trọng số tác động như thế nào đến giá trị bình quân gộp?
Với k nhóm, gọi
Viết gọn,
Với N dương và các nhóm tách biệt bao phủ toàn bộ tập quan sát, trọng số là:
Ký hiệu tổng cho điều kiện cuối là
Xét bảng minh họa với trung bình và số quan sát của từng nhóm:
| Phân khúc chỗ ở | Giá trung bình kỳ 1 | Giá trung bình kỳ 2 | Biến động từng nhóm |
|---|---|---|---|
| Căn hộ nguyên căn | 60 nghìn | 66 nghìn | Tăng +10% |
| Phòng riêng | 30 nghìn | 33 nghìn | Tăng +10% |
| Các quan sát gộp chung | 55 nghìn | 38,5 nghìn | Giảm 30% |
Mỗi trung bình nhóm tăng 10%, nhưng trung bình gộp của tập quan sát giảm 30%. Không được thay các trung bình nhóm trong công thức bằng trung vị nhóm, vì trung vị gộp không được tính bằng phép bình quân có trọng số này.
Nguyên nhân nằm ở sự thay đổi cơ cấu mẫu giữa hai kỳ khảo sát: Ở Kỳ 1, căn hộ nguyên căn đắt tiền chiếm đa số (10 căn hộ so với 2 phòng riêng). Sang Kỳ 2, số lượng phòng riêng giá rẻ tăng vọt (10 phòng riêng so với chỉ 2 căn hộ). Vì phòng riêng có mức giá nền thấp hơn nhiều so với căn hộ, sự gia tăng áp đảo về số lượng của chúng đã kéo tụt con số bình quân gộp chung của toàn thành phố.
Bài học cốt lõi: Khi phân tích biến động qua thời gian, bắt buộc phải kiểm tra cơ cấu tỷ trọng của các nhóm thành phần trước khi vội vã diễn giải một con số gộp chung.
Bẫy chọn kỳ gốc có lợi và ngụy biện nhân quả
- Chọn kỳ gốc: Nếu chọn một mốc thấp bất thường, tỷ lệ tăng đến kỳ cuối có thể lớn hơn nhiều so với khi chọn mốc khác. Cần nêu kỳ gốc và đối chiếu cả lịch sử, thay vì chỉ giữ đoạn có lợi cho lời kể.
- Tương quan và nhân quả: Giá niêm yết của các căn hộ gần ga thấp hơn chưa chứng minh ga làm giảm giá. Hai nhóm có thể khác vị trí, diện tích hoặc chất lượng. Cần dữ liệu và thiết kế phân tích phù hợp để kiểm tra các cách giải thích đó.
Phân biệt phần trăm (%) và điểm phần trăm (pp)
Giả sử tỷ lệ hủy phòng giảm từ
- Chênh lệch tuyệt đối (Điểm phần trăm, percentage points, pp):Đây là mức giảm một điểm phần trăm.
- Biến động tương đối (Phần trăm, percentage, %):
Nếu diễn đạt rằng "tỷ lệ hủy phòng giảm 1%", người đọc trong giới kiểm toán và tài chính có thể hiểu là giảm
7. Khung quy trình thẩm định dữ liệu 4 bước (Data audit framework)
Khi nhận được một bản báo cáo phân tích hoặc khi sử dụng trí tuệ nhân tạo để soạn thảo kết luận, người làm dữ liệu phải thực hiện quy trình thẩm định 4 bước:
- Bước 1: Truy số (Number Tracing): Viết mã nguồn Python chạy lại từ bảng dữ liệu gốc để xác minh từng con số được nêu. Nếu con số là bịa đặt do ảo giác của mô hình, bác bỏ ngay lập tức.
- Bước 2: Kiểm tra phương pháp (Methodological Audit): Đánh giá xem thước đo được chọn có phù hợp với phân phối của dữ liệu hay không. Phân phối có bị lệch do ngoại lai không? Kỳ thời gian khảo sát đã khép lại trọn vẹn chưa?
- Bước 3: Kiểm tra diễn giải (Interpretive Scrutiny): Kiểm tra xem lời kết luận có vượt quá phạm vi bằng chứng không. Có đang nhầm lẫn giữa tương quan với nhân quả hay không?
- Bước 4: Phán quyết chuyên gia (Expert Verdict): Đưa ra phán quyết chính thức cho từng kết luận độc lập (Giữ nguyên, Sửa đổi, hoặc Chưa thể kiểm chứng).
Bảng tổng hợp phán quyết thẩm định mẫu
| Kết luận cần thẩm định | Truy số | Kiểm phương pháp | Kiểm diễn giải | Phán quyết chuyên gia |
|---|---|---|---|---|
| Giá thuê trung bình 118 nghìn | Đạt | Không đạt (Ngoại lai làm lệch) | Không đạt | Sửa đổi: Bắt buộc dùng giá trung vị để đại diện. |
| Tháng 6 sụt giảm 28%, thị trường hạ nhiệt | Đạt | Không đạt (Mốc chụp tháng chưa trọn) | Không đạt | Chưa thể kiểm chứng: Chờ mốc chụp đầy đủ. |
| Phòng gần tàu điện rẻ hơn, ga làm giảm giá | Đạt | Cần lưu ý (Đo gián tiếp qua từ khóa) | Không đạt (Ngụy biện nhân quả) | Sửa đổi: Chỉ khẳng định hai yếu tố đi kèm. |
Bài học quan trọng nhất: Trong cả ba trường hợp có tì vết, các con số tính toán đều hoàn toàn chính xác, trong khi lỗi sai thực sự nằm ở phương pháp chọn thước đo và cách diễn giải bằng lời.
9. Tổng kết
| Chủ đề phân tích | Công cụ kỹ thuật chủ yếu | Bài học phương pháp luận cốt lõi |
|---|---|---|
| Nhật ký máy chủ | fillna(), replace(), str.contains() | Luôn phân biệt ô khuyết thiếu từ nguồn với chuỗi rỗng do hệ thống ghi nhận. |
| Đánh giá & Thị hiếu | pivot_table(), std() | Độ lệch chuẩn phản ánh mức độ bất đồng quan điểm giữa các nhóm người dùng. |
| Xu hướng đặt tên | transform(), str[-1] | Chuẩn hóa tỷ trọng trước khi so sánh chuỗi thời gian, đồng thời phân tích âm cuối để phát hiện quy luật. |
| Dữ liệu phân cấp | pd.json_normalize(), tách bảng | Phẳng hóa dữ liệu JSON thành các bảng quan hệ liên kết bằng khóa duy nhất. |
| Dòng tiền & Đóng góp | pd.cut(), map() | Phân khoảng số tiền tăng dần theo cấp số nhân để xử lý dữ liệu lệch phải. |
| Thẩm định kết luận | Bốn bước: Truy số, Phương pháp, Diễn giải, Phán quyết | Luôn cảnh giác với nghịch lý Simpson. Số đúng chưa đủ, phương pháp và lập luận phải chuẩn xác. |
Tài liệu tham khảo
- Wes McKinney, Python for Data Analysis, 3rd Edition, Chapter 13: Data Analysis Examples. URL: https://wesmckinney.com/book/data-analysis-examples.
- Viện Trí tuệ Nhân tạo, Trường Đại học Công nghệ, ĐHQGHN: Giáo trình Lập trình xử lý dữ liệu (Bài 14: Kể chuyện bằng dữ liệu và thẩm định phân tích AI). Nội dung thẩm định và nghịch lý tổng hợp được chuyển thể theo giấy phép CC BY-NC-SA 4.0.
- Edward H. Simpson, The Interpretation of Interaction in Contingency Tables, Journal of the Royal Statistical Society, 1951.
- Darrell Huff, How to Lie with Statistics, W. W. Norton & Company.
- IAI, Lập trình xử lý dữ liệu, học liệu và notebook. Các đề thực hành đã được biên tập cách diễn đạt và bổ sung lời giải, giữ CC BY-NC-SA 4.0. Giấy phép học liệu.
8. Bài tập thực hành
Bài tập 1: Đo lường mức độ bất đồng quan điểm trong đánh giá dịch vụ
Một chuỗi nhà hàng thu thập dữ liệu đánh giá của khách hàng về các chi nhánh, được lưu trong bảng sau:
python
df_danh_gia = pd.DataFrame({
    "chi_nhanh": ["A", "A", "A", "A", "B", "B", "B", "B"],
    "khach_hang": ["K1", "K2", "K3", "K4", "K5", "K6", "K7", "K8"],
    "nhom_khach": ["Tre", "TrungNien", "Tre", "TrungNien", "Tre", "TrungNien", "Tre", "TrungNien"],
    "diem": [5, 1, 5, 2, 4, 3, 4, 3]
})- Tính điểm đánh giá trung bình của từng chi nhánh theo nhóm khách hàng bằng
pivot_table. - Tính độ lệch chuẩn của điểm số tại mỗi chi nhánh. Chi nhánh nào có sự phân hóa quan điểm mạnh mẽ hơn?
Lời giải chi tiết
Mã nguồn thực hiện:
python
# 1. Bảng xoay chiều điểm trung bình theo nhóm khách
bang_pivot = df_danh_gia.pivot_table(
    index="chi_nhanh",
    columns="nhom_khach",
    values="diem",
    aggfunc="mean"
)
print("Điểm trung bình theo nhóm khách:")
print(bang_pivot)

# 2. Độ lệch chuẩn đo lường bất đồng quan điểm
do_lech_chuan = df_danh_gia.groupby("chi_nhanh")["diem"].std()
print("Độ lệch chuẩn điểm số của từng chi nhánh:")
print(do_lech_chuan)
Kết quả phân tích:
- Tại chi nhánh A: Điểm trung bình của nhóm Khách Trẻ là 5,0 trong khi nhóm Trung Niên là 1,5. Độ lệch chuẩn đạt xấp xỉ 2,06. Chi nhánh A có sự bất đồng quan điểm sâu sắc giữa các thế hệ khách hàng.
- Tại chi nhánh B: Điểm trung bình của hai nhóm lần lượt là 4,0 và 3,0, độ lệch chuẩn chỉ là xấp xỉ 0,58. Khách hàng tại chi nhánh B có mức độ đồng thuận cao về chất lượng dịch vụ.
Bài tập 2: Thẩm định biến động doanh thu và nhận diện nghịch lý Simpson
Một công ty thương mại điện tử công bố bảng số liệu sau về giá trị đơn hàng trung bình giữa hai năm:
python
# Năm 1: 100 đơn hàng điện tử (trung bình 200$), 20 đơn hàng sách (trung bình 20$)
# Năm 2: 20 đơn hàng điện tử (trung bình 220$), 100 đơn hàng sách (trung bình 22$)- Tính giá trị đơn hàng trung bình của từng ngành hàng giữa hai năm. Mỗi ngành hàng tăng trưởng bao nhiêu phần trăm?
- Tính giá trị đơn hàng trung bình gộp của toàn bộ công ty trong từng năm. Chỉ ra hiện tượng nghịch lý Simpson và giải thích nguyên nhân bằng cơ cấu trọng số.
Lời giải chi tiết
Mã nguồn tính toán:
python
# Năm 1
tb_dt_nam1 = 200
tb_sach_nam1 = 20
tong_don_nam1 = 100 + 20
tb_gop_nam1 = (100 * tb_dt_nam1 + 20 * tb_sach_nam1) / tong_don_nam1

# Năm 2
tb_dt_nam2 = 220
tb_sach_nam2 = 22
tong_don_nam2 = 20 + 100
tb_gop_nam2 = (20 * tb_dt_nam2 + 100 * tb_sach_nam2) / tong_don_nam2

print(f"Năm 1: Điện tử {tb_dt_nam1}$, Sách {tb_sach_nam1}$, Bình quân gộp: {tb_gop_nam1:.2f}$")
print(f"Năm 2: Điện tử {tb_dt_nam2}$, Sách {tb_sach_nam2}$, Bình quân gộp: {tb_gop_nam2:.2f}$")

tang_dt = (tb_dt_nam2 / tb_dt_nam1 - 1) * 100
tang_sach = (tb_sach_nam2 / tb_sach_nam1 - 1) * 100
tang_gop = (tb_gop_nam2 / tb_gop_nam1 - 1) * 100

print(f"Tăng trưởng Điện tử: +{tang_dt:.1f}%")
print(f"Tăng trưởng Sách: +{tang_sach:.1f}%")
print(f"Tăng trưởng Bình quân gộp toàn công ty: {tang_gop:.1f}%")
Kết quả:
- Ngành hàng Điện tử tăng trưởng:
. - Ngành hàng Sách tăng trưởng:
. - Bình quân gộp toàn công ty giảm từ
USD xuống USD, tương đương giảm khoảng . - Giải thích: Nghịch lý Simpson xuất hiện do cơ cấu đơn hàng đảo chiều mạnh mẽ. Năm 1, ngành điện tử giá trị cao chiếm
tổng số đơn. Sang năm 2, ngành sách giá trị thấp chiếm tới tổng số đơn. Sự thay đổi trọng số phân bổ này đã kéo sụt con số trung bình gộp dù từng ngành hàng đều tăng giá.
Quan sát cơ cấu nhóm trong một biểu đồ
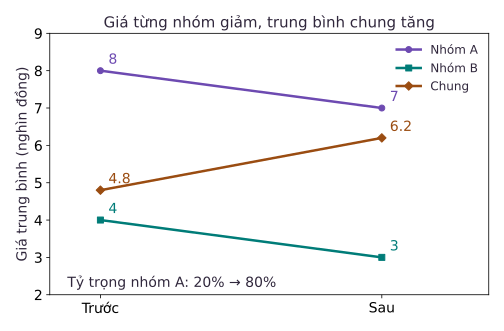
Giá trung bình của nhóm A giảm từ 8 xuống 7, còn nhóm B giảm từ 4 xuống 3 nghìn đồng. Tuy vậy, tỷ trọng quan sát thuộc nhóm A tăng từ 20% lên 80%. Vì nhóm A vẫn có giá cao hơn nhóm B ở cả hai kỳ, thay đổi cơ cấu có thể làm trung bình chung tăng.
Bài tập: Giải thích hai chiều biến động
Mỗi kỳ có 100 quan sát. Ở kỳ trước, A có 20 quan sát và B có 80 quan sát. Ở kỳ sau, A có 80 quan sát và B có 20 quan sát. Dùng các trung bình nhóm trên hình để tính trung bình chung mỗi kỳ. Khẳng định “Giá tăng trong từng nhóm” có phù hợp với dữ liệu này không?
Lời giải
Tổng giá ở kỳ trước được tính từ số quan sát và trung bình của mỗi nhóm:
Chia cho 100, ta được trung bình 4,8 nghìn đồng. Ở kỳ sau, tổng tương ứng là:
Vì vậy trung bình chung kỳ sau bằng 6,2 nghìn đồng. Trung bình chung tăng, nhưng giá trung bình trong từng nhóm đều giảm. Hai kết quả trả lời những câu hỏi khác nhau vì dùng trọng số nhóm khác nhau.
python
truoc = (20 * 8 + 80 * 4) / 100
sau = (80 * 7 + 20 * 3) / 100
assert (truoc, sau) == (4.8, 6.2)
assert 7 < 8 and 3 < 4 and sau > truoc
Để so sánh khi giữ cơ cấu cố định, có thể dùng tỷ trọng 20% và 80% ở cả hai kỳ. Khi đó trung bình kỳ sau là 3,8 nghìn đồng, giảm so với 4,8. Việc chọn cơ cấu tham chiếu cần được nêu rõ trong báo cáo.
python
sau_cung_co_cau = 0.2 * 7 + 0.8 * 3
assert abs(sau_cung_co_cau - 3.8) < 1e-12
Lab 14: Viết kết luận đúng với dữ liệu
Một báo cáo cần trả lời rõ dữ liệu cho biết điều gì và chưa cho biết điều gì. Các bài sau luyện cách sắp xếp kết luận, chọn từ đúng với số đo và kiểm tra vì sao số gộp có thể khác xu hướng trong từng nhóm.
1. Mục tiêu thực hành
- Sắp xếp một mục báo cáo theo thứ tự: Kết luận, bằng chứng, giới hạn, phương pháp.
- Đối chiếu lời văn với chỉ tiêu, đơn vị, kỳ so sánh và phạm vi dữ liệu.
- Tính trung bình có trọng số và giải thích sự đảo chiều khi cơ cấu nhóm thay đổi.
- Kiểm tra một kết luận qua bốn bước: Tính lại số, xem cách đo, rà diễn giải và kiểm tra thêm theo nhóm.
2. Dữ liệu thực hành
CAU chứa bốn câu cần sắp xếp. CAP chứa sáu cặp số liệu và lời diễn giải. Bảng bang có hai kỳ và hai phân khúc để minh họa nghịch lý Simpson. DEMO_DS gồm 12 chỗ ở giả lập để tính lại số đánh giá và điểm đánh giá theo nhóm quy mô niêm yết.
Các bảng nhỏ không đại diện cho thị trường Santiago. Cột number_of_reviews_ltm đếm đánh giá trong 12 tháng gần nhất của mốc chụp, không phải số đánh giá của một năm lịch. Điều kiện từ 5 niêm yết trở lên chỉ là quy ước chia nhóm của bài, không chứng minh chủ nhà làm nghề chuyên nghiệp.
python
import numpy as np
import pandas as pd

# Thiết lập hành vi Copy-on-Write an toàn cho thư viện pandas
if pd.__version__.startswith("2.") or pd.__version__.startswith("3."):
    pd.set_option("mode.copy_on_write", True)

# Địa chỉ snapshot dữ liệu thực tế tại Santiago de Chile phục vụ đối chiếu
SNAPSHOT_URL = (
    "https://data.insideairbnb.com/chile/rm/santiago/"
    "2026-06-29/visualisations/listings.csv"
)

# Mốc chụp dữ liệu chuẩn hóa của tập dữ liệu
SNAPSHOT = "2026-06-29"
NOTE
Snapshot Santiago ngày 29/06/2026 có trung vị giá 59.000 CLP/đêm và trung bình khoảng 118.200 CLP/đêm (giá trị tính được khoảng 118.199,6498). Hai trung bình số đánh giá theo ngưỡng 5, làm tròn một chữ số, là 15,5 và 12,7 trong 12 tháng gần nhất. Code dùng dữ liệu giả lập không tự tính lại các số của snapshot này.
3. Bài tập
Bài tập 1: Sắp xếp một mục báo cáo theo cấu trúc kim tự tháp
Bài tập 1: Sắp xếp câu và kiểm tra thứ tự
Cho bốn câu trong từ điển CAU:
A: Nêu số chỗ ở có giá hợp lệ, mốc chụp và số dòng thiếu giá đã loại.B: Nêu giá trung vị 59.000 CLP/đêm, đặt cạnh giá trung bình đã làm tròn trong đoạn mẫu.C: Nêu bằng chứng được báo cáo về ảnh hưởng của các giá trị cực đoan.D: Giới hạn kết luận ở giá niêm yết một đêm, chưa gồm các khoản phí.
Hãy gán thu_tu là danh sách bốn chữ cái, mỗi chữ xuất hiện đúng một lần, theo thứ tự: Kết luận, bằng chứng, giới hạn, phương pháp. Ghép các câu thành một đoạn báo cáo và kiểm tra danh sách không thiếu hoặc lặp câu.
Bài này kiểm tra cách tổ chức thông điệp. Số 118.000 CLP trong chuỗi mẫu là mức làm tròn gần hàng nghìn, không phải giá trị trung bình chính xác. Những chi tiết như quy đổi sang VND hoặc tác động 44% cần nguồn và phép tính riêng nếu dùng trong một báo cáo thực tế.
Lời giải
Cách 1: Chọn thứ tự rồi ghép các câu
python
import pandas as pd

# 1. Dữ liệu bốn câu phân tích rời rạc
CAU = {
    "A": "Con số dựa trên 17.688 chỗ ở có giá hợp lệ ở mốc chụp 29/06/2026; 846 chỗ ở không có giá đã được loại và ghi trong qa_report.",
    "B": "Giá thuê điển hình ở Santiago là 59.000 CLP/đêm (khoảng 1,65 triệu đồng), thấp hơn mức trung bình 118.000 CLP.",
    "C": "Trung vị ít bị ảnh hưởng bởi giá ngoại lai: 177 giá trị cực đoan đã gắn cờ làm trung bình cao hơn 44% nhưng gần như không làm thay đổi trung vị.",
    "D": "Kết luận chỉ áp dụng cho giá niêm yết một đêm, chưa gồm phí vệ sinh/dịch vụ; giá thực tế khách trả có thể cao hơn.",
}

# 2. Xác định thứ tự chuẩn mực theo nguyên lý kim tự tháp:
#    Vị trí 1 (Kết luận cốt lõi) -> B
#    Vị trí 2 (Bằng chứng số liệu trực tiếp) -> C
#    Vị trí 3 (Giới hạn và điều kiện biên) -> D
#    Vị trí 4 (Chi tiết phương pháp và mẫu dữ liệu) -> A
thu_tu = ["B", "C", "D", "A"]

# 3. Ghép nối thành văn bản báo cáo có nhãn phân tầng
cac_doan = [f"[{i + 1}] {CAU[ma]}" for i, ma in enumerate(thu_tu)]
van_ban_bao_cao = "\n\n".join(cac_doan)

print("Thứ tự sắp xếp theo kim tự tháp:", thu_tu)
print("\nVăn bản báo cáo hoàn chỉnh:")
print(van_ban_bao_cao)
Giải thích chi tiết cách 1
Câu B đứng đầu vì trả lời trực tiếp câu hỏi về mức giá. Câu C đi sau để nêu luận cứ hỗ trợ việc dùng trung vị. Câu D giới hạn ý nghĩa con số, còn A cung cấp thông tin mẫu và cách xử lý cho người cần kiểm tra lại. Vì vậy thứ tự là B, C, D, A.
thu_tu là danh sách giữ thứ tự đã chọn. Biểu thức CAU[ma] lấy câu ứng với mỗi chữ cái. enumerate(thu_tu) lần lượt cho vị trí bắt đầu từ 0 và mã câu. Cộng 1 khi định dạng chuỗi làm nhãn hiển thị bắt đầu từ 1.
List comprehension tạo một danh sách các đoạn đã có nhãn. "\n\n".join(cac_doan) nối chúng bằng hai ký tự xuống dòng, tạo một dòng trống giữa hai đoạn. Việc ghép đúng thứ tự không xác minh các phát biểu số học bên trong câu C. Muốn dùng chúng làm bằng chứng, cần tính lại từ dữ liệu tương ứng.
Kết quả thực thi cách 1
| Vị trí | Mã câu | Vai trò |
|---|---|---|
| 1 | B | Kết luận |
| 2 | C | Bằng chứng |
| 3 | D | Giới hạn |
| 4 | A | Phương pháp |
thu_tu trả ['B', 'C', 'D', 'A']. Văn bản được in theo đúng bốn hàng trong bảng.
Cách 2: Kiểm tra danh sách và đối chiếu vai trò từng câu
python
import pandas as pd

# 1. Dữ liệu bốn câu phân tích rời rạc
CAU = {
    "A": "Con số dựa trên 17.688 chỗ ở có giá hợp lệ ở mốc chụp 29/06/2026; 846 chỗ ở không có giá đã được loại và ghi trong qa_report.",
    "B": "Giá thuê điển hình ở Santiago là 59.000 CLP/đêm (khoảng 1,65 triệu đồng), thấp hơn mức trung bình 118.000 CLP.",
    "C": "Trung vị ít bị ảnh hưởng bởi giá ngoại lai: 177 giá trị cực đoan đã gắn cờ làm trung bình cao hơn 44% nhưng gần như không làm thay đổi trung vị.",
    "D": "Kết luận chỉ áp dụng cho giá niêm yết một đêm, chưa gồm phí vệ sinh/dịch vụ; giá thực tế khách trả có thể cao hơn.",
}

# 2. Ánh xạ vai trò ngữ nghĩa của từng câu văn
VAI_TRO_NGU_NGHIA = {
    "B": "ket_luan",
    "C": "bang_chung",
    "D": "gioi_han",
    "A": "phuong_phap",
}


def validate_and_format_pyramid(sentences: dict, order: list, roles: dict) -> dict:
    """Thẩm định tính hợp lệ của cấu trúc kim tự tháp và xuất bảng kiểm toán."""
    # Kiểm tra tính toàn vẹn: Mọi câu phải xuất hiện đúng một lần
    if set(order) != set(sentences.keys()) or len(order) != len(sentences):
        raise ValueError(
            "Danh sách thứ tự phải chứa đầy đủ và duy nhất các câu trong tập dữ liệu."
        )

    # Định nghĩa chuẩn mực thứ tự bốn tầng kim tự tháp
    thu_tu_chuan = ["ket_luan", "bang_chung", "gioi_han", "phuong_phap"]
    thu_tu_thuc_te = [roles.get(ma) for ma in order]

    la_hop_le = thu_tu_thuc_te == thu_tu_chuan

    bang_kiem_toan = pd.DataFrame(
        {
            "Thu_tu": range(1, len(order) + 1),
            "Ma_cau": order,
            "Vai_tro_thuc_te": thu_tu_thuc_te,
            "Vai_tro_ky_vong": thu_tu_chuan,
            "Trang_thai": [
                "Khớp" if t == k else "Lệch"
                for t, k in zip(thu_tu_thuc_te, thu_tu_chuan)
            ],
            "Noi_dung": [sentences[ma] for ma in order],
        }
    )

    van_ban = "\n\n".join(
        [
            f"[{r['Thu_tu']}. {r['Vai_tro_thuc_te'].upper()}] {r['Noi_dung']}"
            for _, r in bang_kiem_toan.iterrows()
        ]
    )

    return {
        "la_hop_le": la_hop_le,
        "bang_kiem_toan": bang_kiem_toan,
        "van_ban": van_ban,
    }


# Thực thi kiểm định cấu trúc với thứ tự B -> C -> D -> A:
ket_qua_kiem_dinh = validate_and_format_pyramid(
    CAU, ["B", "C", "D", "A"], VAI_TRO_NGU_NGHIA
)
print(
    "Kết quả thẩm định kim tự tháp:",
    "ĐẠT CHUẨN" if ket_qua_kiem_dinh["la_hop_le"] else "KHÔNG ĐẠT",
)
print("\nBảng kiểm toán cấu trúc phân tầng:")
print(
    ket_qua_kiem_dinh["bang_kiem_toan"][
        ["Thu_tu", "Ma_cau", "Vai_tro_thuc_te", "Trang_thai"]
    ].to_string(index=False)
)
Giải thích chi tiết cách 2
set(order) != set(sentences.keys()) phát hiện mã thiếu hoặc mã ngoài tập câu. Kiểm tra thêm độ dài giúp phát hiện trường hợp lặp một mã. Hai điều kiện đi cùng nhau để yêu cầu mỗi mã xuất hiện đúng một lần.
roles.get(ma) đọc vai trò đã được người viết gán sẵn cho từng câu. Danh sách vai trò thực tế được so với thứ tự mong muốn. Phép zip ghép hai danh sách theo vị trí để tạo cột Trang_thai. Vai trò đúng vị trí cho giá trị Khớp, còn sai vị trí cho Lệch.
Hàm trả cờ hợp lệ, bảng đối chiếu và văn bản đã ghép. iterrows() duyệt bảng để định dạng từng đoạn. Đây là phép kiểm tra thứ tự dựa trên nhãn vai trò có sẵn, không phải công cụ tự đọc hiểu câu hoặc xác minh bằng chứng. Nếu người viết gán sai vai trò từ đầu, hàm vẫn có thể báo đạt.
Kết quả thực thi cách 2
| Dòng | Kết quả in ra |
|---|---|
| 1 | Kết quả thẩm định kim tự tháp: ĐẠT CHUẨN |
| 2 | |
| 3 | Bảng kiểm toán cấu trúc phân tầng: |
| 4 | Thu_tu Ma_cau Vai_tro_thuc_te Trang_thai |
| 5 | 1 B ket_luan Khớp |
| 6 | 2 C bang_chung Khớp |
| 7 | 3 D gioi_han Khớp |
| 8 | 4 A phuong_phap Khớp |
So sánh hai cách
Cách 1 phù hợp để sắp một mục ngắn và đọc lại toàn văn. Cách 2 giúp phát hiện mã lặp, mã thiếu và vị trí sai khi đã có bảng vai trò. Hai cách vẫn cần người viết đánh giá ý nghĩa câu và độ tin cậy của số liệu.
Bài tập 2: Phân biệt lời diễn giải đúng mức và quá mức
Bài tập 2: Đối chiếu số đo với lời văn
Gán nhãn vua hoặc qua cho sáu cặp trong CAP, rồi nêu cách viết lại các câu vượt quá dữ liệu:
- Tăng 53,7% so với cùng kỳ và lời viết "Thị trường tăng trưởng mạnh so với cùng kỳ".
- Tăng 3,0% so với tháng trước và lời viết "Bứt phá thần tốc trong tháng 5".
- Tương quan 0,081 và lời viết "Nhiệt độ ngày ảnh hưởng rõ rệt tới lượng đánh giá".
- Một chỗ ở yêu cầu tối thiểu 730 đêm và lời viết "Một vài ca cực đoan cần gắn cờ".
- Có 16.772/18.534 chỗ ở liệt kê Wifi và lời viết "Mạng ổn định ở 90% chỗ ở".
- Quy tắc chưa kiểm định gắn cờ nhóm
escho 65,4% văn bản và lời viết "Chắc chắn 2/3 khách nói tiếng Tây Ban Nha".
Sau đó viết hàm rà các cụm từ cần xem lại và trả bảng gồm số liệu, lời văn, nhãn và gợi ý sửa. Phân biệt rõ cảnh báo theo từ khóa với việc xác minh nội dung câu.
Lời giải
Cách 1: Gán nhãn và giải thích từng cặp
python
import pandas as pd

# 1. Tập hợp sáu cặp số liệu và lời văn đối chiếu
CAP = {
    1: (
        "So cùng kỳ: +53,7% (T5/2026 so với T5/2025)",
        "Thị trường tăng trưởng mạnh so với cùng kỳ",
    ),
    2: ("+3,0% so với tháng trước", "Bứt phá thần tốc trong tháng 5"),
    3: ("Hệ số tương quan 0,081", "Nhiệt độ ngày ảnh hưởng rõ rệt tới lượng đánh giá"),
    4: ("Đúng 1 chỗ ở đòi ở tối thiểu 730 đêm", "Một vài ca cực đoan cần gắn cờ"),
    5: ("16.772/18.534 chỗ ở liệt kê Wifi (90,5%)", "Mạng ổn định ở 90% chỗ ở"),
    6: (
        "Nhóm es chiếm 65,4% (quy tắc chưa kiểm định)",
        "Chắc chắn 2/3 khách nói tiếng Tây Ban Nha",
    ),
}

# 2. Gán nhãn thủ công dựa trên đối chiếu số đo và phạm vi kết luận
#    "vua": Diễn đạt đúng mức với số liệu
#    "qua": Vượt quá phạm vi đo lường hoặc suy diễn sai bản chất
nhan = {
    1: "vua",
    2: "qua",
    3: "qua",
    4: "vua",
    5: "qua",
    6: "qua",
}

# 3. Tạo bảng tổng hợp phân tích ngữ nghĩa
bang_phan_loai = pd.DataFrame(
    [
        {
            "Cap": k,
            "So_lieu": v[0],
            "Loi_van": v[1],
            "Danh_gia": nhan[k],
            "Ban_chat": "Đúng mức" if nhan[k] == "vua" else "Quá mức",
        }
        for k, v in CAP.items()
    ]
)

print("Kết quả phân loại sáu cặp số liệu và lời văn:")
print(bang_phan_loai[["Cap", "Danh_gia", "Ban_chat", "Loi_van"]].to_string(index=False))
Giải thích chi tiết cách 1
nhan là từ điển quyết định thủ công cho từng mã cặp. Vòng lặp đọc CAP.items() tạo một dòng kết quả cho mỗi cặp. pd.DataFrame ghép các dòng thành bảng. Phép kiểm tra nhan[k] == "vua" chỉ chuyển nhãn sang tên dễ đọc, không tự đánh giá câu văn.
Cặp 1 được gán vua trong bài luyện này vì lời viết còn giữ kỳ so sánh của mức tăng. Tuy vậy, báo cáo cần nêu đúng chỉ tiêu tăng 53,7%, thay vì mở rộng một số đo riêng thành mọi mặt của thị trường. Cặp 2 được gán qua vì riêng mức tăng 3,0% chưa hỗ trợ lời mô tả "bứt phá thần tốc". Không có cơ sở để tự gọi 3,0% là dao động thông thường nếu chưa xem chuỗi dữ liệu.
Cặp 3 được gán qua vì tương quan gần 0 chỉ cho thấy quan hệ tuyến tính yếu trong mẫu đang xét. Nó không suy ra độc lập thống kê và không chứng minh tác động nhân quả. Cặp 4 giữ nhãn vua của bài luyện đối với việc cần gắn cờ giá trị bất thường. Khi báo số lượng, câu chính xác hơn là "Có một trường hợp yêu cầu tối thiểu 730 đêm", thay vì "một vài".
Cặp 5 đo việc liệt kê tiện nghi, không đo độ ổn định đường truyền. Cặp 6 mới đo tỷ lệ khớp quy tắc trên văn bản, chưa xác minh tiếng mẹ đẻ, quốc tịch hoặc tỷ lệ khách. Do đó hai cặp đều nhận qua. Các nhãn là điểm bắt đầu để đọc lại câu, không thay thế lập luận về đơn vị và phạm vi phép đo.
Kết quả thực thi cách 1
| Mã cặp | Nhãn trong bài | Điểm cần kiểm tra |
|---|---|---|
| 1 | vua | Nêu rõ chỉ tiêu và cùng kỳ so sánh |
| 2 | qua | Lời mô tả vượt mức số liệu đã cho |
| 3 | qua | Tương quan chưa xác lập nhân quả hoặc độc lập |
| 4 | vua | Cần gắn cờ, nhưng số lượng phải viết là một trường hợp |
| 5 | qua | Có liệt kê Wifi chưa có nghĩa mạng ổn định |
| 6 | qua | Cờ trên văn bản chưa xác nhận ngôn ngữ của khách |
Cách 2: Dùng danh sách cụm từ để gợi ý chỗ cần đọc lại
python
import pandas as pd

# 1. Tập hợp sáu cặp số liệu và lời văn
CAP = {
    1: (
        "So cùng kỳ: +53,7% (T5/2026 so với T5/2025)",
        "Thị trường tăng trưởng mạnh so với cùng kỳ",
    ),
    2: ("+3,0% so với tháng trước", "Bứt phá thần tốc trong tháng 5"),
    3: ("Hệ số tương quan 0,081", "Nhiệt độ ngày ảnh hưởng rõ rệt tới lượng đánh giá"),
    4: ("Đúng 1 chỗ ở đòi ở tối thiểu 730 đêm", "Một vài ca cực đoan cần gắn cờ"),
    5: ("16.772/18.534 chỗ ở liệt kê Wifi (90,5%)", "Mạng ổn định ở 90% chỗ ở"),
    6: (
        "Nhóm es chiếm 65,4% (quy tắc chưa kiểm định)",
        "Chắc chắn 2/3 khách nói tiếng Tây Ban Nha",
    ),
}


def audit_claim_wording(pairs: dict) -> pd.DataFrame:
    """Kiểm toán tự động lời văn phân tích dựa trên danh mục từ khóa rủi ro và phạm vi biến số."""
    # Danh mục từ khóa rủi ro và khuyến nghị sửa đổi
    danh_muc_rui_ro = {
        "bứt phá thần tốc": (
            "Thổi phồng biến động ngắn hạn",
            "tăng nhẹ 3,0% so với tháng trước",
        ),
        "ảnh hưởng rõ rệt": (
            "Ngụy biện nhân quả từ tương quan yếu",
            "tương quan tuyến tính không đáng kể (r = 0,081)",
        ),
        "ổn định": (
            "Đánh tráo có tiện nghi với chất lượng dịch vụ",
            "90,5% chỗ ở có liệt kê tiện nghi Wifi",
        ),
        "chắc chắn": (
            "Khẳng định tuyệt đối trên quy tắc chưa kiểm định",
            "khoảng 65,4% bài đánh giá dùng tiếng Tây Ban Nha theo quy tắc sơ bộ",
        ),
    }

    ket_qua = []
    for ma_cap, (so_lieu, loi_van) in pairs.items():
        loi_van_lower = loi_van.lower()
        phat_hien = None

        for tu_khoa, (ly_do, goi_y) in danh_muc_rui_ro.items():
            if tu_khoa in loi_van_lower:
                phat_hien = (tu_khoa, ly_do, goi_y)
                break

        if phat_hien:
            nhan_dinh = "qua"
            canh_bao = f"Phát hiện cụm từ '{phat_hien[0]}': {phat_hien[1]}."
            viet_lai = phat_hien[2]
        else:
            nhan_dinh = "vua"
            canh_bao = "Từ ngữ chuẩn mực, mô tả đúng mức độ của số liệu."
            viet_lai = loi_van

        ket_qua.append(
            {
                "Ma_cap": ma_cap,
                "So_lieu": so_lieu,
                "Loi_van_goc": loi_van,
                "Danh_gia": nhan_dinh,
                "Canh_bao_kiem_toan": canh_bao,
                "Goi_y_viet_lai": viet_lai,
            }
        )

    return pd.DataFrame(ket_qua)


# Thực thi kiểm toán tự động:
bang_kiem_toan = audit_claim_wording(CAP)
print("Kết quả kiểm toán từ ngữ và khuyến nghị viết lại:")
print(bang_kiem_toan[["Ma_cap", "Danh_gia", "Goi_y_viet_lai"]].to_string(index=False))
Giải thích chi tiết cách 2
danh_muc_rui_ro ghép mỗi cụm từ với lý do và một câu gợi ý. .lower() giúp phép tìm chuỗi không phân biệt các cách viết hoa. Vòng lặp for tu_khoa, ... tìm trong lời văn. break dừng ở cụm đầu tiên khớp, nên một câu có nhiều vấn đề mới được báo một vấn đề.
Khi có cụm khớp, hàm gán qua và đưa gợi ý vào bảng. Khi không khớp, mã hiện gán vua. Nhánh sau chỉ có nghĩa không gặp các cụm đã liệt kê, không chứng minh câu đã đúng. Một nhận định nhân quả dùng từ khác có thể bị bỏ sót, còn từ "ổn định" có thể hoàn toàn phù hợp trong một ngữ cảnh đo trực tiếp độ ổn định.
Các tỷ lệ trong gợi ý đang được viết riêng cho bộ CAP. Hàm không đọc số 3,0% hay 65,4% từ mọi câu đầu vào để tự tính lại. Nếu thay dữ liệu, phải thay gợi ý tương ứng hoặc thiết kế bước trích số và kiểm tra riêng. Câu gợi ý cho cặp 6 cũng cần đọc thận trọng thành "65,4% văn bản khớp quy tắc", thay vì xác nhận chắc chắn ngôn ngữ.
Kết quả thực thi cách 2
| Dòng | Kết quả in ra |
|---|---|
| 1 | Kết quả kiểm toán từ ngữ và khuyến nghị viết lại: |
| 2 | Ma_cap Danh_gia Goi_y_viet_lai |
| 3 | 1 vua Thị trường tăng trưởng mạnh so với cùng kỳ |
| 4 | 2 qua tăng nhẹ 3,0% so với tháng trước |
| 5 | 3 qua tương quan tuyến tính không đáng kể (r = 0,081) |
| 6 | 4 vua Một vài ca cực đoan cần gắn cờ |
| 7 | 5 qua 90,5% chỗ ở có liệt kê tiện nghi Wifi |
| 8 | 6 qua khoảng 65,4% bài đánh giá dùng tiếng Tây Ban Nha theo quy tắc sơ bộ |
So sánh hai cách
Cách 1 yêu cầu đọc và giải thích ý nghĩa từng cặp, nên có thể phát hiện vấn đề mà danh sách từ khóa chưa bao phủ. Cách 2 giúp rà nhiều câu theo một danh sách đã biết. Nó là công cụ nhắc người viết xem lại, không phải bộ xác minh sự thật hay bảo đảm văn bản không còn suy diễn.
Bài tập 3: Tính trung bình gộp khi cơ cấu nhóm thay đổi
Bài tập 3: Tính trung bình có trọng số
Bảng bang gồm hai phân khúc trong mỗi kỳ. Đơn vị giá là nghìn CLP/đêm.
| Kỳ | Phân khúc | Số chỗ ở n | Giá trung bình gia_tb |
|---|---|---|---|
| T9 | Cao | 100 | 60.0 |
| T9 | Rẻ | 100 | 30.0 |
| T6 | Cao | 80 | 66.0 |
| T6 | Rẻ | 220 | 33.0 |
Hãy viết pooled_means(bang, ky="ky", n="n", gia="gia_tb") trả Series giá trung bình gộp theo kỳ. Tên các cột phải được lấy từ tham số. Không sửa bảng đầu vào và không làm tròn trong hàm.
Với hai phân khúc có số lượng n1, n2 và giá trung bình p1, p2, cách gộp là:
Có nhiều phân khúc thì cộng tất cả các tích số lượng với giá, rồi chia cho tổng số lượng. Mỗi chỗ ở có cùng trọng số, nên không lấy trung bình cộng đơn giản của các giá trung bình nhóm khi các nhóm khác quy mô. Dữ liệu mẫu có số lượng và giá đầy đủ, không âm, với tổng số lượng mỗi kỳ lớn hơn 0.
Lời giải
Cách 1: Áp dụng công thức cho từng nhóm kỳ
python
import pandas as pd

# 1. Bảng số liệu minh họa nghịch lý Simpson
bang = pd.DataFrame(
    {
        "ky": ["T9", "T9", "T6", "T6"],
        "phan_khuc": ["cao", "re", "cao", "re"],
        "n": [100, 100, 80, 220],
        "gia_tb": [60.0, 30.0, 66.0, 33.0],
    }
)


def pooled_means(
    bang: pd.DataFrame, ky: str = "ky", n: str = "n", gia: str = "gia_tb"
) -> pd.Series:
    """Tính giá trung bình gộp có trọng số theo từng kỳ."""
    # Nhóm theo cột kỳ và áp dụng công thức trung bình gia quyền
    ket_qua = bang.groupby(ky, sort=False).apply(
        lambda g: (g[n] * g[gia]).sum() / g[n].sum()
    )
    ket_qua.name = "gia_tb_gop"
    return ket_qua


# Gọi thực nghiệm hàm với bảng mẫu:
gop_c1 = pooled_means(bang)
print("Giá trung bình gộp từng kỳ (Cách 1):")
print(gop_c1.round(2))

# Kiểm chứng nghịch lý:
bien_dong = (gop_c1["T6"] / gop_c1["T9"] - 1) * 100
print(f"\nKỳ T9: {gop_c1['T9']:.1f} nghìn CLP -> Kỳ T6: {gop_c1['T6']:.1f} nghìn CLP")
print(
    f"Kết quả gộp: Biến động {bien_dong:.1f}% (GIẢM dù cả hai phân khúc đều tăng 10%)."
)
Giải thích chi tiết cách 1
groupby(ky, sort=False) gom các dòng cùng kỳ và giữ thứ tự kỳ xuất hiện. .apply(...) gọi hàm trên từng nhóm con g. Tích g[n] * g[gia] là phần đóng góp của mỗi phân khúc vào tổng gia quyền. Cộng các tích rồi chia tổng n cho giá trung bình gộp.
Ở T9, tổng gia quyền là 100 * 60 + 100 * 30 = 9000, còn tổng số chỗ ở là 200. Kết quả bằng 45.0. Ở T6, tổng gia quyền là 80 * 66 + 220 * 33 = 12540, chia cho 300 được 41.8.
Hai phân khúc đều tăng 10% nhưng giá gộp giảm khoảng 7,1%. Lấy (66 + 33) / 2 = 49.5 sẽ cho hai phân khúc trọng số bằng nhau, khác với bài toán cho mỗi chỗ ở trọng số bằng nhau. Tên gia_tb_gop gắn vào Series để đầu ra dễ đọc. .round(2) chỉ dùng cho bản in bên ngoài hàm.
Kết quả thực thi cách 1
| Kỳ | Giá trung bình gộp (nghìn CLP/đêm) |
|---|---|
| T9 | 45.0 |
| T6 | 41.8 |
Dòng in biến động là -7.1%. Đây là nghịch lý Simpson do cơ cấu trong dữ liệu giả lập thay đổi, không phải kết luận giá thị trường Santiago đã giảm.
Cách 2: Nhân cả cột trước rồi tổng hợp theo kỳ
python
import pandas as pd

# 1. Bảng số liệu minh họa
bang = pd.DataFrame(
    {
        "ky": ["T9", "T9", "T6", "T6"],
        "phan_khuc": ["cao", "re", "cao", "re"],
        "n": [100, 100, 80, 220],
        "gia_tb": [60.0, 30.0, 66.0, 33.0],
    }
)


def pooled_means(
    bang: pd.DataFrame, ky: str = "ky", n: str = "n", gia: str = "gia_tb"
) -> pd.Series:
    """Tính giá trung bình gộp bằng kỹ thuật vector hóa phép nhân trước khi tổng hợp."""
    # Thực hiện phép nhân vector trực tiếp trên hai Series số học
    doanh_so_tam = bang[n].mul(bang[gia])

    # Gom nhóm và tính tỷ số giữa tổng doanh số và tổng số lượng
    tong_doanh_so = doanh_so_tam.groupby(bang[ky], sort=False).sum()
    tong_so_luong = bang[n].groupby(bang[ky], sort=False).sum()

    trung_binh_gop = tong_doanh_so.div(tong_so_luong)
    trung_binh_gop.name = "gia_tb_gop"
    return trung_binh_gop


# Gọi thực nghiệm hàm với bảng mẫu:
gop_c2 = pooled_means(bang)
print("Giá trung bình gộp từng kỳ (Cách 2):")
print(gop_c2.round(2))
Giải thích chi tiết cách 2
.mul() là phương thức nhân hai Series có căn chỉnh theo chỉ mục. Vì hai Series lấy từ cùng bảng, mỗi số lượng được nhân với đúng giá của dòng đó. Bước này tạo doanh_so_tam mà không thêm cột vào bang. Tên biến chỉ tổng gia quyền dùng để tính giá, chưa phải doanh thu đã phát sinh.
Hai phép groupby(...).sum() lần lượt tính tử số và mẫu số cho mỗi kỳ. .div(tong_so_luong) chia hai Series theo nhãn kỳ. Quy tắc căn chỉnh giúp một tử số T9 không bị chia nhầm cho mẫu số T6 khi thứ tự trình bày khác nhau.
Cách viết dùng các phép nhân và tổng hợp có sẵn, tránh gọi một hàm Python riêng cho mỗi nhóm. Đây thường là hướng phù hợp khi số nhóm lớn. Mức nhanh hơn cụ thể cần đo trên dữ liệu thật. Nếu có ô giá hoặc số lượng khuyết, phải thống nhất tập dòng tham gia cả tử lẫn mẫu trước khi áp dụng công thức.
Kết quả thực thi cách 2
| Dòng | Kết quả in ra |
|---|---|
| 1 | Giá trung bình gộp từng kỳ (Cách 2): |
| 2 | ky |
| 3 | T9 45.0 |
| 4 | T6 41.8 |
| 5 | Name: gia_tb_gop, dtype: float64 |
So sánh hai cách
Cách 1 đặt nguyên công thức trong mỗi nhóm nên dễ đối chiếu với tính tay. Cách 2 tách phần nhân và tổng hợp, phù hợp khi muốn dùng phép toán có sẵn thay cho hàm gọi lại từng nhóm. Hai cách cùng cần tổng trọng số dương và quy tắc dữ liệu khuyết rõ ràng.
Bài tập 4: Tính tỷ trọng để giải thích sự đảo chiều
Bài tập 4: Tính tỷ trọng phân khúc theo kỳ
Viết segment_share(bang, phan_khuc, ky="ky", nhom="phan_khuc", n="n") trả Series tỷ trọng số chỗ ở của phân khúc mục tiêu trong từng kỳ. Tên cột lấy từ tham số. Kỳ không có phân khúc đó vẫn phải có giá trị 0 trong kết quả. Không sửa bảng đầu vào.
Mẫu số là tổng số chỗ ở của kỳ, tử số là số chỗ ở thuộc phân khúc cần lấy. Với phân khúc rẻ, có thể viết ngắn gọn:
Trong bảng hai nhóm, N bằng số chỗ ở giá cao cộng số chỗ ở giá rẻ. Tính tỷ trọng rẻ ở cả hai kỳ và dùng nó để giải thích kết quả 45.0 và 41.8 của Bài 3.
Lời giải
Cách 1: Tính tử, mẫu theo kỳ rồi căn chỉnh chỉ mục
python
import pandas as pd

# 1. Bảng số liệu minh họa
bang = pd.DataFrame(
    {
        "ky": ["T9", "T9", "T6", "T6"],
        "phan_khuc": ["cao", "re", "cao", "re"],
        "n": [100, 100, 80, 220],
        "gia_tb": [60.0, 30.0, 66.0, 33.0],
    }
)


def segment_share(
    bang: pd.DataFrame,
    phan_khuc: str,
    ky: str = "ky",
    nhom: str = "phan_khuc",
    n: str = "n",
) -> pd.Series:
    """Tính tỷ trọng chỗ ở của một phân khúc trong từng kỳ với cơ chế xử lý phân khúc vắng mặt."""
    # 1. Tính tổng quy mô chỗ ở của mọi phân khúc trong từng kỳ
    tong_theo_ky = bang.groupby(ky, sort=False)[n].sum()

    # 2. Lọc dữ liệu thuộc phân khúc mục tiêu
    bang_pk = bang[bang[nhom] == phan_khuc]
    if bang_pk.empty:
        ket_qua_rong = pd.Series(0.0, index=tong_theo_ky.index, name=n)
        return ket_qua_rong

    # 3. Tính tổng số chỗ ở của phân khúc theo từng kỳ
    tong_pk_theo_ky = bang_pk.groupby(ky, sort=False)[n].sum()

    # 4. Tái lập chỉ mục theo danh sách kỳ đầy đủ để gán 0.0 cho kỳ thiếu phân khúc
    ty_trong = (
        tong_pk_theo_ky.reindex(tong_theo_ky.index, fill_value=0.0) / tong_theo_ky
    )
    ty_trong.name = n
    return ty_trong


# Thực thi tính tỷ trọng phân khúc rẻ:
ty_trong_re_c1 = segment_share(bang, "re")
print("Tỷ trọng phân khúc rẻ qua các kỳ (Cách 1):")
print(ty_trong_re_c1.map("{:.1%}".format))
Giải thích chi tiết cách 1
bang.groupby(ky)[n].sum() tính tổng quy mô của mỗi kỳ. Bộ lọc bang[nhom] == phan_khuc chỉ giữ phân khúc cần lấy. Phép tổng hợp thứ hai tính số chỗ ở của phân khúc theo kỳ.
.reindex(tong_theo_ky.index, fill_value=0.0) đặt tử số về đúng danh sách kỳ đầy đủ. Kỳ không có phân khúc mục tiêu được bổ sung số 0 trước khi chia. Nếu phân khúc không có ở bất kỳ kỳ nào, nhánh bang_pk.empty trả ngay Series 0 cùng chỉ mục các kỳ.
T9 có 100 / 200 = 0.5 chỗ ở thuộc phân khúc rẻ. T6 có 220 / 300, xấp xỉ 0.7333. Ở T6, phần đóng góp của nhóm cao là 80 / 300 * 66 = 17.6, nhóm rẻ là 220 / 300 * 33 = 24.2. Cộng lại được 41.8. Tỷ trọng giá rẻ lớn hơn đã kéo số gộp xuống dù cả hai giá nhóm đều tăng.
Kết quả thực thi cách 1
| Kỳ | Số chỗ ở rẻ | Tổng số chỗ ở | Tỷ trọng rẻ |
|---|---|---|---|
| T9 | 100 | 200 | 50.0% |
| T6 | 220 | 300 | 73.3% |
Hàm trả số thực chưa làm tròn. .map("{:.1%}".format) chỉ đổi thành chuỗi phần trăm để in.
Cách 2: Tổng hợp số lượng bằng bảng chéo
python
import pandas as pd

# 1. Bảng số liệu minh họa
bang = pd.DataFrame(
    {
        "ky": ["T9", "T9", "T6", "T6"],
        "phan_khuc": ["cao", "re", "cao", "re"],
        "n": [100, 100, 80, 220],
        "gia_tb": [60.0, 30.0, 66.0, 33.0],
    }
)


def segment_share(
    bang: pd.DataFrame,
    phan_khuc: str,
    ky: str = "ky",
    nhom: str = "phan_khuc",
    n: str = "n",
) -> pd.Series:
    """Tính tỷ trọng phân khúc thông qua bảng chéo tổng hợp chuẩn hóa theo từng hàng."""
    danh_sach_ky = bang[ky].unique()

    # Tạo bảng chéo tính tổng n và chuẩn hóa tỷ lệ theo dòng (normalize='index')
    bang_cheo = pd.crosstab(
        index=bang[ky],
        columns=bang[nhom],
        values=bang[n],
        aggfunc="sum",
        normalize="index",
    )

    # Kiểm tra sự tồn tại của phân khúc trong các cột của bảng chéo
    if phan_khuc not in bang_cheo.columns:
        return pd.Series(0.0, index=pd.Index(danh_sach_ky, name=ky), name=n)

    ket_qua = bang_cheo[phan_khuc].reindex(danh_sach_ky, fill_value=0.0)
    ket_qua.name = n
    return ket_qua


# Thực thi tính tỷ trọng:
ty_trong_re_c2 = segment_share(bang, "re")
print("Tỷ trọng phân khúc rẻ qua các kỳ (Cách 2):")
print(ty_trong_re_c2.map("{:.2%}".format))
Giải thích chi tiết cách 2
pd.crosstab nhận kỳ làm hàng và phân khúc làm cột. values=bang[n] cùng aggfunc="sum" yêu cầu cộng số chỗ ở trong từng ô. Nếu bỏ hai đối số này, bảng sẽ đếm số dòng phân khúc, dẫn đến mỗi kỳ có hai dòng và không phản ánh đúng quy mô 100, 80 hay 220.
normalize="index" chia tổng mỗi ô cho tổng cùng hàng, tạo tỷ trọng các phân khúc. Chọn cột phan_khuc lấy Series cần trả. unique() lưu thứ tự kỳ xuất hiện và reindex đưa kết quả về thứ tự đó. Nếu không có cột phân khúc mục tiêu, hàm tạo Series 0 theo cùng danh sách kỳ.
Tổng tỷ trọng bằng 1 khi các trọng số hợp lệ và tổng mỗi kỳ dương. Dòng khuyết tên nhóm hoặc kỳ có tổng số lượng bằng 0 cần quy tắc riêng. Không nên coi tính chất này đúng vô điều kiện trên mọi bảng đầu vào.
Kết quả thực thi cách 2
| Dòng | Kết quả in ra |
|---|---|
| 1 | Tỷ trọng phân khúc rẻ qua các kỳ (Cách 2): |
| 2 | ky |
| 3 | T9 50.00% |
| 4 | T6 73.33% |
| 5 | Name: n, dtype: object |
So sánh hai cách
Cách 1 chỉ tổng hợp phân khúc đang hỏi và làm rõ việc bổ sung kỳ thiếu. Cách 2 tạo bảng tỷ trọng cho mọi phân khúc trước khi lấy một cột, tiện khi muốn quan sát toàn cơ cấu. Hai cách cùng cho tỷ trọng rẻ 50% và khoảng 73,33%, chỉ khác số chữ số trong bản in.
Bài tập 5: Tính lại số đánh giá theo nhóm quy mô
Bài tập 5: Kiểm tra số trước khi diễn giải
Một báo cáo viết: "Nhóm từ 5 niêm yết trở lên được khách yêu thích hơn, với 15,5 so với 12,7 đánh giá". Trước hết, hãy kiểm tra hai trung bình được tính theo tiêu chí nào.
Viết reviews_by_host_type(ds, nguong=5) trả Series trung bình number_of_reviews_ltm của từng nhóm có mặt trong dữ liệu. Chia nhóm bằng điều kiện calculated_host_listings_count >= nguong, dùng chỉ mục boolean và không thêm cột vào ds. Không làm tròn trong hàm.
Áp dụng trên DEMO_DS với ngưỡng 5 và 10. Chỉ số đếm đánh giá trong 12 tháng gần nhất. Nhãn True nghĩa là đạt ngưỡng quy mô, còn False nghĩa là dưới ngưỡng. Không dùng nhãn này để suy ra nghề nghiệp của chủ nhà. Khi đối chiếu snapshot, ghi rõ 15,5 và 12,7 là số đã làm tròn, khác các giá trị của mẫu giả lập.
Lời giải
Cách 1: Nhóm bằng Series boolean bên ngoài bảng
python
import pandas as pd

# 1. Tập dữ liệu 12 chỗ ở giả lập phục vụ truy số
DEMO_DS = pd.DataFrame(
    {
        "id": range(301, 313),
        "calculated_host_listings_count": [1, 7, 2, 12, 5, 1, 3, 9, 1, 6, 2, 4],
        "number_of_reviews_ltm": [8, 20, 14, 31, 9, 0, 22, 16, 5, 12, 18, 10],
        "review_scores_rating": [
            4.9,
            4.6,
            4.95,
            4.7,
            4.5,
            None,
            4.85,
            4.6,
            4.9,
            4.55,
            4.8,
            4.75,
        ],
    }
)


def reviews_by_host_type(ds: pd.DataFrame, nguong: int = 5) -> pd.Series:
    """Truy số trung bình lượt đánh giá theo nhóm chủ nhà cá nhân và chuyên nghiệp."""
    # Tạo mặt nạ boolean phân loại chủ nhà
    la_chuyen_nghiep = ds["calculated_host_listings_count"] >= nguong

    # Gom nhóm theo mặt nạ boolean và tính trung bình lượt đánh giá trong năm
    trung_binh_danh_gia = ds.groupby(la_chuyen_nghiep)["number_of_reviews_ltm"].mean()
    return trung_binh_danh_gia


# Thực thi kiểm nghiệm trên tập dữ liệu giả lập:
ket_qua_n5 = reviews_by_host_type(DEMO_DS, nguong=5)
ket_qua_n10 = reviews_by_host_type(DEMO_DS, nguong=10)

print("Kết quả truy số với ngưỡng >= 5:")
print(ket_qua_n5.round(1))
print("\nKết quả truy số với ngưỡng >= 10:")
print(ket_qua_n10.round(1))
print("\nKiểm tra tính toàn vẹn: Cột 'chuyen' có bị thêm vào DEMO_DS không?")
print(
    "Có cột lạ:"
    if "chuyen" in DEMO_DS.columns
    else "Bảo đảm bất biến (không thêm cột)."
)
Giải thích chi tiết cách 1
Phép ds["calculated_host_listings_count"] >= nguong tạo một Series boolean cùng chỉ mục. ds.groupby(la_chuyen_nghiep) dùng nó làm khóa nhóm mà không cần gán một cột mới vào ds. Chọn number_of_reviews_ltm rồi gọi .mean() lấy trung bình số đánh giá trong từng nhóm, bỏ ô khuyết theo quy tắc của pandas.
Ở ngưỡng 5, nhóm đạt ngưỡng có năm dòng với số đánh giá 20, 31, 9, 16, 12. Tổng là 88, chia 5 bằng 17.6. Bảy dòng dưới ngưỡng có tổng 77, chia 7 bằng 11.0. Mỗi dòng chỗ ở là một đơn vị trong phép tính, không phải mỗi chủ nhà phân biệt.
Ngưỡng 10 chỉ giữ id 304 trong nhóm True, nên trung bình nhóm ấy bằng 31.0. Nhóm False lúc này có 11 dòng và trung bình làm tròn một chữ số là 12.2. Thay ngưỡng là thay câu hỏi phân nhóm, không phải đổi cùng một nhãn đã được xác nhận từ bên ngoài.
Kết quả thực thi cách 1
| Ngưỡng | Nhóm | Số dòng DEMO | Trung bình 12 tháng gần nhất |
|---|---|---|---|
| 5 | False | 7 | 11.0 |
| 5 | True | 5 | 17.6 |
| 10 | False | 11 | Khoảng 12.2 |
| 10 | True | 1 | 31.0 |
Kiểm tra cuối đoạn mã xác nhận không có cột chuyen được thêm vào mẫu. Kết quả mẫu không phải phép xác minh trực tiếp hai số snapshot 15,5 và 12,7.
Cách 2: Chọn phần tử của mảng số rồi tính trung bình
python
import pandas as pd

# 1. Tập dữ liệu 12 chỗ ở giả lập
DEMO_DS = pd.DataFrame(
    {
        "id": range(301, 313),
        "calculated_host_listings_count": [1, 7, 2, 12, 5, 1, 3, 9, 1, 6, 2, 4],
        "number_of_reviews_ltm": [8, 20, 14, 31, 9, 0, 22, 16, 5, 12, 18, 10],
        "review_scores_rating": [
            4.9,
            4.6,
            4.95,
            4.7,
            4.5,
            None,
            4.85,
            4.6,
            4.9,
            4.55,
            4.8,
            4.75,
        ],
    }
)


def reviews_by_host_type(ds: pd.DataFrame, nguong: int = 5) -> pd.Series:
    """Truy số trung bình đánh giá thông qua tính toán trực tiếp trên mảng NumPy."""
    mang_quy_mo = ds["calculated_host_listings_count"].to_numpy()
    mang_danh_gia = ds["number_of_reviews_ltm"].to_numpy()

    mat_na_chuyen = mang_quy_mo >= nguong
    ket_qua = {}

    # Tính trung bình cho nhóm cá nhân (False) nếu nhóm tồn tại
    if (~mat_na_chuyen).any():
        ket_qua[False] = float(pd.Series(mang_danh_gia[~mat_na_chuyen]).mean())
    # Tính trung bình cho nhóm chuyên nghiệp (True) nếu nhóm tồn tại
    if mat_na_chuyen.any():
        ket_qua[True] = float(pd.Series(mang_danh_gia[mat_na_chuyen]).mean())

    chuoi_ket_qua = pd.Series(ket_qua)
    chuoi_ket_qua.name = "number_of_reviews_ltm"
    return chuoi_ket_qua


# Thực thi kiểm nghiệm:
ket_qua_c2 = reviews_by_host_type(DEMO_DS, nguong=5)
print("Kết quả truy số (Cách 2):")
print(ket_qua_c2.round(1))
Giải thích chi tiết cách 2
.to_numpy() lấy dữ liệu hai cột dưới dạng mảng. Mặt nạ mang_quy_mo >= nguong có một cờ cho mỗi dòng. Dùng mặt nạ và mặt nạ đảo chọn hai tập số đánh giá. .any() kiểm tra một nhóm có phần tử trước khi tính, để không tạo một khóa đại diện cho nhóm vắng mặt.
Từ điển ket_qua dùng boolean làm khóa, rồi pd.Series(ket_qua) đưa về giao diện trả về của đề. Vì hai mảng lấy từ cùng bảng theo cùng thứ tự, mặt nạ chọn đúng các số đánh giá. Chuyển sang mảng làm mất cơ chế căn chỉnh nhãn tự động, nên phải giữ đúng thứ tự này trong suốt phép tính.
Quy tắc bỏ số đánh giá khuyết cần giống Cách 1. Trung bình NumPy thông thường không tự bỏ NaN, nên phải dùng phép tính bỏ khuyết hoặc lọc trước khi tính nếu mở rộng miền dữ liệu. Chỉ kiểm tra .any() của mặt nạ chưa đủ bảo đảm trung bình luôn hữu hạn, vì một nhóm có thể tồn tại nhưng mọi số đo đều khuyết.
Kết quả thực thi cách 2
| Dòng | Kết quả in ra |
|---|---|
| 1 | Kết quả truy số (Cách 2): |
| 2 | False 11.0 |
| 3 | True 17.6 |
| 4 | Name: number_of_reviews_ltm, dtype: float64 |
So sánh hai cách
Cách 1 phù hợp khi dữ liệu đã là và muốn giữ quy tắc căn chỉnh, nhóm và khuyết của pandas. Cách 2 mở rõ việc chọn các mảng số, hữu ích để kiểm tra chéo phép tính. Không có cơ sở coi việc đổi sang NumPy luôn tiết kiệm RAM hoặc an toàn hơn. Hai cách cần thống nhất quy tắc khuyết trước khi so kết quả.
Bài tập 6: Phán quyết về cách đo và diễn giải
Bài tập 6: Chọn kết luận phù hợp với số đo
Giả sử đã tính lại các trung bình số đánh giá và chúng khớp các giá trị làm tròn 15,5 và 12,7 trên snapshot. Điều đó có đủ để giữ câu "được khách yêu thích hơn" không?
Chọn một phán quyết:
- A: Giữ nguyên vì số đúng thì kết luận đúng.
- B: Sửa lời diễn giải về số đánh giá và kiểm tra thêm các số đo phù hợp trước khi nói đến mức yêu thích.
- C: Bác bỏ vì số liệu sai.
Gán phan_quyet, giải thích lựa chọn và nêu bước kiểm tra tiếp theo. Phân biệt lượng đánh giá, số giao dịch và điểm đánh giá. Mô tả cách phân nhóm theo loại phòng hoặc phân khúc giá có thể giúp xem các chênh lệch gộp.
Lời giải
Cách 1: Lập luận theo bốn bước kiểm tra
python
import pandas as pd

# 1. Gán phán quyết chuẩn xác
phan_quyet = "B"

# 2. Xây dựng bảng khung thẩm định khoa học bốn bước
bang_khung_tham_dinh = pd.DataFrame(
    [
        {
            "Buoc": "Bước 1: Truy số (Arithmetic)",
            "Trang_thai": "ĐẠT CHUẨN",
            "Chi_tiet": "Số liệu 15,5 và 12,7 được tính toán hoàn toàn chính xác từ dữ liệu mốc chụp Santiago.",
        },
        {
            "Buoc": "Bước 2: Phương pháp (Methodology)",
            "Trang_thai": "CẢNH BÁO",
            "Chi_tiet": "Biến number_of_reviews_ltm là số lượt đánh giá, chỉ là biến đại diện cho tần suất hoạt động, không đo mức độ yêu thích.",
        },
        {
            "Buoc": "Bước 3: Diễn giải (Interpretation)",
            "Trang_thai": "BÁC BỎ",
            "Chi_tiet": "Dùng từ 'được khách yêu thích hơn' là ngụy biện đánh tráo khái niệm, gán ghép cảm xúc chủ quan không có căn cứ.",
        },
        {
            "Buoc": "Bước 4: Kiểm tra thêm (Stratification)",
            "Trang_thai": "YÊU CẦU",
            "Chi_tiet": "Cần đối chiếu với điểm đánh giá review_scores_rating và kiểm tra phân tầng theo loại phòng và phân khúc giá.",
        },
    ]
)

print(f"Phán quyết được chọn: {phan_quyet}")
print("\nKhung bốn bước thẩm định khoa học:")
print(bang_khung_tham_dinh.to_string(index=False))
Giải thích chi tiết cách 1
Chọn B vì tính đúng một số đo không làm mọi lời diễn giải về nó trở nên đúng. A bỏ qua sự khác nhau giữa lượng và nội dung đánh giá. C phủ nhận số liệu dù giả thiết của bài đã cho biết các giá trị làm tròn được tính lại phù hợp.
number_of_reviews_ltm đếm các lượt đánh giá trong 12 tháng gần nhất. Nhiều lượt đánh giá hơn có thể đi cùng nhiều giao dịch hơn, nhưng tỷ lệ khách viết đánh giá và thời gian hoạt động cũng có thể khác. Chưa có một quy tắc quy đổi đã kiểm định thì không được đồng nhất số đánh giá với số đặt phòng.
Điểm review_scores_rating gần câu hỏi về mức đánh giá hơn so với số lượt, nhưng cũng không đo hoàn hảo cảm xúc của mọi khách. Nó phản ánh những đánh giá có sẵn, với cơ chế người chọn viết đánh giá và tỷ lệ thiếu điểm cần xem xét. Dữ liệu đang có chưa cung cấp một thiết kế nhận diện tác động nhân quả của quy mô chủ nhà.
pd.DataFrame trong lời giải ghi lại bốn bước đã được người viết lựa chọn. Nó không tự tính lại snapshot hoặc tự thẩm định số trong từng dòng văn bản. Cách viết lại phù hợp là: "Trong snapshot này, số đánh giá trung bình trong 12 tháng gần nhất của chỗ ở thuộc nhóm từ 5 niêm yết trở lên cao hơn nhóm dưới ngưỡng, khoảng 15,5 so với 12,7."
Kết quả thực thi cách 1
phan_quyet = "B".
| Bước | Kết quả cần ghi nhận |
|---|---|
| Tính lại số | Các giá trị đã làm tròn khớp theo giả thiết bài |
| Xem cách đo | Cột đếm đánh giá, chưa đo mức yêu thích |
| Rà diễn giải | Bỏ khẳng định "được yêu thích hơn" |
| Kiểm tra thêm | Xem điểm, dữ liệu khuyết và kết quả trong các nhóm phù hợp |
Cách 2: Dùng quy tắc chuỗi để nhắc rà khái niệm
python
import pandas as pd


def audit_claim_methodology(
    claim: str, metric_col: str, proxy_concept: str, target_concept: str
) -> dict:
    """Kiểm toán tự động tính phù hợp giữa biến số thực tế và khái niệm diễn giải."""
    # Phát hiện sự bất tương thích khái niệm
    la_bien_dai_dien = proxy_concept.lower() != target_concept.lower()
    chua_khai_niem_vuot = target_concept.lower() in claim.lower()

    if la_bien_dai_dien and chua_khai_niem_vuot:
        phan_quyet = "B"
        ly_do = (
            f"Phát hiện lỗi suy diễn vượt số liệu: Biến '{metric_col}' chỉ đo lường "
            f"'{proxy_concept}', không đo lường '{target_concept}'. Cần viết lại theo đúng sự thật đo lường."
        )
        khuyen_nghi = f"Viết lại thành: 'có {proxy_concept} cao hơn' thay vì khẳng định '{target_concept}'."
    else:
        phan_quyet = "A"
        ly_do = "Diễn giải phù hợp với bản chất biến số đo lường."
        khuyen_nghi = "Giữ nguyên kết luận."

    return {
        "phan_quyet": phan_quyet,
        "ly_do": ly_do,
        "khuyen_nghi": khuyen_nghi,
    }


# Áp dụng cho kết luận thực tế:
ket_luan = "Chủ nhà chuyên nghiệp được khách yêu thích hơn so với chủ nhà cá nhân — 15,5 so với 12,7 đánh giá/năm."
kiem_toan_pp = audit_claim_methodology(
    claim=ket_luan,
    metric_col="number_of_reviews_ltm",
    proxy_concept="lượng đánh giá",
    target_concept="yêu thích",
)

print("Phán quyết từ hàm kiểm toán:", kiem_toan_pp["phan_quyet"])
print("Lý do chi tiết:", kiem_toan_pp["ly_do"])
print("Khuyến nghị:", kiem_toan_pp["khuyen_nghi"])
Giải thích chi tiết cách 2
Hàm nhận câu viết, tên cột đo và hai mô tả khái niệm. .lower() giúp so chuỗi không phân biệt kiểu chữ. Điều kiện đầu hỏi hai mô tả khái niệm có khác nhau về chữ hay không. Điều kiện sau hỏi khái niệm mục tiêu có xuất hiện nguyên văn trong câu không.
Khi hai điều kiện cùng đúng, hàm trả B kèm lý do và gợi ý. Trong ví dụ, cột đếm lượng đánh giá nhưng câu chứa "yêu thích", nên quy tắc tạo đúng cảnh báo đang cần minh họa.
Hàm không hiểu đồng nghĩa hoặc nhận biết khái niệm chỉ từ tên cột. Hai chuỗi khác nhau về chữ có thể cùng một nghĩa, và một lời suy diễn có thể dùng từ khác để tránh khớp. Nhánh trả A vì không khớp chỉ là không có cảnh báo theo quy tắc này, không phải bằng chứng kết luận đúng. Cần đọc lại cả số đo và lời viết sau khi chạy.
Kết quả thực thi cách 2
| Dòng | Kết quả in ra |
|---|---|
| 1 | Phán quyết từ hàm kiểm toán: B |
| 2 | Lý do chi tiết: Phát hiện lỗi suy diễn vượt số liệu: Biến 'number_of_reviews_ltm' chỉ đo lường 'lượng đánh giá', không đo lường 'yêu thích'. Cần viết lại theo đúng sự thật đo lường. |
| 3 | Khuyến nghị: Viết lại thành: 'có lượng đánh giá cao hơn' thay vì khẳng định 'yêu thích'. |
So sánh hai cách
Cách 1 đưa ra lý do về phạm vi phép đo và bước kiểm tra tiếp theo. Cách 2 minh họa cách biến một dấu hiệu đã biết thành cảnh báo bằng code. Công cụ từ khóa có thể hỗ trợ rà báo cáo nhưng không thay thế việc đánh giá phương pháp hoặc kiểm chứng nguồn dữ liệu.
Bài tập 7: So sánh số lượt và điểm đánh giá
Bài tập 7: Kiểm tra thêm bằng số đo và mẫu số rõ ràng
Viết audit_host_performance(ds, nguong=5) so sánh hai nhóm quy mô niêm yết trên DEMO_DS bằng các chỉ số:
- Tổng số dòng chỗ ở
so_cho_o. - Trung bình số đánh giá trong 12 tháng gần nhất
trung_binh_luot_danh_gia. - Trung bình điểm trên các chỗ ở có điểm
trung_binh_diem_danh_gia. - Tỷ lệ đạt từ 4,8 trở lên trong các chỗ ở có điểm,
ty_le_xuat_sac.
Nêu cả số chỗ ở có điểm để kiểm tra mẫu số. Chia nhóm bằng ngưỡng truyền vào hàm, không suy ra nghề nghiệp từ nhãn. Đọc kết quả như một so sánh mô tả trong mẫu giả lập. Muốn kiểm tra theo loại phòng hoặc dải giá thì cần các cột tương ứng và một bước phân nhóm bổ sung.
Lời giải
Cách 1: Tổng hợp các chỉ số theo nhóm quy mô
python
import numpy as np
import pandas as pd

# 1. Tập dữ liệu 12 chỗ ở giả lập
DEMO_DS = pd.DataFrame(
    {
        "id": range(301, 313),
        "calculated_host_listings_count": [1, 7, 2, 12, 5, 1, 3, 9, 1, 6, 2, 4],
        "number_of_reviews_ltm": [8, 20, 14, 31, 9, 0, 22, 16, 5, 12, 18, 10],
        "review_scores_rating": [
            4.9,
            4.6,
            4.95,
            4.7,
            4.5,
            None,
            4.85,
            4.6,
            4.9,
            4.55,
            4.8,
            4.75,
        ],
    }
)


def audit_host_performance(ds: pd.DataFrame, nguong: int = 5) -> pd.DataFrame:
    """Thẩm định mở rộng: So sánh đồng thời lượt đánh giá và điểm đánh giá thực tế."""
    nhom_chuyen = ds["calculated_host_listings_count"] >= nguong

    bang_tong_hop = ds.groupby(nhom_chuyen).agg(
        so_cho_o=("id", "size"),
        so_cho_o_co_diem=("review_scores_rating", "count"),
        trung_binh_luot_danh_gia=("number_of_reviews_ltm", "mean"),
        trung_binh_diem_danh_gia=("review_scores_rating", "mean"),
        so_cho_o_xuat_sac=("review_scores_rating", lambda s: int((s >= 4.8).sum())),
    )

    bang_tong_hop.index = pd.Index(
        [
            f"Từ {nguong} niêm yết" if flag else f"Dưới {nguong} niêm yết"
            for flag in bang_tong_hop.index
        ],
        name="Phan_loai_chu_nha",
    )
    mau_so = bang_tong_hop["so_cho_o_co_diem"].replace(0, np.nan)
    bang_tong_hop["ty_le_xuat_sac"] = bang_tong_hop["so_cho_o_xuat_sac"] / mau_so
    return bang_tong_hop


# Thực thi phân tích:
bao_cao_mo_rong_c1 = audit_host_performance(DEMO_DS, nguong=5)
print("Báo cáo thẩm định đa chỉ số giữa hai nhóm chủ nhà (Cách 1):")
print(
    bao_cao_mo_rong_c1[
        [
            "so_cho_o",
            "so_cho_o_co_diem",
            "trung_binh_luot_danh_gia",
            "trung_binh_diem_danh_gia",
            "ty_le_xuat_sac",
        ]
    ]
    .round(3)
    .to_string()
)
Giải thích chi tiết cách 1
Series boolean xác định nhóm theo ngưỡng. Trong .agg, mỗi tuple chỉ một cột nguồn và phép tính, giúp đặt tên rõ cho cột đầu ra. Phép đếm dòng cho quy mô nhóm cần khác với đếm ô id không khuyết. Trung bình số lượt và trung bình điểm đều phải nêu rõ những ô khuyết đã không tham gia.
Ở nhóm dưới ngưỡng 5, có bảy chỗ ở nhưng chỉ sáu chỗ ở có điểm. Trung bình điểm của sáu giá trị xấp xỉ 4.86. Trong sáu chỗ ở này có năm điểm từ 4,8 trở lên, nên tỷ lệ theo mẫu số có điểm là 5 / 6, khoảng 83.3%. Nhóm đạt ngưỡng có năm điểm, trung bình 4.59 và không có điểm đạt 4,8.
Dùng 5 / 7 sẽ cho khoảng 71.4%, nhưng đó là tỷ lệ số dòng biết đạt ngưỡng điểm trên toàn nhóm, bao gồm một dòng chưa có điểm. Hai tỷ lệ trả lời hai câu hỏi khác nhau. Bài này chọn mẫu số có điểm để hai cách giải cùng một định nghĩa, đồng thời phải giữ số khuyết trong báo cáo.
Nhóm có nhiều lượt đánh giá hơn trong mẫu lại có trung bình điểm thấp hơn. Điều này cho thấy hai số đo không thể thay thế nhau. Chưa thể từ đây kết luận nhóm nào khiến khách hài lòng hơn hoặc quy mô chủ nhà gây ra khác biệt về điểm.
Kết quả thực thi cách 1
| Nhóm theo ngưỡng 5 | Số chỗ ở | Số có điểm | Lượt đánh giá TB trong 12 tháng | Điểm TB | Tỷ lệ đạt 4,8 trong số có điểm |
|---|---|---|---|---|---|
| Dưới ngưỡng | 7 | 6 | 11.0 | 4.86 | 83.3% |
| Đạt ngưỡng | 5 | 5 | 17.6 | 4.59 | 0.0% |
Điểm trung bình được tính cho mỗi dòng chỗ ở có trọng số bằng nhau. Nó khác trung bình trên mọi lượt đánh giá riêng lẻ khi mỗi chỗ ở có số lượt khác nhau.
Cách 2: Tách các tập có điểm và trả bảng kiểm tra mẫu số
python
import numpy as np
import pandas as pd

# 1. Tập dữ liệu 12 chỗ ở giả lập
DEMO_DS = pd.DataFrame(
    {
        "id": range(301, 313),
        "calculated_host_listings_count": [1, 7, 2, 12, 5, 1, 3, 9, 1, 6, 2, 4],
        "number_of_reviews_ltm": [8, 20, 14, 31, 9, 0, 22, 16, 5, 12, 18, 10],
        "review_scores_rating": [
            4.9,
            4.6,
            4.95,
            4.7,
            4.5,
            None,
            4.85,
            4.6,
            4.9,
            4.55,
            4.8,
            4.75,
        ],
    }
)


def audit_host_performance(ds: pd.DataFrame, nguong: int = 5) -> pd.DataFrame:
    """Thẩm định phân tầng mở rộng an toàn với trường hợp biên và dữ liệu khuyết."""
    cot_chuan = [
        "so_cho_o",
        "so_cho_o_co_diem",
        "trung_binh_luot_danh_gia",
        "trung_binh_diem_danh_gia",
        "ty_le_xuat_sac",
    ]
    if ds.empty:
        return pd.DataFrame(columns=cot_chuan)

    ds_sach = ds.copy()
    ds_sach["la_chuyen_nghiep"] = ds_sach["calculated_host_listings_count"] >= nguong

    danh_sach_ket_qua = []
    for la_chuyen in [False, True]:
        nhom_df = ds_sach[ds_sach["la_chuyen_nghiep"] == la_chuyen]
        n_cho_o = len(nhom_df)
        if n_cho_o == 0:
            continue

        luot_danh_gia_tb = float(nhom_df["number_of_reviews_ltm"].mean())
        diem_hop_le = nhom_df["review_scores_rating"].dropna()
        diem_tb = float(diem_hop_le.mean()) if not diem_hop_le.empty else np.nan
        so_xuat_sac = int((diem_hop_le >= 4.8).sum())
        ty_le_xuat_sac = (
            (so_xuat_sac / len(diem_hop_le)) if not diem_hop_le.empty else np.nan
        )

        nhan_nhom = f"Từ {nguong} niêm yết" if la_chuyen else f"Dưới {nguong} niêm yết"
        danh_sach_ket_qua.append(
            {
                "Nhom_chu_nha": nhan_nhom,
                "so_cho_o": n_cho_o,
                "trung_binh_luot_danh_gia": round(luot_danh_gia_tb, 1),
                "trung_binh_diem_danh_gia": round(diem_tb, 2),
                "so_hop_le_diem": len(diem_hop_le),
                "ty_le_xuat_sac": round(ty_le_xuat_sac, 3),
            }
        )

    df_ket_qua = pd.DataFrame(danh_sach_ket_qua).set_index("Nhom_chu_nha")
    return df_ket_qua


# Thực thi phân tích:
bao_cao_mo_rong_c2 = audit_host_performance(DEMO_DS, nguong=5)
print("Báo cáo kiểm định phân tầng độc lập (Cách 2):")
print(bao_cao_mo_rong_c2.to_string())
Giải thích chi tiết cách 2
Bảng làm việc được sao chép trước khi thêm cột phân nhóm. Vòng lặp qua hai giá trị boolean chọn từng nhóm có mặt. len(nhom_df) đếm toàn bộ chỗ ở, còn .dropna() trên điểm tạo riêng tập có điểm. Hai số lượng cần được giữ tách biệt.
len(diem_hop_le) là mẫu số của tỷ lệ đạt 4,8. So sánh điểm với ngưỡng rồi cộng cờ cho số chỗ ở đạt. .mean() trên tập điểm hợp lệ tính trung bình của các chỗ ở đã có điểm, không phải trung bình có trọng số theo số lượt đánh giá.
Nếu không có điểm hợp lệ, cả trung bình điểm và tỷ lệ đều là NaN. Không thể kết luận tỷ lệ bằng không khi chưa có quan sát. Cột số có điểm giúp người đọc nhận ra giới hạn này. Việc round ở lúc dựng bảng làm kết quả phù hợp để trình bày, nhưng nên giữ số chưa làm tròn nếu còn tính toán tiếp.
Kết quả thực thi cách 2
| Nhóm quy mô | Số chỗ ở | Đánh giá trong 12 tháng gần nhất, trung bình | Điểm trung bình | Số có điểm | Tỷ lệ đạt 4,8 |
|---|---|---|---|---|---|
| Dưới 5 niêm yết | 7 | 11.0 | 4.86 | 6 | 0.833 |
| Từ 5 niêm yết | 5 | 17.6 | 4.59 | 5 | 0.000 |
Tỷ lệ 0.833 tương ứng khoảng 83.3% trên sáu chỗ ở có điểm.
So sánh hai cách
Cách 1 dùng phép để đặt các chỉ số cạnh nhau. Cách 2 mở rõ bước chọn dữ liệu có điểm và đưa số quan sát hợp lệ vào bảng. Hai cách phải dùng cùng mẫu số mới đối chiếu được tỷ lệ. So sánh hai nhóm quy mô chưa phải phân tầng đồng thời theo loại phòng, vị trí hay dải giá và chưa đủ để suy ra nhân quả.
4. Các điểm cần giữ khi viết báo cáo
| Việc cần làm | Câu hỏi để kiểm tra |
|---|---|
| Đặt kết luận trước | Câu đầu đã trả lời đúng câu hỏi chưa? |
| Viết đúng số đo | Đang nói số đánh giá, điểm đánh giá hay số đặt phòng? |
| Nêu kỳ và đơn vị | Là 12 tháng gần nhất hay một năm lịch, giá một đêm hay giá cả kỳ? |
| Kiểm tra số gộp | Quy mô và tỷ trọng các nhóm có thay đổi không? |
| Công bố mẫu số | Tỷ lệ tính trên toàn bộ chỗ ở hay chỉ nhóm có dữ liệu? |
| Giữ giới hạn kết luận | Số liệu chỉ mô tả mẫu hay đã có thiết kế để nhận diện tác động? |
Tài liệu tham khảo
- Minto, B. (2009). The Pyramid Principle: Logic in Writing and Thinking. Financial Times Prentice Hall.
- Simpson, E. H. (1951). The Interpretation of Interaction in Contingency Tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241.
- Huff, D. (1993). How to Lie with Statistics. W. W. Norton & Company.
- Inside Airbnb: Santiago, snapshot ngày 29/06/2026.
Tài liệu tham khảo
- Wes McKinney, Python for Data Analysis, 3rd Edition, Chapter 13: Data Analysis Examples. URL: https://wesmckinney.com/book/data-analysis-examples.
- Viện Trí tuệ Nhân tạo, Trường Đại học Công nghệ, ĐHQGHN: Giáo trình Lập trình xử lý dữ liệu (Bài 14: Kể chuyện bằng dữ liệu và thẩm định phân tích AI). Nội dung thẩm định và nghịch lý tổng hợp được chuyển thể theo giấy phép CC BY-NC-SA 4.0.
- Edward H. Simpson, The Interpretation of Interaction in Contingency Tables, Journal of the Royal Statistical Society, 1951.
- Darrell Huff, How to Lie with Statistics, W. W. Norton & Company.
IAI, Lập trình xử lý dữ liệu, học liệu và notebook. Các đề thực hành đã được biên tập cách diễn đạt và bổ sung lời giải, giữ CC BY-NC-SA 4.0. Giấy phép học liệu.
IAI. Notebook thực hành và học liệu thực hành 2627-1. Các yêu cầu kỹ thuật được đối chiếu, biên tập và bổ sung lời giải cùng dữ liệu minh họa. Phần thích nghi từ học liệu IAI áp dụng giấy phép CC BY-NC-SA 4.0.