Giao diện
Giả sử một tệp nhật ký ghi nhận cùng mốc thời gian 08:00 tại hai máy chủ đặt ở hai thành phố khác nhau: Hà Nội và Tokyo. Liệu đó có phải là cùng một thời điểm vật lý, và tệp nhật ký đang thiếu thông tin gì để có thể đối chiếu chính xác? Nếu thiếu thông tin , hai chuỗi thời gian trông giống nhau về mặt số học nhưng thực chất lại lệch nhau hai tiếng đồng hồ trong thế giới thực.
Bên cạnh , dữ liệu thời gian trong thực tế còn gắn với các quy ước lịch: Năm nhuận có 366 ngày, số ngày giữa các tháng không đều nhau, và quy ước đổi giờ mùa hè có thể làm đồng hồ dịch chuyển. Nếu xử lý bằng cách ghép chuỗi hoặc chia số nguyên đơn thuần, các phép tính thống kê chuỗi thời gian sẽ không phản ánh đúng thực tế.
Bài giảng này trình bày phương pháp xử lý dữ liệu chuỗi thời gian trong Python và pandas: Phân biệt ba phạm trù thời gian, kỹ thuật quản trị , các phép cắt lát chuỗi trên DatetimeIndex, cấu trúc kỳ Period, kỹ thuật lấy mẫu lại (resample), làm mượt dao động bằng (rolling và ewm), cùng phương pháp so sánh cùng kỳ.
1. Ba phạm trù: Điểm thời gian, Khoảng thời gian và Kỳ
Để tư duy mạch lạc và tránh những lỗi sai khi lập trình, ta cần phân biệt ba khái niệm thời gian khác nhau trong phân tích dữ liệu:
- Điểm thời gian (Timestamp): Đại diện cho một khoảnh khắc cố định duy nhất trên trục thời gian liên tục, chẳng hạn đúng 09:15:30 ngày 15 tháng 3 năm 2026. Trong pandas, đối tượng đại diện là
pd.Timestamp(tương đương vớidatetime.datetimecủa Python chuẩn nhưng hỗ trợ độ phân giải micro giây hoặc nano giây). - Khoảng thời gian (Timedelta): Đại diện cho độ dài của một khoảng cách thời gian giữa hai biến cố, không gắn với bất kỳ ngày tháng cụ thể nào, chẳng hạn khoảng thời gian kéo dài 48 giờ hoặc 3 ngày 5 tiếng. Đối tượng tương ứng là
pd.Timedelta. - Kỳ (Period): Đại diện cho một khoảng thời gian hữu hạn gắn liền với một nhịp lịch thiên văn hay lịch tài chính, ví dụ trọn vẹn tháng 3 năm 2026 hoặc Quý 2 năm 2026. Một thời điểm nằm trong tháng 3 không đồng nghĩa với toàn bộ khoảng thời gian của tháng 3. Đối tượng đại diện là
pd.Period.
python
import numpy as np
import pandas as pd
from datetime import datetime, timedelta

# 1. Điểm thời gian (Timestamp)
t1 = pd.Timestamp("2026-03-15 09:15:30")
t2 = pd.Timestamp("2026-03-18 15:30:00")

# 2. Khoảng thời gian (Timedelta) sinh ra từ hiệu của hai Timestamp
khoang_thoi_gian = t2 - t1
khoang_cach = khoang_thoi_gian
print("Khoảng thời gian:", khoang_thoi_gian)      # 3 days 06:14:30
print("Số ngày thực tế:", khoang_thoi_gian.days)  # 3
print("Tổng số giây:", khoang_thoi_gian.total_seconds())

# 3. Kỳ (Period)
ky_thang = pd.Period("2026-03", freq="M")
print("Kỳ tháng 3:", ky_thang)
print("Bắt đầu:", ky_thang.start_time, "-> Kết thúc:", ky_thang.end_time)
Khi chuyển đổi văn bản sang ngày tháng, hai điểm quan trọng cần lưu ý là định dạng ngày tháng và việc xử lý dữ liệu không hợp lệ:
- Chỉ định tường minh định dạng bằng tham số
format: Chuỗi"02/03/2026"đối với người Việt Nam hay người Anh là ngày 2 tháng 3, nhưng đối với người Mỹ lại là ngày 3 tháng 2. Nếu không chỉ định tường minhformat="%d/%m/%Y", pandas sẽ phải tự phỏng đoán dựa trên dữ liệu mẫu và có thể hoán đổi ngày thành tháng khi ngày nhỏ hơn hoặc bằng 12. - Xử lý chuỗi không hợp lệ bằng
errors="coerce": Tháng 2 không có ngày 30 hay 31. Khi gặp chuỗi không hợp lệ như"31/02/2026", nếu để mặc định chương trình sẽ ném ngoại lệ dừng thực thi. Tham sốerrors="coerce"sẽ chuyển các giá trị lỗi này thành giá trịNaT(Not a Time, hằng số khuyết thiếu chuẩn dành riêng cho dữ liệu thời gian trong pandas).
python
chuoi_ngay = pd.Series(["01/02/2026", "15/02/2026", "31/02/2026", "chua_xac_dinh"])
ngay_chuan = pd.to_datetime(chuoi_ngay, format="%d/%m/%Y", errors="coerce")

print("Kết quả chuẩn hóa:")
print(ngay_chuan)
print("Mảng nhận diện khuyết thiếu:", ngay_chuan.isna().tolist())
2. Quản trị múi giờ: Phân biệt localize và convert
Một vấn đề phổ biến trong các hệ thống lưu trữ dữ liệu là việc ghi nhận thời gian dưới dạng chuỗi hoặc số nguyên mà không kèm thông tin . Khi hệ thống mở rộng đa quốc gia, thời điểm 08:00 sáng tại Tokyo (UTC+9) dễ bị nhầm lẫn với 08:00 sáng tại Hà Nội (UTC+7) hoặc London (UTC+0), dẫn đến việc đối chiếu giao dịch bị sai lệch thời điểm vật lý.
Trong pandas, dữ liệu thời gian được phân loại thành hai trạng thái:
- Thời gian chưa gắn (Timezone-naive): Dữ liệu chỉ ghi nhận giờ số học đơn thuần, không chứa thông tin về độ lệch múi giờ so với giờ phối hợp quốc tế (UTC).
- Thời gian đã gắn (Timezone-aware): Dữ liệu gắn liền với một múi giờ cụ thể theo chuẩn cơ sở dữ liệu quốc tế IANA (ví dụ:
Asia/Ho_Chi_Minh,Europe/London,America/New_York).
Hai phép toán quản trị mang ý nghĩa hoàn toàn khác nhau:
python
# Tạo điểm thời gian chưa gắn múi giờ (tz-naive)
t_chua_mui_gio = pd.Timestamp("2026-03-15 08:00:00")

# 1. tz_localize: Gán thông tin múi giờ thực địa cho dữ liệu chưa gắn múi giờ
# Giữ nguyên số giờ hiển thị, chỉ gắn thêm ngữ cảnh múi giờ địa phương
t_ha_noi = t_chua_mui_gio.tz_localize("Asia/Ho_Chi_Minh")
print("Giờ Hà Nội:", t_ha_noi)  # 2026-03-15 08:00:00+07:00

# 2. tz_convert: Chuyển đổi một Timestamp đã gắn múi giờ sang múi giờ khác
# Mốc thời gian vật lý giữ nguyên, số giờ hiển thị được tính lại theo múi giờ đích
t_utc = t_ha_noi.tz_convert("UTC")
t_london = t_ha_noi.tz_convert("Europe/London")

print("Giờ UTC:", t_utc)        # 2026-03-15 01:00:00+00:00 (lùi 7 tiếng)
print("Giờ London:", t_london)  # 2026-03-15 01:00:00+00:00
Lưu ý về điều kiện nguồn và phân biệt hai phương thức:
- Phương thức
tz_localizechỉ áp dụng cho dữ liệu chưa gắn . Nếu gọitz_localizetrên một Timestamp đã gắn múi giờ, pandas sẽ ném ngoại lệTypeError. - Phương thức
tz_convertchỉ hoạt động trên dữ liệu đã gắn . Nếu gọi trên dữ liệu chưa gắn múi giờ, pandas sẽ báo lỗi do không có mốc tham chiếu ban đầu. - Khi chuyển đổi chuỗi bằng
pd.to_datetime(..., utc=True): Nếu chuỗi nguồn là giờ địa phương chưa có thông tin (ví dụ"2026-03-15 08:00:00"), pandas sẽ coi con số08:00đó vốn là giờ UTC rồi gắn nhãn+00:00. Nếu sự kiện thực tế phát sinh tại Hà Nội (UTC+7), cách làm này khiến mốc thời gian bị lệch 7 tiếng. Quy trình chính xác là: Gọitz_localizevới múi giờ thực địa trước, sau đó nếu cần lưu trữ thống nhất theo chuẩn quốc tế mới gọitz_convert("UTC").
Khi thực hiện phép tính giữa hai Series có khác nhau, pandas sẽ tự động quy đổi cả hai về chuẩn UTC trước khi thực hiện phép toán, bảo đảm kết quả thời gian tuyệt đối luôn chính xác.
3. Chỉ mục thời gian DatetimeIndex và kỹ thuật cắt lát chuỗi ký tự
Khi đưa một cột ngày tháng đã chuẩn hóa thành của bằng set_index("date") và sắp xếp tăng dần bằng sort_index(), bảng dữ liệu trở thành một chuỗi thời gian thực thụ.
Lợi ích lớn nhất của DatetimeIndex là khả năng cắt lát thông minh bằng chuỗi văn bản (String ) mà không cần viết các biểu thức logic phức tạp:
python
# Thiết lập chuỗi thời gian mẫu gồm 1000 ngày
chi_muc = pd.date_range("2024-01-01", periods=1000, freq="D")
gia_tri = np.random.normal(loc=100, scale=15, size=len(chi_muc))
ts = pd.Series(gia_tri, index=chi_muc)

# 1. Cắt lát theo cả năm: Tự động lọc toàn bộ các ngày thuộc năm 2025
nam_2025 = ts.loc["2025"]
print("Số ngày trong năm 2025:", len(nam_2025))

# 2. Cắt lát theo tháng cụ thể
thang_05_2025 = ts.loc["2025-05"]
print("Số ngày trong tháng 5/2025:", len(thang_05_2025))

# 3. Cắt lát theo khoảng thời gian tùy ý (kết quả bao gồm cả hai đầu mút)
khoang_thoi_gian = ts.loc["2025-06-15":"2025-07-15"]
print("Khoảng từ 15/06 đến 15/07:", len(khoang_thoi_gian))
Cơ chế này hoạt động đạt hiệu năng cao nhờ thuật toán tìm kiếm nhị phân trên đơn điệu tăng dần (is_monotonic_increasing). Nếu chỉ mục chưa được sắp xếp, thao tác cắt lát chuỗi có thể trả về kết quả sai hoặc ném ra cảnh báo nghiêm trọng.
Xử lý chuỗi thời gian có chỉ mục trùng lặp
Trong nhiều hệ thống (như nhật ký giao dịch ngân hàng hoặc cảm biến IoT), nhiều bản ghi có thể phát sinh tại cùng một thời điểm:
python
dup_idx = pd.to_datetime(["2026-03-01", "2026-03-01", "2026-03-02"])
dup_ts = pd.Series([10, 20, 30], index=dup_idx)

print("Chỉ mục có đơn nhất không?", dup_ts.index.is_unique) # False
print("Truy vấn ngày 2026-03-01:")
print(dup_ts.loc["2026-03-01"]) # Trả về một Series gồm 2 phần tử

# Gom nhóm theo chỉ mục để hợp nhất các bản ghi trùng lặp
hop_nhat = dup_ts.groupby(level=0).sum()
print("Sau khi gộp theo mốc thời gian:")
print(hop_nhat)
4. Dải ngày, Tần số và Phép dịch chuyển dữ liệu
Sinh dải ngày bằng pd.date_range và mã tần số hiện đại
Hàm pd.date_range nhận mốc bắt đầu, mốc kết thúc, số lượng chu kỳ (periods) và mã tần số (freq). Trong pandas hiện đại, các mã tần số đã được quy chuẩn hóa rõ ràng:
| Mã tần số mới | Ý nghĩa chu kỳ |
|---|---|
"D" | Theo ngày theo lịch (Calendar day) |
"B" | Theo ngày làm việc (Business day, thứ Hai đến thứ Sáu) |
"W" hoặc "W-MON" | Theo tuần (mặc định Chủ nhật hoặc neo vào thứ Hai) |
"ME" | Cuối tháng (Month End) |
"MS" | Đầu tháng (Month Start) |
"QE" | Cuối quý (Quarter End) |
"QS" | Đầu quý (Quarter Start) |
"YE" | Cuối năm (Year End) |
Bên cạnh các tần số cơ bản, pandas cung cấp các lớp Date Offsets linh hoạt trong module pandas.tseries.offsets:
python
from pandas.tseries.offsets import Day, MonthEnd, WeekOfMonth

moc = pd.Timestamp("2026-03-15")

# Dịch chuyển đến ngày cuối cùng của tháng hiện tại
cuoi_thang = moc + MonthEnd()
print("Cuối tháng 3:", cuoi_thang) # 2026-03-31

# Tần số tuần trong tháng (Week of Month), ví dụ: Ngày thứ Sáu tuần thứ 3 mỗi tháng
thu_sau_tuan_3 = pd.date_range("2026-01-01", periods=3, freq="WOM-3FRI")
print("Thứ Sáu tuần thứ 3 các tháng đầu năm 2026:")
for d in thu_sau_tuan_3:
    print(d.strftime("%Y-%m-%d"))
Dịch chuỗi và Cạm bẫy thiếu tháng
Phương thức shift() cho phép dịch chuyển dữ liệu tiến hoặc lùi dọc theo chuỗi:
shift(1): Dịch dữ liệu lùi 1 vị trí (dòng hiện tại nhận giá trị của dòng trước đó).shift(-1): Dịch dữ liệu tiến 1 vị trí (dòng hiện tại nhận giá trị của tương lai).
Một sai lầm rất nguy hiểm là việc ngộ nhận rằng shift(1) luôn lấy đúng giá trị của tháng trước:
python
# Giả sử tập dữ liệu bị khuyết toàn bộ tháng 2 năm 2026
chuoi_thieu = pd.Series([100, 150, 180], index=pd.to_datetime(["2026-01-31", "2026-03-31", "2026-04-30"]))

# Dịch chuyển theo số hàng thuần túy
dich_hang = chuoi_thieu.shift(1)
print("Dịch theo hàng:")
print(pd.DataFrame({"Gia_tri": chuoi_thieu, "Shift_1": dich_hang}))
Tại dòng tháng 3 (2026-03-31), cột Shift_1 nhận 100 của tháng 1 vì shift(1) lùi một hàng trong bảng đang có. Nếu muốn so với tháng liền trước theo lịch, có thể đưa chuỗi về lịch tháng đầy đủ bằng asfreq("ME") rồi dịch một hàng:
python
chuoi_chuan_lich = chuoi_thieu.asfreq("ME")
print("Sau khi chèn mốc lịch chuẩn xác:")
print(pd.DataFrame({
    "Gia_tri": chuoi_chuan_lich,
    "Shift_lich": chuoi_chuan_lich.shift(1)
}))
Giờ đây, tháng 3 nhận giá trị NaN vì tháng 2 liền trước thực sự không có số liệu, bảo đảm tính trung thực của các phân tích tăng trưởng.
Ngoài ra, ta có thể dịch chuyển chính trục thời gian (giữ nguyên giá trị) bằng cách truyền thêm tham số freq: ts.shift(2, freq="ME") sẽ tịnh tiến toàn bộ các nhãn thời gian thêm 2 tháng.
5. Kỳ (Period) và số học trên kỳ
Đối tượng pd.Period đại diện cho một khoảng thời gian hữu hạn (kỳ lịch) thay vì một thời điểm đơn lẻ.
Chuyển đổi tần số kỳ
Một kỳ năm có thể được phân rã thành các kỳ nhỏ hơn (tháng hoặc ngày làm việc), với tùy chọn neo vào đầu kỳ (how="start") hoặc cuối kỳ (how="end"):
python
p_nam = pd.Period("2026", freq="Y")

# Chuyển đổi sang ngày làm việc đầu tiên và cuối cùng của năm
p_ngay_dau = p_nam.asfreq("B", how="start")
p_ngay_cuoi = p_nam.asfreq("B", how="end")

print("Ngày làm việc đầu năm 2026:", p_ngay_dau)   # 2026-01-01
print("Ngày làm việc cuối năm 2026:", p_ngay_cuoi) # 2026-12-31
Kỳ quý tài chính
Trong kế toán doanh nghiệp, năm tài chính thường không trùng với năm dương lịch (ví dụ kết thúc vào tháng 11: Q-NOV):
python
p_quy = pd.Period("2026Q1", freq="Q-NOV")
print("Quý 1 tài chính bắt đầu từ:", p_quy.start_time, "đến:", p_quy.end_time)
Chuyển đổi giữa Timestamp và Period
Chuyển từ mốc thời gian sang kỳ bằng to_period(), và chuyển ngược lại điểm thời gian bằng to_timestamp():
python
ngay_ts = pd.date_range("2026-01-15", periods=3, freq="MS")
chu_ky = ngay_ts.to_period("M")
print("Chuyển sang Period:", chu_ky)

ve_timestamp = chu_ky.to_timestamp(how="end")
print("Chuyển ngược về Timestamp cuối kỳ:", ve_timestamp)
Ta cũng có thể tạo trực tiếp một PeriodIndex từ hai mảng số nguyên biểu diễn năm và quý:
python
nam = [2025, 2025, 2026, 2026]
quy = [3, 4, 1, 2]
p_idx = pd.PeriodIndex.from_fields(year=nam, quarter=quy, freq="Q")
print("PeriodIndex từ mảng năm và quý:", p_idx)
6. Lấy mẫu lại (Resampling): Tần số, Biên đóng mở và Bẫy kỳ dang dở
Lấy mẫu lại (resample) là quá trình chuyển đổi tần số của một chuỗi thời gian, đóng vai trò như phép toán groupby chuyên biệt trên trục thời gian.
Lấy mẫu giảm tần số (Downsampling) và quy tắc biên closed, label
Downsampling là việc gộp dữ liệu từ tần số cao xuống tần số thấp hơn (ví dụ từ phút sang giờ, từ ngày sang tháng). Khi gộp các khoảng thời gian, hai tham số quyết định ranh giới tính toán:
closed: Xác định biên nào của khoảng thời gian được tính vào kỳ. Mặc định đối với các tần số cuối kỳ như"ME","QE"làclosed="right"(nhận cận phải).label: Xác định nhãn hiển thị của kỳ gộp. Mặc định làlabel="right"(lấy mốc thời gian của cận phải làm đại diện).
python
ngay_gd = pd.to_datetime(["2026-01-05", "2026-01-20", "2026-02-14", "2026-03-01", "2026-03-25"])
df_gd = pd.DataFrame({"tien": [100, 200, 150, 300, 250]}, index=ngay_gd)

# Lấy mẫu theo tháng kết thúc (Month End)
thang_gd = df_gd.resample("ME").agg(tong_tien=("tien", "sum"), so_gd=("tien", "count"))
print(thang_gd)
Lấy mẫu OHLC trong phân tích tài chính
Trong giao dịch tài chính và cảm biến kỹ thuật, người ta thường quan tâm đến 4 giá trị đặc trưng trong từng khung thời gian: Giá mở cửa (Open), giá cao nhất (High), giá thấp nhất (Low), và giá đóng cửa (Close):
python
rng_phut = pd.date_range("2026-01-01", periods=10, freq="1min")
ts_gia = pd.Series([10, 12, 9, 15, 14, 13, 18, 11, 16, 20], index=rng_phut)

bang_ohlc = ts_gia.resample("5min").ohlc()
print("Bảng tóm tắt OHLC 5 phút:")
print(bang_ohlc)
Lấy mẫu tăng tần số (Upsampling) và các phương pháp nội suy
Upsampling là việc chuyển từ tần số thấp lên tần số cao hơn (ví dụ từ tháng sang ngày). Thao tác này làm phát sinh các mốc thời gian chưa có giá trị quan sát:
python
chuoi_thap = pd.Series([10.0, 20.0], index=pd.to_datetime(["2026-01-01", "2026-01-03"]))

# 1. Để trống bằng asfreq
up_trong = chuoi_thap.resample("D").asfreq()

# 2. Điền tiến (Forward Fill)
up_ffill = up_trong.ffill()

# 3. Nội suy tuyến tính (Linear Interpolation)
up_interp = up_trong.interpolate(method="linear")

print(pd.DataFrame({
    "Goc": up_trong,
    "Forward_Fill": up_ffill,
    "Noi_suy": up_interp
}))
Lấy mẫu thời gian theo nhóm (Grouped Time Resampling)
Khi bảng dữ liệu có nhiều thực thể (ví dụ nhiều cửa hàng hoặc chi nhánh), ta kết hợp groupby với pd.Grouper:
python
df_ban_hang = pd.DataFrame({
    "ngay": pd.to_datetime(["2026-01-05", "2026-01-20", "2026-02-10", "2026-01-15", "2026-02-25"]),
    "chi_nhanh": ["HN", "HN", "HN", "SG", "SG"],
    "doanh_thu": [100, 150, 200, 300, 400]
})

doanh_thu_thang_nhom = df_ban_hang.groupby(
    ["chi_nhanh", pd.Grouper(key="ngay", freq="ME")]
)["doanh_thu"].sum()
print("Doanh thu theo chi nhánh và tháng:")
print(doanh_thu_thang_nhom)
Lưu ý khi xử lý kỳ chưa trọn vẹn (Incomplete Period)
Giả sử bạn trích xuất dữ liệu của một hệ thống vào ngày 29 tháng 6 năm 2026. Khi gọi resample("QE").sum(), pandas sẽ gom toàn bộ các ngày từ tháng 4 đến hết ngày 29/6 vào Quý 2 năm 2026 và gán nhãn là ngày kết thúc quý: 2026-06-30.
Tuy nhiên, Quý 2 thực tế có 91 ngày, trong khi dữ liệu mới chỉ ghi nhận đến ngày 29 (thiếu ngày 30). Khi đem so sánh tổng doanh thu hoặc số lượng đánh giá của Quý 2 với Quý 1 (vốn đã trọn vẹn 90 ngày), con số của Quý 2 trông như bị sụt giảm. Nếu người phân tích đưa con số này vào biểu đồ so sánh tổng mà không chú thích, người đọc sẽ nhận định sai lầm rằng hoạt động kinh doanh suy thoái.
Quy tắc thẩm định: Khi mốc chụp dữ liệu nằm trước ngày kết thúc của kỳ tổng hợp, kỳ đó là kỳ chưa trọn vẹn. Ta cần loại bỏ kỳ này khỏi các phân tích so sánh tổng sản lượng, hoặc phải chuẩn hóa thành chỉ số trung bình theo ngày.
7. Cửa sổ trượt, Làm mượt hàm mũ và So sánh cùng kỳ
Cửa sổ trượt (Rolling Windows)
Phương pháp tính giá trị trung bình trên một khoảng thời gian di động dọc theo chuỗi dữ liệu:
Trong thực tế, cửa sổ 7 ngày (rolling(7) hoặc rolling("7D")) thường được ưu tiên vì nó bao trọn một chu kỳ tuần (từ thứ Hai đến Chủ nhật), triệt tiêu dao động ngày trong tuần.
center=False(mặc định): Giá trị tại thời điểmchỉ dùng dữ liệu của và quá khứ. Đây là lựa chọn bắt buộc cho bài toán dự báo nhằm tránh rò rỉ thông tin tương lai. center=True: Giá trị tạilà trung bình của quá khứ, hiện tại và tương lai. Phương pháp này loại bỏ độ trễ pha (phase lag), hỗ trợ định vị chính xác thời điểm đạt đỉnh trong các báo cáo hồi cứu.
Làm mượt theo hàm mũ (Exponentially Weighted Moving)
Phương pháp gán trọng số đồng đều cho mọi ngày trong cửa sổ. Trái lại, phương pháp làm mượt hàm mũ (EWM) gán trọng số giảm dần theo cấp số nhân khi càng lùi xa về quá khứ:
python
s_gia = pd.Series([10.0, 12.0, 15.0, 14.0, 16.0])

# Tính trung bình trượt hàm mũ với span = 3
ewm_tb = s_gia.ewm(span=3).mean()
print("EWM làm mượt:")
print(pd.DataFrame({"Goc": s_gia, "EWM": ewm_tb}))
Cửa sổ trượt trên hai chuỗi (Binary Moving Windows)
Thuật ngữ "binary" ở đây chỉ phép toán hai ngôi thực hiện trên hai chuỗi dữ liệu (two series), hoàn toàn không mang nghĩa dữ liệu nhận giá trị nhị phân 0 hoặc 1.
Các phương thức như s1.rolling(w).corr(s2) hoặc s1.rolling(w).cov(s2) yêu cầu hai chuỗi s1 và s2 có cùng thời gian, tính toán hệ số tương quan hoặc hiệp phương sai trượt trên từng khung cửa sổ kích thước
python
ngay_gd = pd.date_range("2026-01-01", periods=10, freq="D")
s1 = pd.Series([10, 12, 11, 14, 16, 15, 18, 19, 21, 22], index=ngay_gd)
s2 = pd.Series([100, 105, 102, 110, 115, 112, 120, 122, 130, 132], index=ngay_gd)

# Tính tương quan trượt trên cửa sổ 5 ngày
tuong_quan_truot = s1.rolling(5).corr(s2)
print("Tương quan trượt 5 ngày:")
print(tuong_quan_truot.dropna())
So kỳ liền trước (MoM) so với So cùng kỳ năm trước (YoY)
Công thức tính tỷ lệ tăng trưởng phần trăm:
- MoM (Month-over-Month): Dùng
pct_change(1)để đo xung lực biến động ngắn hạn giữa hai tháng liền kề. - YoY (Year-over-Year): Dùng
pct_change(12)để đối chiếu các vị trí mùa tương ứng giữa hai năm liên tiếp (ví dụ so tháng 3 năm nay với tháng 3 năm trước). Phép so sánh này giúp loại bỏ ảnh hưởng của mô hình mùa cố định hàng năm, nhưng không tự bảo đảm triệt tiêu toàn bộ yếu tố mùa vụ nếu biên độ mùa vụ thay đổi theo chu kỳ kinh tế hoặc có sự chênh lệch về số ngày làm việc trong tháng.
python
doanh_thu_thang = pd.Series(
    [100, 110, 105, 120, 130, 125, 140, 150, 145, 160, 170, 200,
     120, 125, 118, 135, 145, 140, 155, 170, 160, 180, 190, 230],
    index=pd.date_range("2024-01-31", periods=24, freq="ME")
)

tang_truong_mom = doanh_thu_thang.pct_change(periods=1) * 100
tang_truong_yoy = doanh_thu_thang.pct_change(periods=12) * 100

bao_cao = pd.DataFrame({
    "Doanh_thu": doanh_thu_thang,
    "Tang_truong_MoM(%)": tang_truong_mom,
    "Tang_truong_YoY(%)": tang_truong_yoy
})
print(bao_cao.tail(5))
9. Tổng kết
| Khái niệm kỹ thuật | Công cụ trong pandas | Lưu ý thực hành và Ranh giới |
|---|---|---|
DatetimeIndex | set_index(), sort_index() | Sắp xếp tăng dần để tối ưu tìm kiếm nhị phân và cho phép cắt lát chuỗi ký tự tự nhiên. |
tz_localize(), tz_convert() | tz_localize gán ngữ cảnh cho dữ liệu chưa gắn , còn tz_convert đổi tọa độ giờ cho dữ liệu đã gắn múi giờ. | |
| Dịch chuỗi | shift(1), asfreq("ME") | Dịch theo hàng không đồng nghĩa với dịch theo lịch, do đó cần đưa về lưới thời gian đều trước khi dịch. |
Kỳ Period | pd.Period, PeriodIndex | Đại diện cho khoảng thời gian hữu hạn, chuyển đổi qua lại với Timestamp bằng to_period() và to_timestamp(). |
| Lấy mẫu lại | resample("ME"), ohlc() | Lấy mẫu giảm tần số cần chú ý kỳ chưa trọn vẹn, còn lấy mẫu tăng tần số cần chọn phép nội suy thích hợp. |
rolling(), ewm() | Dùng center=False để phòng chống rò rỉ tương lai, và dùng ewm khi muốn ưu tiên quan sát gần nhất. Cửa sổ trên hai chuỗi áp dụng cho cặp chuỗi cùng . | |
| So cùng kỳ (YoY) | pct_change(12) | Đối chiếu các vị trí mùa tương ứng giữa hai năm, hỗ trợ nhận định tốc độ tăng trưởng dài hạn. |
Tài liệu tham khảo
- Wes McKinney, Python for Data Analysis, 3rd Edition, Chapter 11: Time Series. URL: https://wesmckinney.com/book/time-series.
- Tài liệu chính thức pandas: Time Series / Date Functionality. URL: https://pandas.pydata.org/docs/user_guide/timeseries.html.
- Cơ sở dữ liệu quốc tế IANA: Time Zone Database. URL: https://www.iana.org/time-zones.
- Viện Trí tuệ Nhân tạo, Trường Đại học Công nghệ, ĐHQGHN: Giáo trình Lập trình xử lý dữ liệu (Bài 8: Xử lý dữ liệu thời gian). Các bài tập thực hành được chuyển thể theo giấy phép CC BY-NC-SA 4.0.
- IAI, Lập trình xử lý dữ liệu, học liệu và notebook. Các đề thực hành đã được biên tập cách diễn đạt và bổ sung lời giải, giữ CC BY-NC-SA 4.0. Giấy phép học liệu.
8. Bài tập thực hành
Bài tập 1: Tính số đêm lưu trú và bẫy định dạng
Mỗi hàng trong bảng sau là một lượt đặt chỗ lưu trú, với ngày đến và ngày đi được ghi dưới dạng chuỗi theo quy ước DD/MM/YYYY:
python
dat = pd.DataFrame({
    "vao": ["03/07/2026", "10/07/2026"],
    "ra": ["06/07/2026", "12/07/2026"],
})
Hãy viết đoạn mã tính số đêm lưu trú thực tế của từng lượt khách. Giải thích điều gì xảy ra nếu lập trình viên không cung cấp tham số format tường minh cho pd.to_datetime.
Lời giải chi tiết
Nếu không truyền format="%d/%m/%Y", pandas mặc định phỏng đoán theo chuẩn quốc tế hoặc quy ước Mỹ (MM/DD/YYYY). Chuỗi "03/07/2026" sẽ bị hiểu thành ngày 7 tháng 3 năm 2026 thay vì ngày 3 tháng 7. Do đó, khoảng thời gian sẽ bị kéo dài thành 92 đêm và 61 đêm một cách phi lý.
Mã nguồn chuẩn xác:
python
vao = pd.to_datetime(dat["vao"], format="%d/%m/%Y")
ra = pd.to_datetime(dat["ra"], format="%d/%m/%Y")
so_dem = (ra - vao).dt.days

print("Số đêm thực tế:", so_dem.tolist())
# Kết quả chính xác: [3, 2]
Bài tập 2: Tính trung bình số đánh giá mỗi ngày trong tuần
Hệ thống thu thập dữ liệu ghi nhận số lượt đánh giá trong tuần từ ngày 01/06/2026 đến ngày 07/06/2026. Tuy nhiên, bảng dữ liệu chỉ ghi nhận những ngày thực tế có khách viết đánh giá:
python
df_danh_gia = pd.DataFrame({
    "ngay": pd.to_datetime(["2026-06-01", "2026-06-03", "2026-06-07"]),
    "so_luong": [2, 1, 4]
}).set_index("ngay")
Giả thiết rằng trong tuần này hệ thống hoạt động liên tục và việc thu thập dữ liệu diễn ra đầy đủ, các ngày không xuất hiện trong bảng là những ngày thực tế không phát sinh lượt đánh giá nào (số lượng bằng 0). Hãy tính số lượt đánh giá trung bình mỗi ngày trong toàn bộ tuần khảo sát gồm 7 ngày này.
Lời giải chi tiết
Nếu gọi trực tiếp df_danh_gia["so_luong"].mean(), kết quả sẽ là
Khi giả thiết thu thập dữ liệu đầy đủ được bảo đảm từ nguồn, ta khôi phục lại đủ 7 ngày của tuần bằng resample("D"), điền giá trị 0 cho các ngày không có giao dịch, rồi mới tính trung bình:
python
chuoi_ngay_du = df_danh_gia.resample("D").sum().fillna(0)
tb_moi_ngay = chuoi_ngay_du["so_luong"].mean()

print("Số đánh giá trung bình mỗi ngày:", tb_moi_ngay)
# Kết quả: 7 / 7 = 1.0 đánh giá/ngày
Bài tập 3: Nhận diện tháng tăng trưởng đột biến
Cho chuỗi số lượt đánh giá theo từng tháng trong năm 2025:
python
thang_dem = pd.Series(
    [90, 120, 90, 150, 120, 240],
    index=pd.date_range("2025-01-31", periods=6, freq="ME")
)
Hãy viết mã nguồn tìm tất cả các tháng có số đánh giá cao hơn ít nhất 50% so với trung bình của 3 tháng liền trước đó. Lưu ý: Chỉ xét các tháng đã có đủ 3 tháng liền trước để làm mốc đối chiếu.
Lời giải chi tiết
Để so sánh tháng hiện tại với trung bình 3 tháng trước, ta cần:
- Tính trung bình trượt 3 tháng bằng
rolling(3, min_periods=3).mean(). - Dịch chuyển mốc tính toán lùi 1 vị trí bằng
shift(1)để giá trị tại hàng hiện tại là trung bình của 3 tháng trước đó, không bao gồm chính tháng hiện tại. - Lọc các tháng thỏa mãn điều kiện
.
python
tb_3_truoc = thang_dem.rolling(3, min_periods=3).mean().shift(1)
thang_tang_manh = thang_dem[thang_dem >= 1.5 * tb_3_truoc]

print("Các tháng tăng mạnh (>= 50% so với 3 tháng trước):")
for idx, val in thang_tang_manh.items():
    print(f"Tháng {idx.month}: {val} đánh giá (mốc so sánh: {tb_3_truoc.loc[idx]:.1f})")

# Tháng 4: 150 >= 1.5 * (90 + 120 + 90)/3 = 1.5 * 100 = 150 (Đạt)
# Tháng 5: 120 < 1.5 * (120 + 90 + 150)/3 = 1.5 * 120 = 180 (Không đạt)
# Tháng 6: 240 >= 1.5 * (90 + 150 + 120)/3 = 1.5 * 120 = 180 (Đạt)
# Kết quả lọc: Tháng 4 và Tháng 6
Lab 8: Chuỗi thời gian - Quý, cửa sổ trượt và so sánh cùng kỳ
Một tổng số đánh giá theo tháng có thể giảm chỉ vì tháng đó ngắn hơn hoặc chưa được quan sát đủ. Bộ bài này dùng ngày, quý và để kiểm tra phạm vi thời gian trước khi so sánh số liệu.
1. Mục tiêu và bài toán thực tế
Xét bài toán thực tế: Một nhóm nghiên cứu thị trường cần xây dựng báo cáo phân tích chuỗi thời gian về nhu cầu lưu trú du lịch tại vùng đô thị Santiago de Chile. Bản báo cáo cần trả lời các câu hỏi định lượng cốt lõi:
- Tính toán thời lượng lưu trú của khách từ dữ liệu ngày nhận phòng và trả phòng, kiểm soát các trường hợp chuỗi ngày sai cú pháp hoặc không tồn tại trên lịch.
- Xử lý giới hạn mốc chụp dữ liệu (snapshot cutoff), thiết lập thời gian đơn điệu tăng dần để tối ưu hóa các phép cắt lát theo chuỗi năm hoặc tháng.
- Tổng hợp số liệu theo quý, nhận diện các kỳ chưa trọn vẹn (incomplete periods) để tránh rút ra các kết luận sai lệch về xu hướng tăng giảm.
- Triệt tiêu biến động ngày trong tuần bằng kỹ thuật 7 ngày, giải thích độ trễ của đỉnh trung bình trượt so với đỉnh số liệu thực tế.
- Thực hiện phép so sánh cùng kỳ năm trước (Year-over-Year) và so sánh kỳ liền trước (Month-over-Month), đồng thời chuẩn hóa số liệu theo số ngày thực tế của từng tháng có tính đến năm nhuận.
2. Dữ liệu thực hành và chuẩn bị môi trường
Để bảo đảm toàn bộ mã nguồn có thể thực thi độc lập và kiểm chứng ngoại tuyến (offline), bài thực hành sử dụng ba tập dữ liệu mẫu:
- Bảng đặt phòng nhỏ
DAT_DEMO(4 dòng) với định dạng ngàyDD/MM/YYYY, chứa cả ngày hợp lệ, ngày không tồn tại trên lịch và ô khuyết. - Bộ dữ liệu đánh giá giả lập
DEMO_REVIEWS(11.425 dòng, giai đoạn 2019-01-01 đến 2026-07-01) được sinh theo quy luật chu kỳ tuần, mùa hè Nam bán cầu, giai đoạn giãn cách năm 2020 và ngày sự kiện kỷ lục. - Bảng phòng mẫu
LISTINGS_DEMO(5 dòng) phục vụ tính toán khoảng cách từ lần đánh giá cuối cùng đến mốc chụp dữ liệu.
python
import numpy as np
import pandas as pd
from IPython.display import display

# Thiết lập hành vi Copy-on-Write an toàn cho pandas
if pd.__version__.startswith("2."):
    pd.set_option("mode.copy_on_write", True)

# Địa chỉ snapshot dữ liệu thực tế tại Santiago de Chile phục vụ đối chiếu
SNAPSHOT_URL = (
    "https://data.insideairbnb.com/chile/rm/santiago/"
    "2026-06-29/visualisations/reviews.csv"
)

# Mốc chụp dữ liệu chuẩn hóa của tập dữ liệu
SNAPSHOT = "2026-06-29"

# 1. Bảng dữ liệu đặt phòng phục vụ kiểm tra cách đọc ngày và tính số đêm
DAT_DEMO = pd.DataFrame(
    {
        "vao": ["28/02/2026", "03/07/2026", "31/06/2026", None],
        "ra": ["03/03/2026", "06/07/2026", "05/07/2026", "12/07/2026"],
    },
    index=["D1", "D2", "D3", "D4"],
)


# 2. Bộ dữ liệu đánh giá giả lập theo quy luật cố định
def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")
_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]
DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})
DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])
DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

# 3. Bảng phòng mẫu phục vụ xác định chỗ ở ngừng hoạt động
LISTINGS_DEMO = pd.DataFrame(
    {
        "id": [101, 102, 103, 104, 105],
        "name": [
            "Căn hộ trung tâm",
            "Phòng riêng Bellas Artes",
            "Loft Providencia",
            "Studio Recoleta",
            "Nhà cổ Brasil",
        ],
        "last_review": ["2026-05-15", "2025-01-10", "2026-07-02", "2024-11-20", None],
    }
)
NOTE
Đối chiếu thực tế: Khi xử lý tệp snapshot đầy đủ của Santiago (690.112 dòng), có đúng 204 dòng đánh giá mang ngày sau mốc chụp 2026-06-29. Toàn bộ các ví dụ và bảng đối chiếu bên dưới được tính toán trực tiếp trên dữ liệu mẫu giả lập nhằm bảo đảm tính tái lập hoàn toàn, tuyệt đối không dùng số liệu giả lập để suy diễn về các sự kiện thực tế của thành phố Santiago.
3. Nội dung chi tiết bộ bài tập thực hành
Bài tập 1: Đọc chuỗi ngày tháng theo định dạng nguồn và tính số đêm lưu trú
Bài tập 1: Tính số đêm lưu trú
Cho một dat chứa thông tin các lượt đặt phòng với hai cột chuỗi vao (ngày nhận phòng) và ra (ngày trả phòng) theo định dạng ngày tháng châu Âu DD/MM/YYYY. Trong dữ liệu có thể xuất hiện ngày không tồn tại trên lịch (chẳng hạn ngày 31 tháng 6) hoặc giá trị khuyết (None).
Hãy viết hàm calculate_stay_nights(dat: pd.DataFrame) -> pd.Series thực hiện các thao tác:
- Chuyển đổi hai cột
vaovàrasang kiểu dữ liệu ngày giờ (datetime64[ns]), áp dụng định dạng%d/%m/%Yvà cơ chế ép kiểu an toànerrors="coerce". - Tính số đêm lưu trú của từng lượt đặt phòng bằng hiệu số giữa ngày trả phòng và ngày nhận phòng, trích xuất số ngày nguyên dưới dạng Series.
- Nếu một trong hai ngày bị khuyết hoặc không thể chuyển đổi, số đêm lưu trú tương ứng phải nhận giá trị thiếu (
NaN). Không làm thay đổidatđầu vào.
Lời giải
Cách 1: Chuyển đổi tuần tự từng cột bằng định dạng chuỗi tường minh
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

DAT_DEMO = pd.DataFrame(
    {
        "vao": ["28/02/2026", "03/07/2026", "31/06/2026", None],
        "ra": ["03/03/2026", "06/07/2026", "05/07/2026", "12/07/2026"],
    },
    index=["D1", "D2", "D3", "D4"],
)

# Bắt đầu lời giải

import pandas as pd


def calculate_stay_nights(dat: pd.DataFrame) -> pd.Series:
    # 1. Chuyển đổi cột ngày vào với định dạng DD/MM/YYYY, ép lỗi thành NaT
    vao_dt = pd.to_datetime(dat["vao"], format="%d/%m/%Y", errors="coerce")

    # 2. Chuyển đổi cột ngày ra với cùng định dạng
    ra_dt = pd.to_datetime(dat["ra"], format="%d/%m/%Y", errors="coerce")

    # 3. Trừ hai Series thời gian để nhận Timedelta rồi lấy số ngày nguyên
    so_dem = (ra_dt - vao_dt).dt.days
    return so_dem


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ket_qua_dem_c1 = calculate_stay_nights(DAT_DEMO)
display(ket_qua_dem_c1)

# Kết thúc lời giải
Giải thích cách 1
to_datetime đọc hai cột theo đúng %d/%m/%Y. errors="coerce" đổi chuỗi sai lịch hoặc ô thiếu thành NaT. Lấy ngày ra trừ ngày vào tạo Timedelta, rồi .dt.days lấy số ngày nguyên. Dòng có một ngày không hợp lệ nhận kết quả thiếu, không được biến thành 0 đêm.
Kết quả cách 1
| Giá trị | |
|---|---|
| D1 | 3 |
| D2 | 3 |
| D3 | NaN |
| D4 | NaN |
Cách 2: Áp dụng cùng một quy tắc đọc cho cả hai cột
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

DAT_DEMO = pd.DataFrame(
    {
        "vao": ["28/02/2026", "03/07/2026", "31/06/2026", None],
        "ra": ["03/03/2026", "06/07/2026", "05/07/2026", "12/07/2026"],
    },
    index=["D1", "D2", "D3", "D4"],
)

# Bắt đầu lời giải

import pandas as pd


def calculate_stay_nights(dat: pd.DataFrame) -> pd.Series:
    # apply mặc định làm việc theo cột, dùng chung format và cách xử lý lỗi
    ngay = dat.loc[:, ["vao", "ra"]].apply(
        pd.to_datetime, format="%d/%m/%Y", errors="coerce"
    )
    so_dem = ngay["ra"].sub(ngay["vao"]).dt.days
    return so_dem


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ket_qua_dem_c2 = calculate_stay_nights(DAT_DEMO)
display(ket_qua_dem_c2)

# Kết thúc lời giải
Giải thích cách 2
DataFrame.apply mặc định chuyển từng cột vào hàm. Hai cột vì thế dùng cùng format và quy tắc lỗi trong một chỗ cấu hình. .sub() là phép trừ hai Series theo , sau đó .dt.days lấy số ngày. Cách này vẫn giữ định dạng bắt buộc, không thay bằng phỏng đoán dayfirst.
Kết quả cách 2
| Giá trị | |
|---|---|
| D1 | 3 |
| D2 | 3 |
| D3 | NaN |
| D4 | NaN |
So sánh cách dùng
Cách 1 mở riêng bước chuyển đổi ngày vào và ngày ra, thuận tiện để quan sát cột nào chứa ngày sai. Cách 2 đặt cùng định dạng và quy tắc lỗi trong một lần cấu hình. Cả hai lời giải đều đang yêu cầu định dạng ngày/tháng/năm của đề.
Bài tập 2: Phân biệt lỗi chuyển đổi ngày không hợp lệ với dữ liệu khuyết từ nguồn
Bài tập 2: Phát hiện lỗi chuyển đổi ngày
Khi sử dụng errors="coerce", cả ngày không tồn tại trên lịch (như ngày 31/06/2026) lẫn các ô vốn dĩ để trống trong nguồn (None hoặc NaN) đều trở thành NaT. Trong kiểm toán chất lượng dữ liệu, ta cần phân biệt hai tình huống này để lập danh sách các bản ghi nhập liệu sai.
Hãy viết hàm detect_invalid_date_errors(dat: pd.DataFrame, vao_dt: pd.Series) -> pd.Series nhận vào gốc dat và Series vao_dt đã chuyển đổi. Hàm trả về một Series boolean đánh dấu True cho đúng các dòng có chuỗi ngày tồn tại trong nguồn nhưng không thể chuyển đổi thành ngày hợp lệ.
Lời giải
Cách 1: Kết hợp điều kiện logic bằng toán tử bitwise
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

DAT_DEMO = pd.DataFrame(
    {
        "vao": ["28/02/2026", "03/07/2026", "31/06/2026", None],
        "ra": ["03/03/2026", "06/07/2026", "05/07/2026", "12/07/2026"],
    },
    index=["D1", "D2", "D3", "D4"],
)

# Bắt đầu lời giải

import pandas as pd


def detect_invalid_date_errors(dat: pd.DataFrame, vao_dt: pd.Series) -> pd.Series:
    # Điều kiện: Cột chuyển đổi bị khuyết (NaT) VÀ Cột gốc có dữ liệu hợp lệ (notna)
    mat_na_loi = vao_dt.isna() & dat["vao"].notna()
    return mat_na_loi


# Gọi thực nghiệm hàm với dữ liệu mẫu:
vao_da_chuyen = pd.to_datetime(DAT_DEMO["vao"], format="%d/%m/%Y", errors="coerce")
ket_qua_loi_c1 = detect_invalid_date_errors(DAT_DEMO, vao_da_chuyen)
display(ket_qua_loi_c1)

# Kết thúc lời giải
Giải thích cách 1
notna() kiểm tra chuỗi ngày có tồn tại trong dữ liệu gốc. isna() kiểm tra kết quả chuyển đổi bị thiếu. Kết hợp hai mặt nạ bằng & chỉ giữ trường hợp có đầu vào nhưng không đọc được ngày. Ô vốn đã thiếu không bị gán thành lỗi nhập ngày.
Kết quả cách 1
| vao | |
|---|---|
| D1 | False |
| D2 | False |
| D3 | True |
| D4 | False |
Cách 2: Sử dụng phép toán logic numpy logical_and tường minh
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

DAT_DEMO = pd.DataFrame(
    {
        "vao": ["28/02/2026", "03/07/2026", "31/06/2026", None],
        "ra": ["03/03/2026", "06/07/2026", "05/07/2026", "12/07/2026"],
    },
    index=["D1", "D2", "D3", "D4"],
)

# Bắt đầu lời giải

import numpy as np
import pandas as pd


def detect_invalid_date_errors(dat: pd.DataFrame, vao_dt: pd.Series) -> pd.Series:
    # Thực hiện phép toán logic AND bằng NumPy logical_and trên hai mảng boolean
    dieu_kien_nat = vao_dt.isna().to_numpy()
    dieu_kien_co_chuoi = dat["vao"].notna().to_numpy()
    ket_qua = np.logical_and(dieu_kien_nat, dieu_kien_co_chuoi)
    return pd.Series(ket_qua, index=dat.index, name=vao_dt.name)


# Gọi thực nghiệm hàm với dữ liệu mẫu:
vao_da_chuyen = pd.to_datetime(DAT_DEMO["vao"], format="%d/%m/%Y", errors="coerce")
ket_qua_loi_c2 = detect_invalid_date_errors(DAT_DEMO, vao_da_chuyen)
display(ket_qua_loi_c2)

# Kết thúc lời giải
Giải thích cách 2
Tách hai điều kiện thành những Series boolean có cùng giúp đọc rõ vai trò của mỗi vế. Phép kết hợp theo nhãn giữ kết quả ứng với đúng dòng ban đầu. Cần nhận Series ngày được tạo từ chính cột đang kiểm, tránh đưa một cột chuyển đổi có chỉ mục khác vào phép so sánh.
Kết quả cách 2
| vao | |
|---|---|
| D1 | False |
| D2 | False |
| D3 | True |
| D4 | False |
So sánh cách dùng
Cú pháp dùng & ở Cách 1 đặt hai điều kiện pandas cạnh nhau và cần ngoặc cho từng phép so sánh. Cách 2 gọi np.logical_and để thể hiện phép kết hợp bằng tên hàm. Hai cách phải giữ cùng và cùng quy tắc xử lý ngày thiếu.
Bài tập 3: Loại bỏ dòng sau mốc chụp dữ liệu và thiết lập chỉ mục thời gian
Bài tập 3: Thiết lập chỉ mục thời gian và loại bỏ mốc tương lai
Trong các tệp dữ liệu nhật ký đánh giá, đôi khi xuất hiện các dòng có ngày ghi nhận sau thời điểm chụp dữ liệu (do lệch của máy chủ hoặc ghi nhận trễ). Các dòng này cần được thống kê và loại bỏ trước khi thực hiện phân tích chuỗi thời gian.
Hãy viết hàm prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict nhận vào rv chứa cột date (kiểu datetime64) và chuỗi mốc chụp snapshot dạng "YYYY-MM-DD". Hàm trả về một từ điển gồm đúng hai khóa:
so_dong_sau_moc: Số nguyên (int) đếm số dòng códate > snapshot.r: chỉ gồm các dòng thỏa mãndate <= snapshot, đưa cộtdatelàm (set_index("date")), sắp xếp chỉ mục tăng dần theo thời gian (sort_index()), giữ nguyên toàn bộ các cột còn lại và cộtdatekhông còn nằm trong danh sách cột dữ liệu. Không làm biến đổi DataFramervban đầu.
Lời giải
Cách 1: Sử dụng mặt nạ boolean và phương thức đặt chỉ mục chuẩn mực
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"

# Bắt đầu lời giải

import pandas as pd


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
display(f"Số dòng sau mốc: {ket_qua_idx_c1['so_dong_sau_moc']}")
display(ket_qua_idx_c1["r"].head(3))

# Kết thúc lời giải
Giải thích cách 1
Đọc và kiểm ngày trước khi so sánh với mốc snapshot. Giữ các hàng không sau mốc, rồi set_index đưa ngày vào và sort_index sắp theo thời gian. Trả cả số dòng bị gắn cờ để người đọc biết phạm vi thay đổi. Việc lọc không chứng minh các dòng sau mốc chắc chắn là dữ liệu giả.
Kết quả cách 1
| date | listing_id |
|---|---|
| 2019-01-01 00:00:00 | 100 |
| 2019-01-01 00:00:00 | 101 |
| 2019-01-01 00:00:00 | 102 |
Cách 2: Sử dụng query với biến cục bộ và method chaining
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"

# Bắt đầu lời giải

import pandas as pd


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # Đếm số lượng dòng vượt mốc chụp dữ liệu
    so_dong_sau = int((rv["date"] > moc_tg).sum())

    # Truy vấn và thiết lập DatetimeIndex bằng chuỗi phương thức
    r = rv.query("date <= @moc_tg").set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ket_qua_idx_c2 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
display(f"Số dòng sau mốc: {ket_qua_idx_c2['so_dong_sau_moc']}")
display(ket_qua_idx_c2["r"].head(3))

# Kết thúc lời giải
Giải thích cách 2
Tách phần chuẩn bị ngày khỏi mặt nạ lọc giúp theo dõi từng bước trong chuỗi phương thức. .loc chọn các dòng thỏa điều kiện, còn .copy() làm rõ rằng bảng kết quả sẽ được xử lý riêng. thời gian đã sắp là tiền đề để các bài sau cắt lát theo năm và tổng hợp theo lịch.
Kết quả cách 2
| date | listing_id |
|---|---|
| 2019-01-01 00:00:00 | 100 |
| 2019-01-01 00:00:00 | 101 |
| 2019-01-01 00:00:00 | 102 |
So sánh cách dùng
Bạn nên chọn Cách 1 khi cần đếm chính xác số dòng bị loại và kiểm soát từng bước gán thời gian. Cách 2 thích hợp khi muốn tổ chức các bước lọc và sắp xếp thành chuỗi phương thức liền mạch, đồng thời tách riêng bản sao mới.
Bài tập 4: Cắt lát chuỗi thời gian bằng nhãn chuỗi và đối chiếu số lượng đánh giá
Bài tập 4: Cắt lát theo nhãn năm
Khi đã có là DatetimeIndex được sắp xếp, pandas hỗ trợ tính năng cắt lát bằng chuỗi thời gian tự nhiên (partial string indexing). Ta có thể truyền trực tiếp chuỗi năm "2019" vào .loc[] để trích xuất toàn bộ dữ liệu của năm đó.
Hãy viết hàm count_year(r: pd.DataFrame, nam: int) -> int nhận vào bảng r có thời gian đã sắp xếp và một số nguyên nam. Hàm thực hiện cắt lát chuỗi r.loc[str(nam)] và trả về tổng số dòng thuộc về năm đó dưới dạng số nguyên (int).
Lời giải
Cách 1: Cắt lát nhãn chuỗi với len trực tiếp
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def count_year(r: pd.DataFrame, nam: int) -> int:
    # Truy xuất toàn bộ các dòng thuộc năm chỉ định bằng nhãn chuỗi
    bang_nam = r.loc[str(nam)]
    return int(len(bang_nam))


# Gọi thực nghiệm hàm với dữ liệu mẫu:
so_rv_2019_c1 = count_year(ket_qua_idx_c1["r"], 2019)
so_rv_2021_c1 = count_year(ket_qua_idx_c1["r"], 2021)
display(f"Năm 2019: {so_rv_2019_c1} dòng, Năm 2021: {so_rv_2021_c1} dòng")

# Kết thúc lời giải
Giải thích cách 1
Với DatetimeIndex, .loc[str(nam)] chọn các nhãn thuộc năm đó, không phải chọn một vị trí dòng. len đếm số đánh giá trong . Cần xử lý năm không có trong dữ liệu theo đúng đầu ra của đề, thay vì giả định năm nào cũng xuất hiện.
Kết quả cách 1
| Kết quả |
|---|
| Năm 2019: 1317 dòng, Năm 2021: 952 dòng |
Cách 2: Trích xuất kích thước qua shape và kiểm chứng dải ngày
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def count_year(r: pd.DataFrame, nam: int) -> int:
    # Cắt lát tường minh theo nhãn chuỗi và lấy số dòng qua thuộc tính shape
    so_luong = r.loc[str(nam)].shape[0]
    return int(so_luong)


# Gọi thực nghiệm hàm với dữ liệu mẫu:
so_rv_2019_c2 = count_year(ket_qua_idx_c2["r"], 2019)
so_rv_2021_c2 = count_year(ket_qua_idx_c2["r"], 2021)
display(f"Năm 2019: {so_rv_2019_c2} dòng, Năm 2021: {so_rv_2021_c2} dòng")

# Kết thúc lời giải
Giải thích cách 2
So sánh thuộc tính .index.year với năm cần tìm tạo mặt nạ cùng độ dài bảng. Tổng các giá trị True hoặc số dòng sau lọc cho cùng số đánh giá. Cách viết này thể hiện trực tiếp điều kiện năm và thuận tiện khi muốn kết hợp thêm điều kiện theo tháng hoặc loại chỗ ở.
Kết quả cách 2
| Kết quả |
|---|
| Năm 2019: 1317 dòng, Năm 2021: 952 dòng |
So sánh cách dùng
Hãy chọn Cách 1 khi đã là dạng thời gian và bạn chỉ cần cắt nhanh các bản ghi của một năm bằng nhãn chuỗi. Cách 2 thuận tiện hơn khi muốn kết hợp điều kiện năm với nhiều tiêu chí lọc khác trên cùng mặt nạ boolean.
Bài tập 5: Tổng hợp dữ liệu theo quý và nhận diện kỳ chưa trọn
Bài tập 5: Tổng hợp theo quý và loại bỏ kỳ chưa trọn
Trong pandas 3, bí danh resample("QE") (Quarter End) được sử dụng để tổng hợp dữ liệu theo quý và gán nhãn bằng ngày cuối cùng của quý (ngày 31/03, 30/06, 30/09, 31/12). Nếu thời điểm thu thập dữ liệu đứng trước ngày kết thúc quý, số lượng của quý đó sẽ bị thiếu hụt so với thực tế và được gọi là kỳ chưa trọn (incomplete period).
Hãy viết hàm quarterly(r: pd.DataFrame, snapshot: str) -> dict nhận vào bảng r và mốc chụp snapshot. Hàm trả về một từ điển gồm:
quy: Series kết quả củar.resample("QE").size(), chứa số lượng bản ghi của từng quý.quy_day_du: Series trích xuất từquychỉ giữ lại các quý có nhãn ngày cuối quý nhỏ hơn hoặc bằngsnapshot, tức loại bỏ quý chưa trọn cuối cùng nếu mốc chụp chưa chạm đến ngày cuối quý.
Lời giải
Cách 1: Sử dụng resample QE và lọc theo chỉ mục thời gian
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def quarterly(r: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tổng hợp số lượng đánh giá theo từng quý kết thúc bằng QE
    quy = r.resample("QE").size()

    # 2. Lọc bỏ quý chưa kết thúc bằng cách so sánh nhãn chỉ mục với mốc chụp
    quy_day_du = quy[quy.index <= moc_tg]

    return {
        "quy": quy,
        "quy_day_du": quy_day_du,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ket_qua_quy_c1 = quarterly(ket_qua_idx_c1["r"], SNAPSHOT)
display(ket_qua_quy_c1["quy"].tail(4))
display(f"Số quý đầy đủ: {len(ket_qua_quy_c1['quy_day_du'])}")

# Kết thúc lời giải
Giải thích cách 1
resample chia ngày thành các quý dương lịch, .size() đếm dòng trong từng quý. Quý chưa kết thúc tại mốc quan sát phải được nhận diện bằng ngày cuối kỳ. Đề có bước bỏ kỳ cuối trong dữ liệu đã cho, nhưng không được suy ra rằng kỳ cuối của mọi tập dữ liệu đều thiếu.
Kết quả cách 1
| date | Giá trị |
|---|---|
| 2025-09-30 00:00:00 | 486 |
| 2025-12-31 00:00:00 | 528 |
| 2026-03-31 00:00:00 | 904 |
| 2026-06-30 00:00:00 | 746 |
Cách 2: Sử dụng truncate để cắt lát chuỗi thời gian tường minh
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def quarterly(r: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    quy = r.resample("QE").size()
    # truncate cho phép cắt lát chuỗi thời gian có chỉ mục sắp xếp một cách an toàn
    quy_day_du = quy.truncate(after=moc_tg)

    return {
        "quy": quy,
        "quy_day_du": quy_day_du,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ket_qua_quy_c2 = quarterly(ket_qua_idx_c2["r"], SNAPSHOT)
display(ket_qua_quy_c2["quy"].tail(4))
display(f"Số quý đầy đủ: {len(ket_qua_quy_c2['quy_day_du'])}")

# Kết thúc lời giải
Giải thích cách 2
Chuẩn hóa nhãn kỳ giúp so sánh mốc kết thúc quý với snapshot một cách tường minh. Sau khi tổng hợp, chỉ chọn những kỳ đáp ứng điều kiện đầy đủ. Cần giữ phân biệt giữa nhãn ngày cuối quý và ngày đánh giá cuối cùng xuất hiện trong quý, vì ngày cuối có sự kiện không xác định độ phủ dữ liệu.
Kết quả cách 2
| date | Giá trị |
|---|---|
| 2025-09-30 00:00:00 | 486 |
| 2025-12-31 00:00:00 | 528 |
| 2026-03-31 00:00:00 | 904 |
| 2026-06-30 00:00:00 | 746 |
So sánh cách dùng
Cách 1 giúp quan sát nhãn cuối quý và bước bỏ kỳ cuối trong bộ dữ liệu đã cho. Cách 2 đối chiếu kết thúc kỳ với snapshot để chọn các quý đã trọn vẹn. Khi thay dữ liệu, hãy kiểm độ phủ thời gian trước khi quyết định bỏ một quý.
Bài tập 6: Kiểm tra quy tắc lọc kỳ chưa trọn tại các mốc thời gian biên
Bài tập 6: Kiểm định mốc thời gian biên của kỳ
Việc loại bỏ quý cuối cùng là do quý đó chưa trọn vẹn, không phải một quy tắc cứng nhắc bắt buộc phải bỏ quý cuối cùng trong mọi tập dữ liệu. Nếu mốc thu thập dữ liệu rơi đúng vào ngày kết thúc quý, quý đó hoàn toàn trọn vẹn và phải được giữ lại.
Cho một Series dem_quy gồm hai quý:
python
dem_quy = pd.Series([100, 120], index=pd.to_datetime(["2026-03-31", "2026-06-30"]))Hãy viết hàm filter_complete_quarters(dem_quy: pd.Series, moc: str) -> pd.Series nhận vào Series và chuỗi ngày moc. Hàm trả về Series chỉ giữ các quý đã kết thúc tại hoặc trước moc.
- Khi
moc = "2026-06-29": Trả về Series có đúng 1 quý (chỉ giữ Q1/2026). - Khi
moc = "2026-06-30": Trả về Series có đủ 2 quý (giữ cả Q1/2026 và Q2/2026).
Lời giải
Cách 1: Sử dụng phép so sánh boolean trực tiếp với Timestamp
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

# Bắt đầu lời giải

import pandas as pd


def filter_complete_quarters(dem_quy: pd.Series, moc: str) -> pd.Series:
    moc_tg = pd.Timestamp(moc)
    # Lọc các quý có ngày kết thúc nhỏ hơn hoặc bằng mốc chụp
    quy_hop_le = dem_quy[dem_quy.index <= moc_tg]
    return quy_hop_le


# Gọi thực nghiệm hàm với dữ liệu mẫu:
dem_quy_mau = pd.Series([100, 120], index=pd.to_datetime(["2026-03-31", "2026-06-30"]))
kq_bien_29_c1 = filter_complete_quarters(dem_quy_mau, "2026-06-29")
kq_bien_30_c1 = filter_complete_quarters(dem_quy_mau, "2026-06-30")
display(
    f"Mốc 29/06: Còn {len(kq_bien_29_c1)} quý, Mốc 30/06: Còn {len(kq_bien_30_c1)} quý"
)

# Kết thúc lời giải
Giải thích cách 1
So sánh nhãn ngày kết thúc quý với mốc được phép báo cáo. Mặt nạ lọc trả lại đúng các quý đã kết thúc, giữ nhãn và số đếm. Khi mốc nằm đúng ngày cuối quý, phải đọc rõ quy ước về hết ngày đó, không tự loại thêm một quý.
Kết quả cách 1
| Kết quả |
|---|
| Mốc 29/06: Còn 1 quý, Mốc 30/06: Còn 2 quý |
Cách 2: Sử dụng phương thức cắt lát nhãn với slice thời gian
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

# Bắt đầu lời giải

import pandas as pd


def filter_complete_quarters(dem_quy: pd.Series, moc: str) -> pd.Series:
    # Lấy toàn bộ các phần tử từ đầu đến mốc thời gian bằng cú pháp cắt lát
    quy_hop_le = dem_quy.loc[: pd.Timestamp(moc)]
    return quy_hop_le


# Gọi thực nghiệm hàm với dữ liệu mẫu:
dem_quy_mau = pd.Series([100, 120], index=pd.to_datetime(["2026-03-31", "2026-06-30"]))
kq_bien_29_c2 = filter_complete_quarters(dem_quy_mau, "2026-06-29")
kq_bien_30_c2 = filter_complete_quarters(dem_quy_mau, "2026-06-30")
display(
    f"Mốc 29/06: Còn {len(kq_bien_29_c2)} quý, Mốc 30/06: Còn {len(kq_bien_30_c2)} quý"
)

# Kết thúc lời giải
Giải thích cách 2
Đưa mốc về Timestamp rồi dùng phép chọn theo giúp điều kiện thời gian không phụ thuộc vị trí cuối của Series. Cách này vẫn đúng khi dữ liệu có nhiều kỳ sau mốc. Hai cách đều cần cùng quy ước gồm hay không gồm ngày biên để kết quả đối chiếu có ý nghĩa.
Kết quả cách 2
| Kết quả |
|---|
| Mốc 29/06: Còn 1 quý, Mốc 30/06: Còn 2 quý |
So sánh cách dùng
Hãy chọn Cách 1 khi dữ liệu chưa chắc chắn được sắp xếp tuần tự hoặc cần kết hợp thêm điều kiện lọc phụ. Cách 2 là lựa chọn trực diện khi ngày đã sắp thứ tự và bạn muốn lấy ngay đoạn lịch sử hợp lệ bằng phép cắt lát.
Bài tập 7: Xác định quý cao nhất toàn chuỗi và quý thấp nhất trong một giai đoạn
Bài tập 7: Tìm kiếm cực trị theo quý
Trong phân tích xu hướng kinh doanh, chuyên viên dữ liệu cần xác định thời điểm thị trường đạt đỉnh cao nhất trong lịch sử và thời điểm chạm đáy trong giai đoạn khủng hoảng.
Hãy viết hàm quarter_extremes(quy: pd.Series, bat_dau: str, ket_thuc: str) -> dict nhận vào Series các quý trọn vẹn quy và hai chuỗi mốc năm bat_dau, ket_thuc. Hàm trả về một từ điển gồm đúng ba khóa:
quy_dinh: Đối tượngpd.Timestamplà nhãn của quý có số lượng đánh giá cao nhất trên toàn bộ chuỗi (idxmax()).quy_day: Đối tượngpd.Timestamplà nhãn của quý có số lượng đánh giá thấp nhất trong giai đoạn cắt lát từbat_dauđếnket_thuc(idxmin()).gia_tri_day: Số nguyên (int) là số lượng đánh giá của quý chạm đáy đó.
Lời giải
Cách 1: Sử dụng idxmax toàn chuỗi và cắt lát tìm idxmin giai đoạn
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1


def quarterly(r: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tổng hợp số lượng đánh giá theo từng quý kết thúc bằng QE
    quy = r.resample("QE").size()

    # 2. Lọc bỏ quý chưa kết thúc bằng cách so sánh nhãn chỉ mục với mốc chụp
    quy_day_du = quy[quy.index <= moc_tg]

    return {
        "quy": quy,
        "quy_day_du": quy_day_du,
    }


ket_qua_quy_c1 = quarterly(ket_qua_idx_c1["r"], SNAPSHOT)
ket_qua_quy_c2 = ket_qua_quy_c1
quy_day_du_demo = ket_qua_quy_c1["quy_day_du"]

# Bắt đầu lời giải

import pandas as pd


def quarter_extremes(quy: pd.Series, bat_dau: str, ket_thuc: str) -> dict:
    # 1. Tìm nhãn thời gian của quý cao nhất toàn bộ chuỗi dữ liệu
    quy_dinh = quy.idxmax()

    # 2. Cắt lát chuỗi dữ liệu trong giai đoạn khảo sát chỉ định
    giai_doan = quy.loc[bat_dau:ket_thuc]

    # 3. Tìm nhãn và giá trị của quý chạm đáy trong giai đoạn đó
    quy_day = giai_doan.idxmin()
    gia_tri_day = int(giai_doan.loc[quy_day])

    return {
        "quy_dinh": quy_dinh,
        "quy_day": quy_day,
        "gia_tri_day": gia_tri_day,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
quy_day_du_demo = ket_qua_quy_c1["quy_day_du"]
cuc_tri_c1 = quarter_extremes(quy_day_du_demo, "2019", "2021")
display(cuc_tri_c1)

# Kết thúc lời giải
Giải thích cách 1
Cắt giai đoạn cần so sánh trước khi tìm cực trị. idxmax và idxmin trả nhãn quý, còn max và min trả số đếm. Khi có nhiều quý cùng giá trị, các hàm tìm nhãn trả lần xuất hiện đầu, nên cần nêu quy tắc này trong báo cáo.
Kết quả cách 1
| Trường | Kết quả |
|---|---|
| quy_dinh | 2026-03-31 00:00:00 |
| quy_day | 2020-06-30 00:00:00 |
| gia_tri_day | 26 |
Cách 2: Sử dụng tổng hợp agg và tối ưu hóa truy xuất
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1


def quarterly(r: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tổng hợp số lượng đánh giá theo từng quý kết thúc bằng QE
    quy = r.resample("QE").size()

    # 2. Lọc bỏ quý chưa kết thúc bằng cách so sánh nhãn chỉ mục với mốc chụp
    quy_day_du = quy[quy.index <= moc_tg]

    return {
        "quy": quy,
        "quy_day_du": quy_day_du,
    }


ket_qua_quy_c1 = quarterly(ket_qua_idx_c1["r"], SNAPSHOT)
ket_qua_quy_c2 = ket_qua_quy_c1
quy_day_du_demo = ket_qua_quy_c1["quy_day_du"]

# Bắt đầu lời giải

import pandas as pd


def quarter_extremes(quy: pd.Series, bat_dau: str, ket_thuc: str) -> dict:
    quy_dinh = quy.idxmax()

    # Lấy phân đoạn cần khảo sát bằng lát cắt chuỗi
    phan_doan = quy.loc[bat_dau:ket_thuc]
    quy_day = phan_doan.idxmin()
    gia_tri_day = int(phan_doan.min())

    return {
        "quy_dinh": quy_dinh,
        "quy_day": quy_day,
        "gia_tri_day": gia_tri_day,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
cuc_tri_c2 = quarter_extremes(quy_day_du_demo, "2019", "2021")
display(cuc_tri_c2)

# Kết thúc lời giải
Giải thích cách 2
Việc gom nhãn và giá trị vào một dict giữ kết quả có tên trường rõ ràng. Đừng tìm cực trị trên toàn lịch sử rồi mới kiểm xem nhãn có thuộc giai đoạn được hỏi hay không. Dữ liệu rỗng sau khi giới hạn kỳ cần được nhận diện trước khi gọi hàm tìm cực trị.
Kết quả cách 2
| Trường | Kết quả |
|---|---|
| quy_dinh | 2026-03-31 00:00:00 |
| quy_day | 2020-06-30 00:00:00 |
| gia_tri_day | 26 |
So sánh cách dùng
Bạn nên chọn Cách 1 khi cần tra cứu nhanh nhãn thời gian và giá trị cực trị qua từng lệnh đơn lẻ lúc khám phá. Cách 2 phù hợp hơn khi bạn muốn gom toàn bộ chỉ số vào một từ điển có cấu trúc rõ ràng để tiện xuất báo cáo.
Bài tập 8: Tổng hợp dữ liệu theo ngày và điền đầy đủ các ngày không có lượt đánh giá
Bài tập 8: Tổng hợp theo lịch ngày liên tục
Khác với phương thức groupby thông thường (chỉ giữ lại các ngày thực sự xuất hiện bản ghi dữ liệu), phương thức resample("D").size() tạo ra một lưới ngày lịch liên tục từ ngày đầu tiên đến ngày cuối cùng và tự động gán giá trị 0 cho những ngày không có lượt đánh giá nào.
Hãy viết hàm daily_counts(r: pd.DataFrame, nam: int) -> pd.Series nhận vào bảng r và một năm nam. Hàm thực hiện cắt lát năm trước rồi mới tổng hợp bằng resample("D").size() để tránh lãng phí bộ nhớ khi tạo các ngày ngoài phạm vi quan tâm. Kết quả trả về là Series số lượt đánh giá mỗi ngày trong năm đó.
Lời giải
Cách 1: Cắt lát năm trước rồi tổng hợp bằng resample ngày
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def daily_counts(r: pd.DataFrame, nam: int) -> pd.Series:
    # 1. Cắt lát năm trước để giới hạn phạm vi tính toán
    r_nam = r.loc[str(nam)]

    # 2. Tổng hợp theo ngày và tự động điền 0 cho ngày trống
    ngay_series = r_nam.resample("D").size()
    return ngay_series


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ngay_2025_c1 = daily_counts(ket_qua_idx_c1["r"], 2025)
display(
    f"Năm 2025 có {len(ngay_2025_c1)} ngày, cao nhất: {ngay_2025_c1.max()} đánh giá/ngày"
)
display(ngay_2025_c1.tail(3))

# Kết thúc lời giải
Giải thích cách 1
Tạo lịch ngày đầy đủ bằng date_range, đếm số đánh giá rồi reindex về lịch đó. fill_value=0 ở đây có nghĩa là không có sự kiện trong log đã được quan sát, không phải cách điền tùy ý cho một phép đo bị thiếu. Ngày nhuận được lịch của pandas tính theo năm được chọn.
Kết quả cách 1
| date | Giá trị |
|---|---|
| 2025-12-29 00:00:00 | 7 |
| 2025-12-30 00:00:00 | 5 |
| 2025-12-31 00:00:00 | 5 |
Cách 2: Kết hợp resample tường minh và chuẩn hóa tần suất chỉ mục
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def daily_counts(r: pd.DataFrame, nam: int) -> pd.Series:
    # Cắt lát dải ngày trọn vẹn của năm rồi áp dụng resample
    ngay_dau = f"{nam}-01-01"
    ngay_cuoi = f"{nam}-12-31"
    r_nam = r.loc[ngay_dau:ngay_cuoi]

    chuoi_ngay = r_nam.resample("1D").size()
    return chuoi_ngay


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ngay_2025_c2 = daily_counts(ket_qua_idx_c2["r"], 2025)
display(
    f"Năm 2025 có {len(ngay_2025_c2)} ngày, cao nhất: {ngay_2025_c2.max()} đánh giá/ngày"
)
display(ngay_2025_c2.tail(3))

# Kết thúc lời giải
Giải thích cách 2
Tổng hợp theo ngày rồi căn về cùng lịch cho phép so sánh các năm theo cùng định nghĩa. Giữ ngày liên tục là điều kiện để cửa sổ bảy dòng ở bài sau tương ứng với bảy ngày. Không dùng số ngày có sự kiện làm mẫu số khi câu hỏi hỏi trung bình trên mọi ngày trong năm.
Kết quả cách 2
| date | Giá trị |
|---|---|
| 2025-12-29 00:00:00 | 7 |
| 2025-12-30 00:00:00 | 5 |
| 2025-12-31 00:00:00 | 5 |
So sánh cách dùng
Hãy chọn Cách 1 khi bạn muốn tạo sẵn khung lịch dương đầy đủ để kiểm soát việc điền số 0 cho những ngày không có sự kiện. Cách 2 thuận tiện khi chuỗi thời gian cần được chuẩn hóa tần suất trực tiếp trong bước tổng hợp mà không cần tạo lịch rời.
Bài tập 9: Làm mượt chuỗi thời gian bằng cửa sổ trượt 7 ngày và nhận diện đỉnh điểm
Bài tập 9: Làm mượt bằng cửa sổ trượt
Số đánh giá theo ngày có thể dao động. giúp nhìn mức trung bình trong một khoảng, nhưng không thay thế chuỗi đếm gốc khi cần tìm một ngày cụ thể.
Hãy viết hàm rolling_peak(ngay: pd.Series, cua_so: int = 7) -> dict nhận vào Series số đếm theo ngày liên tục và độ rộng cửa sổ. Hàm trả về từ điển gồm:
tb: Series trung bình trượt đối xứng tính bằngngay.rolling(cua_so, center=True).mean().ngay_dinh: Đối tượngpd.Timestamplà ngày có giá trị trung bình trượt lớn nhất (idxmax()).gia_tri_dinh: Giá trị số thực (float) của trung bình trượt tại ngày đỉnh đó.
Yêu cầu phân tích và trực quan hóa:
- Phân biệt rõ sự khác nhau giữa cửa sổ 7 hàng (
7 rows) và cửa sổ 7 ngày (7 days). - Giải thích tham số
min_periodsvà nguyên nhân vì sao các giá trị ở đầu chuỗi nhận giá trịNaN. - Giải thích hiện tượng đỉnh của đường trung bình trượt quá khứ (
center=False) nằm lệch về phía sau đỉnh thực tế của từng ngày. - Xuất biểu đồ trực quan hóa chuỗi thời gian lưu trữ tại
img/labs/lab-08/rolling-7d-2025.svg.
Lời giải
Cách 1: Sử dụng cửa sổ trượt căn giữa đối xứng
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1


def daily_counts(r: pd.DataFrame, nam: int) -> pd.Series:
    # 1. Cắt lát năm trước để giới hạn phạm vi tính toán
    r_nam = r.loc[str(nam)]

    # 2. Tổng hợp theo ngày và tự động điền 0 cho ngày trống
    ngay_series = r_nam.resample("D").size()
    return ngay_series


ngay_2025_c1 = daily_counts(ket_qua_idx_c1["r"], 2025)

# Bắt đầu lời giải

import pandas as pd


def rolling_peak(ngay: pd.Series, cua_so: int = 7) -> dict:
    # 1. Tính trung bình trượt căn giữa để làm mượt biến động
    tb = ngay.rolling(cua_so, center=True).mean()

    # 2. Tìm ngày đạt giá trị trung bình trượt cao nhất và giá trị tương ứng
    ngay_dinh = tb.idxmax()
    gia_tri_dinh = float(tb.loc[ngay_dinh])

    return {
        "tb": tb,
        "ngay_dinh": ngay_dinh,
        "gia_tri_dinh": gia_tri_dinh,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_rolling_c1 = rolling_peak(ngay_2025_c1, cua_so=7)
display(
    f"Đỉnh căn giữa: {kq_rolling_c1['ngay_dinh']:%Y-%m-%d} với giá trị {kq_rolling_c1['gia_tri_dinh']:.2f}"
)

# Kết thúc lời giải
Giải thích cách 1
rolling(cua_so) dùng số dòng, còn mean() tính trung bình trong mỗi cửa sổ. Trên lịch ngày liên tục ở bài trước, bảy dòng tương ứng bảy ngày. min_periods quy định số quan sát tối thiểu. Với center=True, nhãn được đặt giữa cửa sổ, nên phép tính có dùng những ngày phía sau nhãn và có thể thiếu ở cả hai đầu. Cách làm mượt này phù hợp mô tả lịch sử, không dùng như một dự báo chỉ biết quá khứ.
Kết quả cách 1
| Kết quả |
|---|
| Đỉnh căn giữa: 2025-11-23 với giá trị 11.29 |
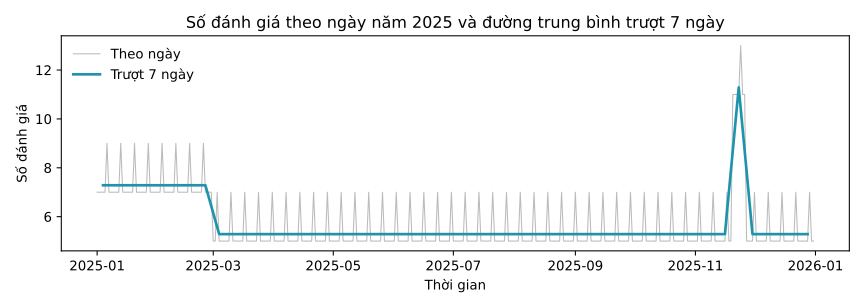
Cách 2: Sử dụng cửa sổ trượt quá khứ với tham số min_periods tường minh
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1


def daily_counts(r: pd.DataFrame, nam: int) -> pd.Series:
    # 1. Cắt lát năm trước để giới hạn phạm vi tính toán
    r_nam = r.loc[str(nam)]

    # 2. Tổng hợp theo ngày và tự động điền 0 cho ngày trống
    ngay_series = r_nam.resample("D").size()
    return ngay_series


ngay_2025_c1 = daily_counts(ket_qua_idx_c1["r"], 2025)

# Bắt đầu lời giải

import pandas as pd


def rolling_peak(ngay: pd.Series, cua_so: int = 7) -> dict:
    # Cửa sổ quá khứ yêu cầu đủ đúng cua_so ngày quan sát để tính toán
    tb = ngay.rolling(window=cua_so, min_periods=cua_so, center=False).mean()

    ngay_dinh = tb.idxmax()
    gia_tri_dinh = float(tb.loc[ngay_dinh])

    return {
        "tb": tb,
        "ngay_dinh": ngay_dinh,
        "gia_tri_dinh": gia_tri_dinh,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_rolling_c2 = rolling_peak(ngay_2025_c1, cua_so=7)
display(
    f"Đỉnh quá khứ: {kq_rolling_c2['ngay_dinh']:%Y-%m-%d} với giá trị {kq_rolling_c2['gia_tri_dinh']:.2f}"
)

# Kết thúc lời giải
Giải thích cách 2
Tách chuỗi làm mượt và thao tác tìm đỉnh giúp đối chiếu cả nhãn ngày lẫn giá trị. Nếu có khoảng trống, cần lập lại lịch hoặc cân nhắc cửa sổ thời gian như "7D" với quy tắc biên rõ ràng. Đừng thay một cửa sổ bảy dòng bằng bảy ngày mà không kiểm cấu trúc chỉ mục.
Kết quả cách 2
| Kết quả |
|---|
| Đỉnh quá khứ: 2025-11-26 với giá trị 11.29 |
So sánh cách dùng
Cửa sổ đặt ở giữa trong Cách 1 thích hợp để mô tả lại lịch sử, vì mỗi điểm dùng cả những ngày phía sau. Chọn cửa sổ kết thúc tại ngày đang xét của Cách 2 khi chỉ được dùng dữ liệu đã có tại thời điểm tính.
Bài tập 10: So sánh cùng kỳ theo quý và khắc phục lỗi lệch chu kỳ
Bài tập 10: So sánh cùng kỳ theo quý
Trong chuỗi quý liên tục, cùng kỳ năm trước nằm cách bốn quý. Vì vậy, cần dịch bốn kỳ bằng shift(4), còn shift(12) sẽ lùi ba năm.
Hãy viết hàm quarterly_yoy(quy_day_du: pd.Series) -> pd.Series nhận vào Series các quý đầy đủ và tính tỷ lệ thay đổi cùng kỳ năm trước theo công thức:
Ở đây, rv từ 2025-01-01 đến trước 2025-04-01.
Lời giải
Cách 1: Sử dụng shift với bước nhảy 4 quý
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1


def quarterly(r: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tổng hợp số lượng đánh giá theo từng quý kết thúc bằng QE
    quy = r.resample("QE").size()

    # 2. Lọc bỏ quý chưa kết thúc bằng cách so sánh nhãn chỉ mục với mốc chụp
    quy_day_du = quy[quy.index <= moc_tg]

    return {
        "quy": quy,
        "quy_day_du": quy_day_du,
    }


ket_qua_quy_c1 = quarterly(ket_qua_idx_c1["r"], SNAPSHOT)
ket_qua_quy_c2 = ket_qua_quy_c1
quy_day_du_demo = ket_qua_quy_c1["quy_day_du"]

# Bắt đầu lời giải

import pandas as pd


def quarterly_yoy(quy_day_du: pd.Series) -> pd.Series:
    # Với dữ liệu theo quý, dịch chuyển 4 hàng tương ứng với đúng 1 năm trước
    cung_ky = quy_day_du / quy_day_du.shift(4) - 1.0
    return cung_ky


# Gọi thực nghiệm hàm với dữ liệu mẫu:
yoy_quy_c1 = quarterly_yoy(ket_qua_quy_c1["quy_day_du"])
display(yoy_quy_c1.tail(4))

# Đối chiếu độc lập với số liệu lọc trực tiếp trong bảng rv:
mask_q1_2025 = (DEMO_REVIEWS["date"] >= "2025-01-01") & (
    DEMO_REVIEWS["date"] < "2025-04-01"
)
so_dem_truc_tiep = int(mask_q1_2025.sum())
display(
    f"Đếm trực tiếp Q1/2025: {so_dem_truc_tiep}, Series quý: {ket_qua_quy_c1['quy_day_du'].loc['2025-03-31']}"
)

# Kết thúc lời giải
Giải thích cách 1
Cùng kỳ theo quý nghĩa là so với quý cách bốn kỳ, không phải quý ngay trước. pct_change(4) trả mức thay đổi trên thang 0–1, cần nhân 100 khi trình bày phần trăm. Bốn kỳ đầu chưa có kỳ đối chiếu, nên kết quả thiếu là hợp lý.
Kết quả cách 1
| date | Giá trị |
|---|---|
| 2025-06-30 00:00:00 | 0.233333 |
| 2025-09-30 00:00:00 | 0.227273 |
| 2025-12-31 00:00:00 | 0.340102 |
| 2026-03-31 00:00:00 | 0.521886 |
Cách 2: Sử dụng phương thức pct_change chuyên dụng
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1


def quarterly(r: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tổng hợp số lượng đánh giá theo từng quý kết thúc bằng QE
    quy = r.resample("QE").size()

    # 2. Lọc bỏ quý chưa kết thúc bằng cách so sánh nhãn chỉ mục với mốc chụp
    quy_day_du = quy[quy.index <= moc_tg]

    return {
        "quy": quy,
        "quy_day_du": quy_day_du,
    }


ket_qua_quy_c1 = quarterly(ket_qua_idx_c1["r"], SNAPSHOT)
ket_qua_quy_c2 = ket_qua_quy_c1
quy_day_du_demo = ket_qua_quy_c1["quy_day_du"]

# Bắt đầu lời giải

import pandas as pd


def quarterly_yoy(quy_day_du: pd.Series) -> pd.Series:
    # pct_change với periods=4 tính toán trực tiếp tỷ lệ thay đổi sau 4 kỳ
    cung_ky = quy_day_du.pct_change(periods=4)
    return cung_ky


# Gọi thực nghiệm hàm với dữ liệu mẫu:
yoy_quy_c2 = quarterly_yoy(ket_qua_quy_c2["quy_day_du"])
display(yoy_quy_c2.tail(4))

# Kết thúc lời giải
Giải thích cách 2
Tách giá trị hiện tại và giá trị dịch bốn kỳ bằng shift(4) làm rõ tử số và mẫu số. Phải dùng cùng lịch quý đầy đủ để bốn vị trí thực sự là một năm. Mẫu số bằng 0 không cho một tỷ lệ hữu hạn và cần được báo riêng thay vì diễn giải như tăng trưởng bình thường.
Kết quả cách 2
| date | Giá trị |
|---|---|
| 2025-06-30 00:00:00 | 0.233333 |
| 2025-09-30 00:00:00 | 0.227273 |
| 2025-12-31 00:00:00 | 0.340102 |
| 2026-03-31 00:00:00 | 0.521886 |
So sánh cách dùng
Bạn nên chọn Cách 1 khi muốn tính nhanh tỷ lệ thay đổi trên chuỗi quý liên tục bằng phương thức có sẵn của pandas. Cách 2 thích hợp khi cần kiểm tra chặt chẽ mẫu số bằng 0 hoặc muốn giữ riêng mức chênh lệch tuyệt đối trước khi chia.
Bài tập 11: So sánh theo tháng: So với kỳ liền trước và so với cùng kỳ năm trước
Bài tập 11: Tính toán hai hệ quy chiếu so sánh
So tháng này với tháng trước và so cùng tháng năm trước dùng hai kỳ gốc khác nhau. Cần xác định câu hỏi trước khi chọn phép dịch kỳ và mẫu số.
Hãy viết hàm period_changes(thang: pd.Series, moc: str) -> dict nhận vào Series số đếm theo tháng ( là ngày cuối tháng pd.offsets.MonthEnd) và nhãn tháng cần báo cáo moc (ví dụ: "2026-05-31"). Hàm trả về từ điển gồm:
so_ky_truoc: Tỷ lệ phần trăm thay đổi so với tháng liền trước (nhãn lùi 1 tháng).so_cung_ky: Tỷ lệ phần trăm thay đổi so với cùng tháng năm trước (nhãn lùi 12 tháng).
Công thức tính phần trăm thay đổi:
Trong công thức,
Lời giải
Cách 1: Sử dụng MonthEnd offset để định vị nhãn kỳ gốc chính xác
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def period_changes(thang: pd.Series, moc: str) -> dict:
    moc_tg = pd.Timestamp(moc)

    # 1. Xác định nhãn ngày cuối tháng của kỳ liền trước và cùng kỳ năm trước
    nhan_ky_truoc = moc_tg - pd.offsets.MonthEnd(1)
    nhan_cung_ky = moc_tg - pd.offsets.MonthEnd(12)

    # 2. Lấy giá trị tương ứng từ Series tháng
    val_hien_tai = thang.loc[moc_tg]
    val_ky_truoc = thang.loc[nhan_ky_truoc]
    val_cung_ky = thang.loc[nhan_cung_ky]

    # 3. Tính phần trăm thay đổi không làm tròn
    so_ky_truoc = (val_hien_tai / val_ky_truoc - 1.0) * 100.0
    so_cung_ky = (val_hien_tai / val_cung_ky - 1.0) * 100.0

    return {
        "so_ky_truoc": float(so_ky_truoc),
        "so_cung_ky": float(so_cung_ky),
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
thang_series = ket_qua_idx_c1["r"].resample("ME").size()
kq_so_sanh_c1 = period_changes(thang_series, "2026-05-31")
display(f"Tháng 5/2026 so tháng trước: {kq_so_sanh_c1['so_ky_truoc']:+.1f}%")
display(f"Tháng 5/2026 so cùng kỳ: {kq_so_sanh_c1['so_cung_ky']:+.1f}%")

# Kết thúc lời giải
Giải thích cách 1
So sánh với kỳ trước và cùng kỳ là hai câu hỏi khác nhau. shift(1) lấy kỳ liền trước, còn dịch 12 tháng lấy cùng tháng năm trước nếu Series có lịch tháng liên tục. Giữ rõ mốc cần đọc trong kết quả, không lấy phần tử cuối theo vị trí nếu đề chỉ định một tháng cụ thể.
Kết quả cách 1
| Kết quả |
|---|
| Tháng 5/2026 so cùng kỳ: +57.1% |
Cách 2: Sử dụng phương thức pct_change trên toàn chuỗi tháng
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

thang_series = ket_qua_idx_c1["r"].resample("ME").size()
thang_4nam_demo = thang_series.loc["2022":"2025"]

# Bắt đầu lời giải

import pandas as pd


def period_changes(thang: pd.Series, moc: str) -> dict:
    moc_tg = pd.Timestamp(moc)

    # Tính toán toàn bộ chuỗi phần trăm thay đổi
    pct_1 = thang.pct_change(periods=1) * 100.0
    pct_12 = thang.pct_change(periods=12) * 100.0

    so_ky_truoc = float(pct_1.loc[moc_tg])
    so_cung_ky = float(pct_12.loc[moc_tg])

    return {
        "so_ky_truoc": so_ky_truoc,
        "so_cung_ky": so_cung_ky,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_so_sanh_c2 = period_changes(thang_series, "2026-05-31")
display(f"Tháng 5/2026 so tháng trước: {kq_so_sanh_c2['so_ky_truoc']:+.1f}%")
display(f"Tháng 5/2026 so cùng kỳ: {kq_so_sanh_c2['so_cung_ky']:+.1f}%")

# Kết thúc lời giải
Giải thích cách 2
Đóng gói các phép so sánh thành dict giúp báo cáo mang tên đại lượng rõ ràng. Kiểm tra sự tồn tại của kỳ gốc và giá trị mẫu số trước khi chia. Kết quả cho tháng hiện tại chỉ được báo như kết quả cả tháng khi phạm vi quan sát của tháng đó đã đầy đủ.
Kết quả cách 2
| Kết quả |
|---|
| Tháng 5/2026 so cùng kỳ: +57.1% |
So sánh cách dùng
Hãy chọn Cách 1 khi bạn cần tra cứu chính xác một tháng cụ thể và kiểm tra tường minh sự tồn tại của các kỳ đối chiếu. Cách 2 phù hợp hơn khi muốn tính sẵn các chuỗi thay đổi trên toàn bộ lịch sử rồi mới trích xuất kết quả cần đọc.
Bài tập 12: Chuẩn hóa độ dài tháng và xử lý năm nhuận khi so sánh chu kỳ tháng
Bài tập 12: Điều chỉnh số ngày khác biệt của các tháng
Khi phân tích tính mùa vụ theo tháng, tháng 2 có số ngày ít hơn các tháng khác (28 ngày trong năm thường và 29 ngày trong năm nhuận). Nếu so sánh tổng số đánh giá thô, tháng 2 luôn xuất hiện mức sụt giảm giả tạo chỉ vì khoảng thời gian quan sát ngắn hơn 3 ngày (hoặc 2 ngày).
Cho chuỗi số đếm theo tháng của 4 năm liên tục từ 2022 đến 2025 (48 tháng). Hãy viết hàm monthly_daily_rate(thang_4nam: pd.Series) -> dict thực hiện:
- Tính
tong: Series tổng số đánh giá theo từng tháng trong 4 năm ( là số nguyên từ 1 đến 12). - Tính
tb_ngay: Series số đánh giá trung bình mỗi ngày theo từng tháng ( từ 1 đến 12), bằng tổng số đánh giá của tháng đó chia cho tổng số ngày thực tế của tháng đó trong cả 4 năm (sử dụng thuộc tính.index.days_in_monthcó tính đến năm nhuận 2024). - Tính
chenh_tong: Mức thay đổi tháng 2 so với tháng 1 theo tổng số đánh giá dạng tỷ lệ (tong[2] / tong[1] - 1). - Tính
chenh_ngay: Mức thay đổi tháng 2 so với tháng 1 theo số đánh giá trung bình mỗi ngày dạng tỷ lệ (tb_ngay[2] / tb_ngay[1] - 1).
Lời giải
Cách 1: Sử dụng days_in_month và nhóm theo tháng lịch
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def monthly_daily_rate(thang_4nam: pd.Series) -> dict:
    # 1. Trích xuất số ngày thực tế của từng tháng trong chuỗi
    so_ngay = pd.Series(thang_4nam.index.days_in_month, index=thang_4nam.index)

    # 2. Gom nhóm theo số tháng trong năm (1 đến 12)
    thang_so = pd.Index(thang_4nam.index.month, name="thang")
    tong = thang_4nam.groupby(thang_so).sum()
    tong_ngay = so_ngay.groupby(thang_so).sum()

    # 3. Tính số đánh giá trung bình mỗi ngày của từng tháng
    tb_ngay = tong / tong_ngay

    # 4. Tính toán tỷ lệ thay đổi tháng 2 so với tháng 1
    chenh_tong = float(tong.loc[2] / tong.loc[1] - 1.0)
    chenh_ngay = float(tb_ngay.loc[2] / tb_ngay.loc[1] - 1.0)

    return {
        "tong": tong,
        "tb_ngay": tb_ngay,
        "chenh_tong": chenh_tong,
        "chenh_ngay": chenh_ngay,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
thang_4nam_demo = ket_qua_idx_c1["r"].resample("ME").size().loc["2022":"2025"]
kq_rate_c1 = monthly_daily_rate(thang_4nam_demo)
display(f"Chênh lệch theo tổng: {kq_rate_c1['chenh_tong']:.2%}")
display(f"Chênh lệch theo ngày: {kq_rate_c1['chenh_ngay']:.2%}")

# Kết thúc lời giải
Giải thích cách 1
Tháng 1 và tháng 2 không có cùng số ngày. Chia số đánh giá từng tháng cho số ngày lịch của chính tháng đó tạo tốc độ đánh giá trên một ngày. Thuộc tính days_in_month giữ đúng tháng 2 của năm nhuận, tránh viết cứng 28 ngày.
Kết quả cách 1
| Kết quả |
|---|
| Chênh lệch theo ngày: -0.37% |
Cách 2: Tạo DataFrame trung gian với Named Aggregation
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

thang_series = ket_qua_idx_c1["r"].resample("ME").size()
thang_4nam_demo = thang_series.loc["2022":"2025"]

# Bắt đầu lời giải

import pandas as pd


def monthly_daily_rate(thang_4nam: pd.Series) -> dict:
    # Xây dựng bảng trung gian gồm số đánh giá và số ngày tương ứng
    df_thang = pd.DataFrame(
        {
            "so_danh_gia": thang_4nam,
            "so_ngay": thang_4nam.index.days_in_month,
            "thang": thang_4nam.index.month,
        }
    )

    # Tổng hợp đồng thời số lượng và số ngày
    bang_tong_hop = df_thang.groupby("thang").agg(
        tong_danh_gia=("so_danh_gia", "sum"),
        tong_so_ngay=("so_ngay", "sum"),
    )

    tong = bang_tong_hop["tong_danh_gia"]
    tb_ngay = bang_tong_hop["tong_danh_gia"] / bang_tong_hop["tong_so_ngay"]

    chenh_tong = float(tong.loc[2] / tong.loc[1] - 1.0)
    chenh_ngay = float(tb_ngay.loc[2] / tb_ngay.loc[1] - 1.0)

    return {
        "tong": tong,
        "tb_ngay": tb_ngay,
        "chenh_tong": chenh_tong,
        "chenh_ngay": chenh_ngay,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_rate_c2 = monthly_daily_rate(thang_4nam_demo)
display(f"Chênh lệch theo tổng: {kq_rate_c2['chenh_tong']:.2%}")
display(f"Chênh lệch theo ngày: {kq_rate_c2['chenh_ngay']:.2%}")

# Kết thúc lời giải
Giải thích cách 2
Tính cả tỷ lệ theo tổng tháng lẫn tỷ lệ theo số đánh giá mỗi ngày giúp thấy ảnh hưởng của độ dài tháng. Chúng có thể khác nhau mà không mâu thuẫn. Chỉ dùng số ngày lịch cho một tháng đã quan sát đủ, nếu dữ liệu kết thúc giữa tháng cần mẫu số là phạm vi quan sát tương ứng.
Kết quả cách 2
| Kết quả |
|---|
| Chênh lệch theo ngày: -0.37% |
So sánh cách dùng
Bạn nên chọn Cách 1 khi chỉ cần tính nhanh chỉ số đánh giá trung bình mỗi ngày theo số ngày thực tế của từng tháng. Cách 2 phù hợp khi bạn muốn xây dựng bảng tổng hợp hoàn chỉnh gồm cả số lượng và tốc độ để đối chiếu nhiều khía cạnh.
Bài tập 13: Mở rộng 1: Điều tra ngày kỷ lục và vùng lân cận bằng chuỗi ngày
Bài tập 13: Điều tra ngày kỷ lục
Trong chuỗi thời gian vận hành, các đỉnh đột biến thường gắn liền với sự kiện văn hóa hoặc lễ hội lớn. Để điều tra nguyên nhân, ta cần xác định ngày có số lượng đánh giá cao nhất toàn chuỗi và kiểm tra số lượng của các ngày xung quanh.
Hãy viết hàm investigate_peak_day(r: pd.DataFrame) -> dict nhận vào bảng r đã đánh thời gian. Hàm thực hiện:
- Tổng hợp số đánh giá mỗi ngày của toàn bộ chuỗi bằng
r.resample("D").size(). - Tìm ngày đạt số lượng đánh giá cao nhất toàn chuỗi
ngay_ky_luc(idxmax()) và số lượng tại ngày đóso_luong_ky_luc. - Trích xuất một Series
vung_lan_cangồm đúng 5 ngày liên tiếp nằm quanh ngày kỷ lục (từ 2 ngày trước đến 2 ngày sau ngày kỷ lục).
Lời giải
Cách 1: Sử dụng resample ngày và cắt lát bằng Timedelta
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def investigate_peak_day(r: pd.DataFrame) -> dict:
    # 1. Tổng hợp số đánh giá theo ngày toàn chuỗi
    chuoi_ngay = r.resample("D").size()

    # 2. Định vị ngày có số lượng đánh giá kỷ lục
    ngay_ky_luc = chuoi_ngay.idxmax()
    so_luong_ky_luc = int(chuoi_ngay.loc[ngay_ky_luc])

    # 3. Trích xuất vùng lân cận 5 ngày bằng khoảng thời gian Timedelta
    dau = ngay_ky_luc - pd.Timedelta(days=2)
    cuoi = ngay_ky_luc + pd.Timedelta(days=2)
    vung_lan_can = chuoi_ngay.loc[dau:cuoi]

    return {
        "ngay_ky_luc": ngay_ky_luc,
        "so_luong_ky_luc": so_luong_ky_luc,
        "vung_lan_can": vung_lan_can,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_dieu_tra_c1 = investigate_peak_day(ket_qua_idx_c1["r"])
display(
    f"Ngày kỷ lục: {kq_dieu_tra_c1['ngay_ky_luc']:%Y-%m-%d} với {kq_dieu_tra_c1['so_luong_ky_luc']} đánh giá"
)
display(kq_dieu_tra_c1["vung_lan_can"])

# Kết thúc lời giải
Giải thích cách 1
Đếm đánh giá theo từng ngày rồi tìm ngày có số đếm cao nhất. Nhãn ngày kỷ lục và số dòng của ngày đó là hai phần khác nhau của kết quả. Việc kiểm lại các bản ghi gốc giúp nhận biết một cụm nhập dữ liệu hoặc trùng khóa, không tự giải thích đó là ngày nhiều khách nhất.
Kết quả cách 1
| date | Giá trị |
|---|---|
| 2026-03-14 00:00:00 | 8 |
| 2026-03-15 00:00:00 | 8 |
| 2026-03-16 00:00:00 | 50 |
| 2026-03-17 00:00:00 | 8 |
| 2026-03-18 00:00:00 | 8 |
Cách 2: Sử dụng nlargest và cắt lát đối xứng
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd


def sinh_so_danh_gia(ngay: pd.Timestamp) -> int:
    muc = {2019: 3, 2020: 2, 2021: 2, 2022: 3, 2023: 4, 2024: 4, 2025: 5, 2026: 8}[
        ngay.year
    ]
    if ngay.year == 2020 and 3 <= ngay.month <= 6:
        muc = 0
    if ngay.month in (1, 2):
        muc += 2
    if ngay.dayofweek == 0:
        muc += 2
    if pd.Timestamp("2025-11-20") <= ngay <= pd.Timestamp("2025-11-26"):
        muc += 6
    if ngay == pd.Timestamp("2026-03-16"):
        muc += 40
    return muc


_ngay = pd.date_range("2019-01-01", "2026-07-01", freq="D")

_so = [sinh_so_danh_gia(ngay) for ngay in _ngay]

DEMO_REVIEWS = pd.DataFrame({"date": _ngay.repeat(_so)})

DEMO_REVIEWS.insert(0, "listing_id", [100 + k % 37 for k in range(len(DEMO_REVIEWS))])

DEMO_REVIEWS = DEMO_REVIEWS.sample(frac=1, random_state=8).reset_index(drop=True)

SNAPSHOT = "2026-06-29"


def prepare_time_index(rv: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Tạo mặt nạ lọc các dòng hợp lệ tại hoặc trước mốc chụp
    mat_na_hop_le = rv["date"] <= moc_tg

    # 2. Đếm số dòng xuất hiện sau mốc chụp dữ liệu
    so_dong_sau = int((~mat_na_hop_le).sum())

    # 3. Lọc dữ liệu, gán cột date làm chỉ mục và sắp xếp đơn điệu tăng dần
    r = rv.loc[mat_na_hop_le].set_index("date").sort_index(kind="mergesort")

    return {
        "so_dong_sau_moc": so_dong_sau,
        "r": r,
    }


ket_qua_idx_c1 = prepare_time_index(DEMO_REVIEWS, SNAPSHOT)
ket_qua_idx_c2 = ket_qua_idx_c1

# Bắt đầu lời giải

import pandas as pd


def investigate_peak_day(r: pd.DataFrame) -> dict:
    chuoi_ngay = r.resample("D").size()

    # Lấy ngày kỷ lục thông qua phương thức nlargest
    top_1 = chuoi_ngay.nlargest(1)
    ngay_ky_luc = top_1.index[0]
    so_luong_ky_luc = int(top_1.iloc[0])

    # Lấy vùng lân cận bằng chỉ số ngày đại số
    khoang_cach = pd.DateOffset(days=2)
    vung_lan_can = chuoi_ngay.loc[ngay_ky_luc - khoang_cach : ngay_ky_luc + khoang_cach]

    return {
        "ngay_ky_luc": ngay_ky_luc,
        "so_luong_ky_luc": so_luong_ky_luc,
        "vung_lan_can": vung_lan_can,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_dieu_tra_c2 = investigate_peak_day(ket_qua_idx_c2["r"])
display(
    f"Ngày kỷ lục: {kq_dieu_tra_c2['ngay_ky_luc']:%Y-%m-%d} với {kq_dieu_tra_c2['so_luong_ky_luc']} đánh giá"
)
display(kq_dieu_tra_c2["vung_lan_can"])

# Kết thúc lời giải
Giải thích cách 2
Gom các dấu kiểm vào một báo cáo giúp giữ lại số dòng, ngày và các thông tin đối chiếu. Tìm các chỗ ở hoặc bản ghi tạo nên đỉnh trước khi nêu một lời giải thích. Mỗi đánh giá là một sự kiện trong nguồn, không đồng nhất với một lần đặt phòng trong cùng ngày.
Kết quả cách 2
| date | Giá trị |
|---|---|
| 2026-03-14 00:00:00 | 8 |
| 2026-03-15 00:00:00 | 8 |
| 2026-03-16 00:00:00 | 50 |
| 2026-03-17 00:00:00 | 8 |
| 2026-03-18 00:00:00 | 8 |
So sánh cách dùng
Hãy chọn Cách 1 khi bạn chỉ cần xác định nhanh ngày đạt đỉnh kỷ lục và giá trị số đếm cao nhất trong chuỗi. Cách 2 cần thiết khi bạn muốn trích xuất các bản ghi gốc trong ngày đó nhằm kiểm tra dấu hiệu trùng lặp hoặc bất thường.
Bài tập 14: Mở rộng 2: Tính khoảng cách thời gian từ lần đánh giá gần nhất
Bài tập 14: Gắn cờ chỗ ở lâu chưa có đánh giá
Trong dữ liệu chỗ ở (listings), cột last_review ghi nhận ngày nhận đánh giá gần nhất. Một chỗ ở không nhận thêm đánh giá nào trong hơn 365 ngày tính đến mốc chụp dữ liệu có khả năng cao đã ngừng hoạt động hoặc rời khỏi nền tảng.
Cho listings chứa cột last_review. Hãy viết hàm days_since_last_review(listings: pd.DataFrame, snapshot: str) -> dict thực hiện:
- Chuyển đổi cột
last_reviewsang kiểudatetime64. - Xác định
so_cho_o_ngoai_moc: Số lượng chỗ ở có ngày đánh giá sausnapshot. - Lọc bỏ các chỗ ở ngoài mốc này, sau đó tính số ngày từ lần đánh giá gần nhất đến mốc chụp dữ liệu (
(pd.Timestamp(snapshot) - last_review).dt.days). - Gán nhãn cờ boolean
co_khong_hoat_dongbằngTruenếu chỗ ở có số ngày trên 365 ngày hoặc chưa từng có đánh giá nào (last_reviewbị khuyết). - Trả về từ điển gồm:
so_cho_o_ngoai_moc,so_cho_o_tren_365_ngay(đếm trên các chỗ ở có đánh giá và cách trên 365 ngày), và kết quảlistings_gan_co.
Lời giải
Cách 1: Xử lý tuần tự bằng các phép toán Series trực tiếp
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

SNAPSHOT = "2026-06-29"

LISTINGS_DEMO = pd.DataFrame(
    {
        "id": [101, 102, 103, 104, 105],
        "name": [
            "Căn hộ trung tâm",
            "Phòng riêng Bellas Artes",
            "Loft Providencia",
            "Studio Recoleta",
            "Nhà cổ Brasil",
        ],
        "last_review": ["2026-05-15", "2025-01-10", "2026-07-02", "2024-11-20", None],
    }
)

# Bắt đầu lời giải

import pandas as pd


def days_since_last_review(listings: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # 1. Ép kiểu dữ liệu thời gian an toàn
    df = listings.copy()
    df["last_review_dt"] = pd.to_datetime(df["last_review"], errors="coerce")

    # 2. Xác định các chỗ ở có ngày ghi nhận sau mốc chụp
    ngoai_moc_mask = df["last_review_dt"] > moc_tg
    so_ngoai_moc = int(ngoai_moc_mask.sum())

    # 3. Giữ lại các chỗ ở hợp lệ và tính số ngày trôi qua
    df_hop_le = df.loc[~ngoai_moc_mask].copy()
    so_ngay = (moc_tg - df_hop_le["last_review_dt"]).dt.days
    df_hop_le["so_ngay_tu_rv_cuoi"] = so_ngay

    # 4. Xác định chỗ ở trên 365 ngày và gắn cờ không hoạt động
    tren_365 = so_ngay > 365
    so_tren_365 = int(tren_365.sum())

    # Cờ không hoạt động: Hoặc trên 365 ngày hoặc chưa từng có review (khuyết)
    df_hop_le["co_khong_hoat_dong"] = tren_365 | df_hop_le["last_review_dt"].isna()

    return {
        "so_cho_o_ngoai_moc": so_ngoai_moc,
        "so_cho_o_tren_365_ngay": so_tren_365,
        "listings_gan_co": df_hop_le,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_last_rv_c1 = days_since_last_review(LISTINGS_DEMO, SNAPSHOT)
display(
    f"Ngoài mốc: {kq_last_rv_c1['so_cho_o_ngoai_moc']}, Trên 365 ngày: {kq_last_rv_c1['so_cho_o_tren_365_ngay']}"
)
display(
    kq_last_rv_c1["listings_gan_co"][
        ["name", "so_ngay_tu_rv_cuoi", "co_khong_hoat_dong"]
    ]
)

# Kết thúc lời giải
Giải thích cách 1
Đọc last_review thành ngày rồi lấy snapshot trừ ngày đánh giá cuối. .dt.days cho số ngày đã trôi qua, còn chỗ ở chưa có ngày đánh giá giữ NaN. Khoảng thời gian dài không có đánh giá là một dấu hiệu cần khảo sát, không đủ chứng minh chỗ ở đã ngừng hoạt động.
Kết quả cách 1
| name | so_ngay_tu_rv_cuoi | co_khong_hoat_dong | |
|---|---|---|---|
| 0 | Căn hộ trung tâm | 45 | False |
| 1 | Phòng riêng Bellas Artes | 535 | True |
| 3 | Studio Recoleta | 586 | True |
| 4 | Nhà cổ Brasil | NaN | True |
Cách 2: Sử dụng assign và phương thức vector hóa an toàn
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

SNAPSHOT = "2026-06-29"

LISTINGS_DEMO = pd.DataFrame(
    {
        "id": [101, 102, 103, 104, 105],
        "name": [
            "Căn hộ trung tâm",
            "Phòng riêng Bellas Artes",
            "Loft Providencia",
            "Studio Recoleta",
            "Nhà cổ Brasil",
        ],
        "last_review": ["2026-05-15", "2025-01-10", "2026-07-02", "2024-11-20", None],
    }
)

# Bắt đầu lời giải

import pandas as pd
import numpy as np


def days_since_last_review(listings: pd.DataFrame, snapshot: str) -> dict:
    moc_tg = pd.Timestamp(snapshot)

    # Chuyển đổi và lọc các dòng hợp lệ trong một bước
    rev_dt = pd.to_datetime(listings["last_review"], errors="coerce")
    mask_ngoai = rev_dt > moc_tg
    so_ngoai_moc = int(mask_ngoai.sum())

    df_loc = listings.loc[~mask_ngoai].copy()
    rev_loc = rev_dt.loc[~mask_ngoai]

    so_ngay = (moc_tg - rev_loc).dt.days
    co_ngung = (so_ngay > 365) | rev_loc.isna()

    df_loc = df_loc.assign(
        so_ngay_tu_rv_cuoi=so_ngay,
        co_khong_hoat_dong=co_ngung,
    )

    so_tren_365 = int((so_ngay > 365).sum())

    return {
        "so_cho_o_ngoai_moc": so_ngoai_moc,
        "so_cho_o_tren_365_ngay": so_tren_365,
        "listings_gan_co": df_loc,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_last_rv_c2 = days_since_last_review(LISTINGS_DEMO, SNAPSHOT)
display(
    f"Ngoài mốc: {kq_last_rv_c2['so_cho_o_ngoai_moc']}, Trên 365 ngày: {kq_last_rv_c2['so_cho_o_tren_365_ngay']}"
)
display(
    kq_last_rv_c2["listings_gan_co"][
        ["name", "so_ngay_tu_rv_cuoi", "co_khong_hoat_dong"]
    ]
)

# Kết thúc lời giải
Giải thích cách 2
Tạo các mặt nạ riêng cho ngày thiếu, ngày sau snapshot và ngày đã cũ giúp báo cáo phân biệt ba tình huống. Không gom mọi kết quả âm hoặc thiếu vào nhóm ngừng hoạt động. Quy tắc gắn cờ phải nêu rõ ngưỡng ngày và chỉ được dùng trong phạm vi nguồn đang xét.
Kết quả cách 2
| name | so_ngay_tu_rv_cuoi | co_khong_hoat_dong | |
|---|---|---|---|
| 0 | Căn hộ trung tâm | 45 | False |
| 1 | Phòng riêng Bellas Artes | 535 | True |
| 3 | Studio Recoleta | 586 | True |
| 4 | Nhà cổ Brasil | NaN | True |
So sánh cách dùng
Bạn nên chọn Cách 1 khi chỉ cần tính nhanh khoảng cách ngày giữa lần đánh giá cuối và mốc snapshot vào một cột số liệu. Cách 2 phù hợp hơn khi cần gắn cờ phân loại chi tiết để tách biệt giữa dữ liệu khuyết thiếu, mốc sai lệch và hồ sơ đã cũ.
4. Tóm tắt các quy tắc xử lý chuỗi thời gian
| Khái niệm / Thao tác | Cú pháp khuyến nghị | Lưu ý nghiệp vụ và kỹ thuật |
|---|---|---|
| Ép kiểu ngày giờ | pd.to_datetime(..., format=..., errors="coerce") | Luôn chỉ định định dạng ngày và xử lý lỗi thành NaT |
| Cắt lát nhãn chuỗi | r.loc["2025"] hoặc r.loc["2025-01":"2025-06"] | Bắt buộc DatetimeIndex phải được sắp xếp đơn điệu tăng dần |
| Tổng hợp theo quý | r.resample("QE").size() | Bí danh QE thay thế Q, luôn kiểm tra kỳ chưa trọn cuối cùng |
| Lưới ngày liên tục | r.loc[nam].resample("D").size() | Cắt lát năm trước khi resample, tự động điền 0 cho ngày trống |
| 7 ngày | ngay.rolling(7, center=True).mean() | Phân biệt cửa sổ 7 hàng và 7 ngày, kiểm soát min_periods |
| So sánh cùng kỳ theo quý | quy / quy.shift(4) - 1.0 | Dữ liệu quý dùng bước nhảy 4, tránh sao chép máy móc bước nhảy 12 của tháng |
| So sánh theo tháng | period_changes(thang, moc) | Phân biệt rõ giữa so kỳ trước (MoM) và so cùng kỳ năm trước (YoY) |
| Chuẩn hóa độ dài tháng | tong_thang / tong_ngay_thuc_te | Dùng .index.days_in_month để triệt tiêu ảnh hưởng của tháng 2 và năm nhuận |
Tài liệu tham khảo
- Wes McKinney, Python for Data Analysis, 3rd Edition, Chapter 11: Time Series. URL: https://wesmckinney.com/book/time-series.
- Tài liệu chính thức pandas: Time Series / Date Functionality. URL: https://pandas.pydata.org/docs/user_guide/timeseries.html.
- Cơ sở dữ liệu quốc tế IANA: Time Zone Database. URL: https://www.iana.org/time-zones.
- Viện Trí tuệ Nhân tạo, Trường Đại học Công nghệ, ĐHQGHN: Giáo trình Lập trình xử lý dữ liệu (Bài 8: Xử lý dữ liệu thời gian). Các bài tập thực hành được chuyển thể theo giấy phép CC BY-NC-SA 4.0.
IAI, Lập trình xử lý dữ liệu, học liệu và notebook. Các đề thực hành đã được biên tập cách diễn đạt và bổ sung lời giải, giữ CC BY-NC-SA 4.0. Giấy phép học liệu.
IAI. Notebook thực hành và học liệu thực hành 2627-1. Các yêu cầu kỹ thuật được đối chiếu, biên tập và bổ sung lời giải cùng dữ liệu minh họa. Phần thích nghi từ học liệu IAI áp dụng giấy phép CC BY-NC-SA 4.0.