Giao diện
Một bảng dữ liệu chứa hàng chục nghìn con số có thể ẩn giấu những tri thức vô giá, nhưng bộ não con người không được tiến hóa để đọc hiểu các ma trận số học khô khốc một cách trực quan. Trực quan hóa dữ liệu không đơn thuần là việc vẽ những bức tranh minh họa bắt mắt. Về bản chất khoa học, đây là quá trình mã hóa thị giác thông tin định lượng (Visual Encoding of Quantitative Information), biến các giá trị toán học trừu tượng thành các thuộc tính không gian và hình học mà mắt người có thể tiếp nhận và phân tích tức thì.
Các nghiên cứu kinh điển về nhận thức thị giác (tiêu biểu là công trình của William Cleveland và Robert McGill năm 1984) đã chứng minh rằng: Mắt người phán đoán vị trí trên cùng một thang đo và so sánh chiều dài thanh với độ chính xác cao nhất. Trái lại, việc ước lượng diện tích, góc nghiêng hay độ đậm nhạt của màu sắc thường có sai số nhận thức lớn hơn rất nhiều. Do đó, việc lựa chọn dạng biểu đồ nào hoàn toàn không phụ thuộc vào cảm tính thẩm mỹ cá nhân, mà được quyết định bởi bản chất cấu trúc của dữ liệu và thông điệp phân tích bạn muốn truyền tải.
Bài học này cung cấp nền tảng bài bản về trực quan hóa dữ liệu trong Python bằng kiến trúc hướng đối tượng của Matplotlib. Người học sẽ thực hành vẽ các biểu đồ thống kê với pandas và Seaborn, tìm hiểu cơ chế ước lượng mật độ, và rèn luyện kỹ năng phản biện biểu đồ nhằm bảo đảm tính trung thực của các ấn phẩm phân tích.
1. Sơ lược về giao diện API của Matplotlib
Thư viện Matplotlib là nền móng của toàn bộ hệ sinh thái trực quan hóa dữ liệu trong Python. Mặc dù Matplotlib cung cấp giao diện toàn cục theo phong cách MATLAB (plt.plot), trong môi trường kỹ nghệ dữ liệu chuyên nghiệp và các đường ống tự động hóa, chuẩn mực bắt buộc là sử dụng giao diện hướng đối tượng (Object-Oriented API) tường minh.
1.1. Kiến trúc Figure và Subplots
Kiến trúc hướng đối tượng phân tách rạch ròi hai thực thể nền tảng:
Figure: Đại diện cho toàn bộ khung tranh vật lý, bao gồm kích thước khung hình (tính bằng inchfigsize), độ phân giải xuất bản (dpi), màu nền và toàn bộ các biểu đồ con bên trong.Axes: Đại diện cho một hệ tọa độ cụ thể nằm trên Figure. Một đối tượng Axes sở hữu trục hoành (), trục tung ( ), lưới tọa độ, vạch chia (ticks), nhãn và toàn bộ các đối tượng hình học (đường nét, cột, điểm phân tán). Một Figure có thể chứa một hoặc nhiều Axes.
Hàm plt.subplots() là điểm khởi đầu chuẩn mực để khởi tạo đồng thời cả Figure và lưới các Axes:
python
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

# Khởi tạo Figure và lưới 2x2 gồm 4 Axes
fig, axes = plt.subplots(2, 2, figsize=(8, 6), sharex=False, sharey=False)

# Vẽ dữ liệu lên từng hệ tọa độ độc lập
axes[0, 0].hist(np.random.standard_normal(200), bins=20, color="#1E93AB", alpha=0.6)
axes[0, 0].set_title("Histogram biến chuẩn")

axes[0, 1].scatter(np.arange(30), np.arange(30) + 3 * np.random.standard_normal(30), color="#D65A31")
axes[0, 1].set_title("Biểu đồ phân tán")

axes[1, 0].plot(np.random.standard_normal(50).cumsum(), color="#393E46", linestyle="--")
axes[1, 0].set_title("Đường ngẫu nhiên")

axes[1, 1].bar(["Nhóm A", "Nhóm B", "Nhóm C"], [15, 28, 19], color="#2E7D32")
axes[1, 1].set_title("So sánh độ lớn")

fig.tight_layout()
plt.close(fig)
1.2. Căn chỉnh khoảng cách với subplots_adjust và tight_layout
Mặc định, Matplotlib để lại các khoảng trống nhất định xung quanh các biểu đồ con. Phương thức fig.tight_layout() tự động căn chỉnh lề để các nhãn trục không bị đè lên nhau. Khi cần tinh chỉnh thủ công khoảng cách giữa các khung vẽ, ta sử dụng:
python
fig.subplots_adjust(left=0.1, right=0.95, bottom=0.1, top=0.9, wspace=0.3, hspace=0.3)Trong đó, wspace và hspace kiểm soát tỷ lệ khoảng cách theo chiều ngang và chiều dọc giữa các Axes.
1.3. Màu sắc, điểm đánh dấu và kiểu đường nét
Khi vẽ biểu đồ đường hoặc đồ thị điểm, các tham số định dạng thẩm mỹ bao gồm:
color: Tên màu chuẩn ("red","teal"), chữ cái viết tắt ("k"cho màu đen,"b"cho màu xanh dương), hoặc mã màu Hex ("#1E93AB").linestyle: Kiểu nét vẽ ("-"nét liền,"--"nét đứt,":"nét chấm,"-."nét gạch chấm).marker: Ký hiệu điểm đánh dấu ("o"hình tròn,"s"hình vuông,"^"hình tam giác,"x"dấu nhân).alpha: Độ trong suốt từ(trong suốt hoàn toàn) đến (đặc hoàn toàn), vũ khí chủ lực để xử lý hiện tượng chồng lấn điểm (Overplotting).
1.4. Vạch chia, nhãn và chú giải (Ticks, Labels, and Legends)
Để một biểu đồ có thể tự đứng được mà không cần người thuyết minh, mọi trục tọa độ đều phải được ghi nhãn rõ ràng kèm đơn vị đo lường:
ax.set_xticks()vàax.set_xticklabels(): Định vị các mốc vạch chia và gán nhãn văn bản (hỗ trợ tham sốrotation=30khi nhãn quá dài).ax.set_xlabel(),ax.set_ylabel(): Tên đại lượng và đơn vị đo lường.ax.set_title(): Tiêu đề nêu bật thông điệp phân tích của biểu đồ.ax.legend(loc="best"): Thêm hộp chú giải giải thích ý nghĩa của từng đường vẽ dựa trên tham sốlabelđã gán.
1.5. Chú thích và vẽ hình học trên Subplot
Bên cạnh các đường vẽ chính, việc dẫn dắt ánh nhìn của người đọc đến các sự kiện đặc biệt (như mốc khủng hoảng kinh tế hoặc điểm bão hòa) được thực hiện bằng chú thích:
ax.text(x, y, chuoi): Vẽ chuỗi văn bản tại tọa độ. ax.annotate(): Vẽ đoạn văn bản kèm theo mũi tên chỉ trực tiếp vào điểm dữ liệu quan trọng:
python
fig, ax = plt.subplots(figsize=(6, 3.5))
ax.plot([1, 2, 3, 4, 5], [10, 14, 25, 18, 12], marker="o", color="#1E93AB")

# Chỉ mũi tên vào đỉnh cực đại:
ax.annotate(
    "Đỉnh doanh thu",
    xy=(3, 25),
    xytext=(3.5, 23),
    arrowprops=dict(facecolor="black", shrink=0.08, width=1.5, headwidth=6)
)
ax.set_ylim(bottom=0)
plt.close(fig)
Ngoài ra, ta có thể bổ sung các hình học trực quan như đường thẳng tham chiếu ngang/dọc (ax.axhline(), ax.axvline()) hoặc các mảng hình học từ matplotlib.patches (như Rectangle, Circle) thông qua phương thức ax.add_patch().
1.6. Xuất bản biểu đồ ra tệp với savefig
Phương thức fig.savefig() cho phép lưu biểu đồ xuống đĩa cứng với hai họ định dạng chính:
- Định dạng điểm ảnh (Raster Image - PNG, JPEG): Biểu diễn hình ảnh bằng lưới các pixel. Thích hợp cho các biểu đồ chứa hàng triệu điểm dữ liệu phân tán. Cần thiết lập
dpi=300để bảo đảm độ sắc nét khi in ấn. - Định dạng vector (Vector Image - SVG, PDF): Biểu diễn hình ảnh bằng các phương trình toán học về đường cong và nét vẽ. Cho phép phóng to thu nhỏ tùy ý mà không bao giờ bị vỡ hạt, lý tưởng cho các bài báo khoa học và tài liệu web.
- Tham số
bbox_inches="tight": Tự động cắt bỏ các khoảng trắng thừa ở viền ngoài bức tranh.
1.7. Cấu hình giao diện toàn cục với rcParams
Để toàn bộ các biểu đồ trong dự án tuân theo một ngôn ngữ thiết kế đồng nhất, Matplotlib cho phép cấu hình các tham số hệ thống thông qua plt.rcParams.update():
python
plt.rcParams.update({
    "font.size": 10,
    "axes.spines.top": False,
    "axes.spines.right": False,
    "axes.grid": True,
    "grid.alpha": 0.3,
    "figure.autolayout": True
})
2. Vẽ biểu đồ với pandas và Seaborn
Trong khi Matplotlib đóng vai trò là động cơ vẽ cấp thấp, pandas và Seaborn cung cấp các giao diện cấp cao được thiết kế riêng để tương tác trực tiếp với cấu trúc .
2.1. Vẽ nhanh với pandas .plot
Các đối tượng Series và tích hợp sẵn thuộc tính .plot:
- Biểu đồ đường: Dùng
df.plot(kind="line")hoặcdf.plot(). - Biểu đồ cột: Dùng
s.plot.bar()(cột đứng) hoặcs.plot.barh()(thanh ngang). Tham sốstacked=Truecho phép vẽ biểu đồ cột chồng tích lũy.
python
df_doanh_so = pd.DataFrame({
    "Chi_nhanh_A": [120, 150, 180],
    "Chi_nhanh_B": [90, 140, 160]
}, index=["Quý 1", "Quý 2", "Quý 3"])

ax = df_doanh_so.plot.bar(figsize=(6, 4), color=["#1E93AB", "#D65A31"])
ax.set_ylabel("Doanh thu (triệu đồng)")
plt.close(ax.get_figure())
2.2. Biểu đồ tần suất và ước lượng mật độ nhân (KDE)
- Histogram: Dùng
s.plot.hist(bins=20)chia dữ liệu thành các khoảng và đếm tần số xuất hiện. - Biểu đồ mật độ (Density Plot / KDE): Dùng
s.plot.kde()hoặcsns.kdeplot()làm mịn phân phối dữ liệu rời rạc thành một đường cong liên tục bằng phương pháp Ước lượng Mật độ Nhân (Kernel Density Estimation). Mỗi quan sát thực tế được mô hình hóa bằng một hàm nhân chuẩn hóa thu nhỏ (thường là phân phối Gauss), và đường cong mật độ tổng thể là tổng tích lũy của toàn bộ các hàm nhân này.
Tham số độ rộng băng thông (bandwidth, điều khiển bằng bw_adjust trong Seaborn) quyết định mức độ làm mịn của đường cong. Băng thông quá hẹp sẽ khiến đường cong gồ ghề và bắt chước nhiễu ngẫu nhiên, trong khi băng thông quá rộng sẽ làm lu mờ các đỉnh phân phối quan trọng:
python
import seaborn as sns

du_lieu_mau = np.array([1.2, 1.5, 1.8, 3.8, 4.0, 4.2, 4.5, 4.8])
fig, ax = plt.subplots(figsize=(6, 3.5))

# So sánh băng thông chuẩn và băng thông nhạy dao động
sns.kdeplot(du_lieu_mau, bw_adjust=1.0, label="Băng thông chuẩn (bw_adjust=1.0)", color="#1E93AB", ax=ax)
sns.kdeplot(du_lieu_mau, bw_adjust=0.5, label="Băng thông hẹp (bw_adjust=0.5)", color="#D65A31", linestyle="--", ax=ax)
ax.set_title("Ước lượng mật độ nhân với các mức băng thông khác nhau")
ax.legend()
plt.close(fig)
2.3. Biểu đồ phân tán, đồ thị hồi quy và ma trận tương quan
sns.scatterplot(x="bien_x", y="bien_y", hue="nhom", data=df): Thể hiện mối quan hệ giữa hai biến số thực, hỗ trợ phân biệt các nhóm đối tượng bằng kênh màu sắchue.sns.regplot(): Tự động ước lượng và vẽ đường hồi quy tuyến tính đi kèm dải tin cậy(Confidence Interval Band), giúp đánh giá trực quan hướng vận động và độ chặt chẽ của mối liên hệ giữa hai biến số. sns.boxplot(): Biểu diễn phân phối định lượng qua các tứ phân vị và nhận diện giá trị ngoại lai, kết hợp tham sốhueđể phân rã thêm một chiều phân loại phụ.
python
df_tips = pd.DataFrame({
    "ngay": ["Thứ 5", "Thứ 5", "Thứ 6", "Thứ 6", "Thứ 7", "Thứ 7", "CN", "CN"],
    "tong_hoa_don": [18.5, 25.0, 22.0, 30.5, 35.0, 42.0, 38.0, 48.5],
    "thoi_gian": ["Trưa", "Tối", "Trưa", "Tối", "Tối", "Tối", "Trưa", "Tối"]
})

fig, ax = plt.subplots(figsize=(6, 4))
sns.boxplot(data=df_tips, x="ngay", y="tong_hoa_don", hue="thoi_gian", palette="Set2", ax=ax)
ax.set_title("Phân bố hóa đơn theo ngày và thời gian với kênh màu sắc hue")
ax.set_ylabel("Tổng hóa đơn (USD)")
plt.close(fig)sns.heatmap(): Trực quan hóa ma trận số học hoặc ma trận hệ số tương quan bằng bản đồ nhiệt màu, hiển thị trực tiếp giá trị số trên từng ô qua tham sốannot=True:
python
df_tuong_quan = pd.DataFrame({
    "Doanh_thu": [100, 150, 200, 250, 300],
    "Chi_phi_QC": [10, 18, 25, 32, 40],
    "So_don_hang": [50, 70, 95, 110, 130]
})
ma_tran_corr = df_tuong_quan.corr()

fig, ax = plt.subplots(figsize=(5, 4))
sns.heatmap(ma_tran_corr, annot=True, cmap="Blues", fmt=".2f", vmin=-1, vmax=1, ax=ax)
ax.set_title("Ma trận tương quan với Seaborn Heatmap")
plt.close(fig)
2.4. Lưới biểu đồ khía cạnh với FacetGrid và catplot
Khi tập dữ liệu chứa nhiều chiều phân loại, việc nhồi nhét tất cả vào một biểu đồ duy nhất sẽ gây quá tải thị giác (Visual Clutter). Seaborn giải quyết bài toán này bằng kỹ thuật lưới biểu đồ khía cạnh:
sns.catplot(x=..., y=..., hue=..., data=..., kind="box"|"violin"|"bar"): Trực quan hóa dữ liệu phân loại với các kiểu hiển thị đa dạng như biểu đồ hộp (Boxplot) hay biểu đồ vĩ cầm (Violin plot).sns.FacetGrid: Tạo một ma trận gồm nhiều biểu đồ nhỏ (Small Multiples), trong đó mỗi biểu đồ con khảo sát cùng một mối quan hệ nhưng trên một phân khúc dữ liệu riêng biệt:
python
df_khao_sat = pd.DataFrame({
    "chi_phi": [15, 22, 40, 18, 35, 50, 12, 28],
    "tien_tip": [2.5, 3.0, 6.0, 2.8, 5.0, 8.5, 1.8, 4.2],
    "buoi": ["Trưa", "Tối", "Tối", "Trưa", "Tối", "Tối", "Trưa", "Tối"],
    "gioi_tinh": ["Nam", "Nữ", "Nam", "Nữ", "Nam", "Nữ", "Nam", "Nữ"]
})

g = sns.FacetGrid(df_khao_sat, col="buoi", row="gioi_tinh", margin_titles=True)
g.map(sns.scatterplot, "chi_phi", "tien_tip", color="#1E93AB")
plt.close(g.fig)
3. Phản biện biểu đồ và nguyên tắc trung thực thị giác
Trực quan hóa dữ liệu có vai trò định hướng nhận thức quan trọng. Một biểu đồ được thiết kế sai lệch có thể phóng đại những chênh lệch nhỏ, hoặc ngược lại che giấu đi những biến động đáng lưu tâm trong dữ liệu.
3.1. Phản biện ba cạm bẫy trực quan hóa kinh điển
Cạm bẫy 1: Cắt cụt trục tung của biểu đồ cột (Truncated Y-axis)
- Cơ chế: Khi nhìn vào biểu đồ cột hoặc thanh ngang, mắt người tự động mã hóa độ lớn dựa trên chiều dài hình học của thanh so với đường cơ sở (baseline).
- Hệ quả: Nếu tỷ lệ của hai đơn vị là
và , nhưng người vẽ cắt cụt trục tung bắt đầu từ mốc : Thanh thứ hai sẽ có chiều dài hiển thị là đơn vị, gấp đôi thanh thứ nhất ( đơn vị). Người đọc dễ lầm tưởng rằng đơn vị thứ hai vượt trội gấp đôi, trong khi khoảng cách thực tế chỉ là điểm phần trăm. - Nguyên tắc trực quan: Đối với biểu đồ cột và thanh ngang, trục đo chiều dài bắt buộc phải xuất phát từ mốc
để bảo toàn tỷ lệ trực quan:
python
df_so_sanh = pd.DataFrame({
    "don_vi": ["Đơn vị A", "Đơn vị B"],
    "ty_le": [94.0, 98.0]
})

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(8, 3.5))

# Biểu đồ sai lệch: Trục tung bị cắt cụt từ 90 làm méo mó trực quan
ax1.bar(df_so_sanh["don_vi"], df_so_sanh["ty_le"], color=["#1E93AB", "#D65A31"])
ax1.set_ylim(bottom=90, top=100)
ax1.set_title("Trục tung cắt cụt (Phóng đại chênh lệch)")
ax1.set_ylabel("Tỷ lệ (%)")

# Biểu đồ chuẩn mực: Trục tung bắt đầu từ 0 bảo toàn tỷ lệ chiều dài
ax2.bar(df_so_sanh["don_vi"], df_so_sanh["ty_le"], color=["#1E93AB", "#D65A31"])
ax2.set_ylim(bottom=0, top=100)
ax2.set_title("Trục tung từ 0 (Trung thực)")
ax2.set_ylabel("Tỷ lệ (%)")

fig.tight_layout()
plt.close(fig)
Cạm bẫy 2: Cạm bẫy trục tung kép (Dual Y-axis)
- Cơ chế: Đặt hai biến số có thang đo và đơn vị hoàn toàn khác nhau lên cùng một biểu đồ đường với hai trục tung bên trái và bên phải.
- Hệ quả: Người vẽ có thể tùy tiện co giãn khoảng giá trị của hai trục tung để ép hai đường cong chạy song song hoặc cắt nhau tại bất kỳ điểm nào, ngụy tạo mối tương quan hình thức giữa hai biến số vốn không liên quan.
- Giải pháp: Thay vì dùng trục kép, hãy vẽ hai biểu đồ con nằm xếp chồng theo chiều dọc (Stacked Subplots) có chung trục hoành thời gian, hoặc chuyển đổi các đại lượng về dạng chỉ số tăng trưởng tương đối (phần trăm thay đổi so với mốc cơ sở).
Cạm bẫy 3: Biểu đồ tròn quá nhiều lát và đồ thị 3D giả lập
- Cơ chế: Biểu đồ tròn mã hóa dữ liệu bằng góc ở tâm và diện tích hình quạt. Khi biểu đồ tròn có nhiều hoặc các lát có kích thước gần tương đồng, mắt người rất khó so sánh chính xác góc và diện tích hình quạt. Đặc biệt, việc lạm dụng hiệu ứng 3D làm biến dạng góc nghiêng: Các lát cắt nằm ở phía trước góc nhìn phối cảnh sẽ bị phóng đại nhân tạo, trong khi các lát cắt ở phía sau bị thu nhỏ lại.
- Giải pháp: Luôn thay thế biểu đồ tròn phức tạp bằng một biểu đồ thanh ngang được sắp xếp thứ tự giảm dần.
3.2. Tỷ lệ dữ liệu trên mực in
Trong tác phẩm The Visual Display of Quantitative Information, Edward Tufte giới thiệu khái niệm Tỷ lệ dữ liệu trên mực in (Data-to-Ink Ratio). Khái niệm này biểu thị tỷ lệ giữa lượng mực dùng để truyền tải thông tin dữ liệu cốt lõi so với tổng lượng mực tạo nên toàn bộ biểu đồ. Một biểu đồ được thiết kế hiệu quả cần tối ưu hóa tỷ lệ này bằng cách:
- Loại bỏ các chi tiết trang trí rườm rà không mang thông tin (Chartjunk), chẳng hạn như bóng đổ 3D, họa tiết hoa văn không cần thiết, và đường viền khung tranh dày đặc.
- Tiết chế độ đậm của các đường lưới tọa độ (Gridlines): Đường lưới chỉ đóng vai trò hỗ trợ đọc số liệu, không được phép lấn át các đường biểu diễn dữ liệu chính.
3.3. Bản đồ phân vùng địa lý (Choropleth Maps) và cạm bẫy diện tích
Bản đồ Choropleth tô màu các vùng địa lý (như tỉnh thành, quốc gia) theo một chỉ số định lượng (chẳng hạn thu nhập bình quân, tỷ lệ thất nghiệp hoặc mật độ dân số). Quy trình kỹ thuật kết hợp cấu trúc hình học không gian (GeoJSON hoặc Shapefile) với bảng dữ liệu thống kê thông qua phương thức ghép nối dữ liệu.
Tuy nhiên, bản đồ Choropleth cần được đọc cẩn trọng trước Cạm bẫy diện tích địa lý (Geographic Area Trap):
- Trên bản đồ, những khu vực có diện tích đất đai rộng lớn (như vùng rừng núi hoặc hoang mạc) sẽ chiếm trọn thị giác của người xem nhờ diện tích mảng màu rất lớn.
- Ngược lại, các trung tâm đô thị đông dân cư và có đóng góp kinh tế trọng yếu lại chỉ là những chấm nhỏ li ti khó nhìn thấy.
- Nguyên tắc nhận thức: Diện tích đất đai không đồng nghĩa với tầm quan trọng của dữ liệu. Cần cân nhắc sử dụng bản đồ bong bóng (Bubble Map) hoặc bản đồ biến dạng diện tích (Cartogram) khi nghiên cứu các chỉ số gắn liền với dân số.
3.4. Trực quan hóa tương tác với Plotly Express
Biểu đồ tĩnh tạo bởi Matplotlib và Seaborn phù hợp cho các báo cáo dạng in ấn và tài liệu học thuật. Trong khi đó, các thư viện trực quan hóa tương tác như Plotly Express cung cấp trải nghiệm khám phá linh hoạt trên môi trường web:
- Khám phá chi tiết (Hover tooltips): Người dùng có thể rê chuột lên từng điểm dữ liệu để đọc chính xác tọa độ, nhãn định danh và các thuộc tính phụ trợ mà không làm rối mắt bức tranh tổng thể.
- Thao tác động (Zoom & Pan): Cho phép phóng to vào các cụm dữ liệu dày đặc và di chuyển qua lại giữa các khoảng thời gian.
- Lựa chọn công cụ: Sử dụng biểu đồ tĩnh khi cần cố định bố cục trang in và xuất bản định dạng vector, còn sử dụng biểu đồ tương tác trong các bảng điều khiển nghiệp vụ (Dashboards) để người dùng có thể lọc và phóng to theo nhu cầu.
4. Tổng kết
- Tuân thủ kiến trúc hướng đối tượng: Khởi tạo
fig, ax = plt.subplots()tường minh để phân định ranh giới giữa khung tranhFigurevà hệ tọa độAxes, giúp kiểm soát chặt chẽ bố cục nhiều thành phần. - Khai thác Seaborn cho đồ họa thống kê: Sử dụng
catplotvàFacetGridđể phân rã dữ liệu nhiều chiều thành các biểu đồ con trực quan, tránh nhồi nhét quá tải thị giác. - Bảo đảm tính chuẩn mực của biểu đồ cột: Không cắt cụt trục tung của biểu đồ cột và thanh ngang, trục đo chiều dài cần xuất phát từ mốc
để bảo toàn tỷ lệ trực quan. - Cảnh giác trước cạm bẫy trực quan: Tránh sử dụng trục tung kép gây ngụy tạo tương quan, đồng thời hạn chế biểu đồ tròn quá nhiều lát và các hiệu ứng 3D làm sai lệch nhận thức hình học.
- Tối ưu hóa tỷ lệ dữ liệu trên mực in: Giảm bớt các chi tiết trang trí rườm rà (Chartjunk) và tiết chế độ đậm của đường lưới nhằm làm nổi bật tín hiệu phân tích cốt lõi.
- Nhận thức ranh giới của bản đồ Choropleth: Phân biệt rạch ròi giữa diện tích lãnh thổ địa lý với mật độ dân số hoặc quy mô kinh tế của vùng dữ liệu.
Tài liệu tham khảo
Wes McKinney, Python for Data Analysis (tái bản lần 3): Chương 9: Plotting and Visualization.
Tài liệu chính thức Matplotlib: Quick start guide & Artist tutorial.
Tài liệu chính thức Seaborn: Statistical data visualization.
Edward R. Tufte, The Visual Display of Quantitative Information, Graphics Press, 2001.
William S. Cleveland & Robert McGill, Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods, Journal of the American Statistical Association, 1984.
Hệ thống bài tập được chuyển thể từ học liệu mở của: Khóa học Lập trình xử lý dữ liệu (UET) theo giấy phép Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International (CC BY-NC-SA 4.0).
IAI, Lập trình xử lý dữ liệu, học liệu và notebook. Các đề thực hành đã được biên tập cách diễn đạt và bổ sung lời giải, giữ CC BY-NC-SA 4.0. Giấy phép học liệu.
Đọc hình và đối chiếu với dữ liệu
Một lệnh vẽ chạy được mới chỉ tạo ra hình. Ta còn phải kiểm tra hình có trả lời đúng câu hỏi và có cho người đọc thấy các điều kiện so sánh hay không.
Biểu đồ thanh cho số lượng theo nhóm
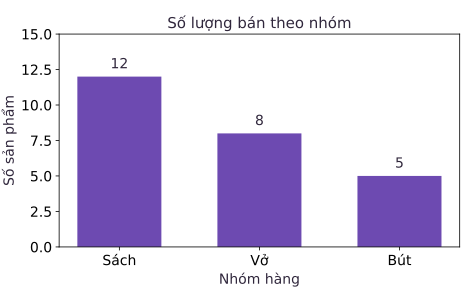
Mỗi thanh biểu diễn một nhóm hàng. Độ dài thanh tính từ mốc 0 biểu diễn số sản phẩm bán được. Thứ tự các nhóm không diễn tả thời gian, vì vậy không nối các đỉnh thanh thành một đường xu hướng.
Bài tập: Tính tỷ trọng từ số lượng
Ba nhóm Sách, Vở và Bút lần lượt bán được 12, 8 và 5 sản phẩm. Hãy tính tổng số sản phẩm và tỷ trọng của từng nhóm. Nếu chuyển biểu đồ sang tỷ trọng, nhãn trục tung phải thay đổi thế nào?
Lời giải
Tổng số sản phẩm là 25. Chia từng số lượng cho 25 rồi nhân 100, ta được 48%, 32% và 20%. Trục đo phải ghi “Tỷ trọng sản phẩm (%)” thay cho “Số sản phẩm”. Tỷ trọng này dùng tổng số sản phẩm làm mẫu số, không dùng số nhóm hàng.
python
import numpy as np
so_luong = np.array([12, 8, 5])
ty_trong = so_luong / so_luong.sum() * 100
assert so_luong.sum() == 25
np.testing.assert_allclose(ty_trong, [48, 32, 20])
Histogram đếm quan sát trong khoảng
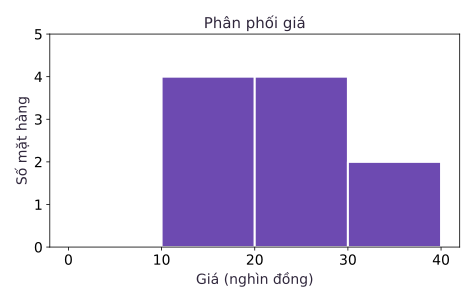
Histogram gom các giá trị số vào khoảng rồi đếm. Một cột có thể chứa nhiều giá trị khác nhau, nên không thể đọc lại từng quan sát chỉ từ hình. Trong hình này, các khoảng có cùng bề rộng và trục tung biểu diễn số mặt hàng.
Bài tập: Kiểm tra biên khoảng
Cho dãy giá [10, 12, 14, 16, 20, 20, 24, 28, 30, 36], đơn vị nghìn đồng, và các biên [0, 10, 20, 30, 40]. Hãy tính số quan sát trong từng khoảng theo quy tắc của np.histogram. Hai giá trị 20 thuộc khoảng nào?
Lời giải
Ba khoảng đầu nhận cận trái và không nhận cận phải. Khoảng cuối nhận cả cận phải. Số quan sát lần lượt là 0, 4, 4 và 2. Cả hai giá trị 20 thuộc khoảng từ 20 đến dưới 30, không thuộc khoảng từ 10 đến dưới 20.
python
gia = np.array([10, 12, 14, 16, 20, 20, 24, 28, 30, 36])
tan_so, bien = np.histogram(gia, bins=[0, 10, 20, 30, 40])
assert tan_so.tolist() == [0, 4, 4, 2]
assert tan_so.sum() == len(gia)
Thang đo làm thay đổi độ dài nhìn thấy
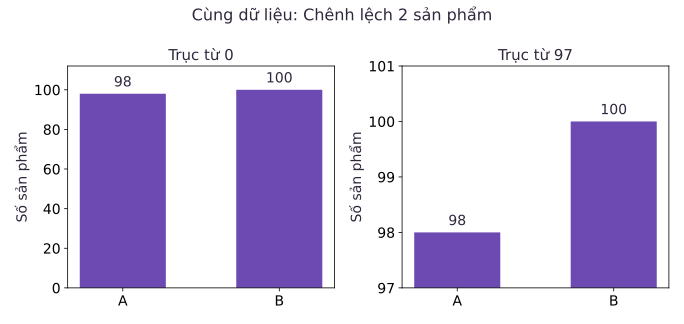
Ở hình bên trái, chiều dài thanh được đo từ 0. Ở hình bên phải, đoạn được vẽ chỉ bắt đầu từ 97. Đọc số trên trục vẫn cho đúng hai giá trị, nhưng so sánh chiều dài thanh ở hình bên phải không còn là so sánh tỷ lệ 100 với 98.
Bài tập: Phân biệt chênh lệch và tỷ lệ
Tính mức tăng từ 98 lên 100 sản phẩm theo đơn vị sản phẩm và theo phần trăm. Trong hình dùng mốc 97, hai đoạn thanh nhìn thấy có tỷ lệ chiều dài bao nhiêu? Vì sao không được dùng tỷ lệ ấy để nói số sản phẩm tăng gấp ba?
Lời giải
Mức tăng là 2 sản phẩm, tương đương khoảng 2,04% so với 98 sản phẩm ban đầu. Các đoạn thanh trong hình bên phải dài 1 và 3 đơn vị, nên tỷ lệ chiều dài là 3. Chúng biểu diễn phần vượt mốc 97, không biểu diễn toàn bộ số sản phẩm.
python
import math
assert 100 - 98 == 2
assert math.isclose((100 - 98) / 98 * 100, 2.0408163265306123)
assert (100 - 97) / (98 - 97) == 3
Boxplot và các quan sát riêng lẻ
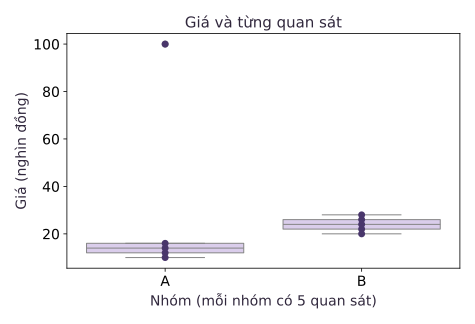
Hộp tóm tắt trung vị và hai tứ phân vị. Với quy tắc râu bằng 1,5 lần khoảng tứ phân vị, ngưỡng lý thuyết và điểm cuối râu là hai đại lượng khác nhau. Điểm cuối râu phải là một quan sát còn nằm trong ngưỡng, không phải chính ngưỡng.
Bài tập: Tính hộp, ngưỡng và râu
Nhóm A có giá [10, 12, 14, 16, 100], còn nhóm B có giá [20, 22, 24, 26, 28]. Hãy tính trung vị, tứ phân vị và ngưỡng dưới, trên của nhóm A bằng quy tắc nội suy mặc định của pandas. Râu trên của A dừng ở đâu? Có đủ căn cứ kết luận 100 là dữ liệu sai không?
Lời giải
Nhóm A có tứ phân vị thứ nhất bằng 12, trung vị bằng 14 và tứ phân vị thứ ba bằng 16. Khoảng tứ phân vị bằng 4, nên hai ngưỡng là 6 và 22. Các quan sát còn trong ngưỡng chạy từ 10 đến 16, vì vậy râu trên dừng ở 16. Giá 100 nằm ngoài râu, nhưng hình chưa cho biết đó là lỗi nhập liệu hay một trường hợp hợp lệ có giá cao.
python
import pandas as pd
nhom_a = pd.Series([10, 12, 14, 16, 100])
q1, trung_vi, q3 = nhom_a.quantile([0.25, 0.5, 0.75])
iqr = q3 - q1
duoi, tren = q1 - 1.5 * iqr, q3 + 1.5 * iqr
trong_nguong = nhom_a[nhom_a.between(duoi, tren)]
assert (q1, trung_vi, q3, iqr, duoi, tren) == (12, 14, 16, 4, 6, 22)
assert (trong_nguong.min(), trong_nguong.max()) == (10, 16)
Lab 12: Biểu đồ cho báo cáo và phương pháp kiểm định cấu trúc hình ảnh
Một hình lưu thành công vẫn có thể vẽ sai dữ liệu, thiếu đơn vị hoặc dùng trục gây hiểu nhầm. Ta sẽ tính bảng dùng để vẽ, xuất hình từ mã và kiểm lại cả số liệu lẫn cách trình bày.
1. Mục tiêu và bài toán thực tế
Xét bài toán thực tế: Một nhóm chuyên viên phân tích thị trường lưu trú du lịch cần xây dựng bộ trực quan hóa dữ liệu phục vụ báo cáo định kỳ tại vùng đô thị Santiago de Chile. Bản báo cáo phải giải quyết năm thách thức kỹ thuật cốt lõi:
- Tổng hợp chuỗi thời gian lượt đánh giá theo tháng của từng quận từ hai bảng dữ liệu liên kết, nhận diện và loại bỏ các kỳ chưa trọn vẹn để tránh đưa ra kết luận sai về xu hướng suy giảm.
- Thiết kế biểu đồ đường hoàn chỉnh với bốn thành phần chuẩn mực: Đường số liệu chính xác, tiêu đề nêu thông điệp phân tích rõ ràng, nhãn trục tung kèm đơn vị đo lường, và chú thích nguồn gốc dữ liệu minh bạch ở chân hình.
- Thống kê tỷ lệ loại phòng nguyên căn (
Entire home/apt) tại các quận đạt ngưỡng quy mô tối thiểu, chuyển đổi thành biểu đồ thanh ngang có nhãn giá trị trực tiếp trên thanh và trục hoành xuất phát từ gốc tọa độ 0. - Khám phá phân phối của chỉ số số ngày mở lịch trong năm (
availability_365) bằng biểu đồ tần suất (histogram) với số khoảng chia xác định, bóc tách hai nhóm hành vi trái ngược và làm rõ lý do số bình quân đơn lẻ không thể đại diện cho dữ liệu có phân phối hai đỉnh. - Vạch trần kỹ thuật thao túng thị giác do việc cắt ngắn trục tung gây ra, sửa lại thành biểu đồ cột trung thực và xây dựng hàm kiểm định tự động cấu trúc hình ảnh bằng thư viện kiểm thử
assert.
2. Dữ liệu thực hành và chuẩn bị môi trường
Để bảo đảm toàn bộ mã nguồn có thể thực thi độc lập và kiểm chứng ngoại tuyến (offline), bài thực hành sử dụng bộ dữ liệu mẫu giả lập chuẩn hóa được thiết kế dựa trên các quy luật thống kê của dữ liệu thực tế tại Santiago:
- Bảng chỗ ở mẫu
DEMO_DS(60 chỗ ở tại 6 quận: Santiago, Providencia, Las Condes, Ñuñoa, Lo Barnechea và Vitacura) với thông tin phân loại phòng và số ngày mở lịch. - Bảng đánh giá mẫu
DEMO_RV(1.905 lượt đánh giá từ ngày 2024-01-10 đến 2026-07-01) liên kết với bảng chỗ ở qua mã định danhlisting_id. - Thư mục lưu trữ hình ảnh
figures/được khởi tạo tự động từ mã nguồn.
python
import numpy as np
import pandas as pd
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
from pathlib import Path
from IPython.display import display

# Thiết lập hành vi Copy-on-Write an toàn cho pandas
if pd.__version__.startswith("2.") or pd.__version__.startswith("3."):
    pd.set_option("mode.copy_on_write", True)

# Địa chỉ snapshot dữ liệu thực tế tại Santiago de Chile phục vụ đối chiếu
SNAPSHOT_URL = (
    "https://data.insideairbnb.com/chile/rm/santiago/"
    "2026-06-29/visualisations/listings.csv"
)

# Mốc chụp dữ liệu chuẩn hóa của tập dữ liệu
SNAPSHOT = "2026-06-29"

# Khởi tạo thư mục chứa sản phẩm biểu đồ
Path("figures").mkdir(parents=True, exist_ok=True)

# Cấu hình phong cách đồ họa thống nhất cho toàn bộ bài thực hành
plt.rcParams["svg.fonttype"] = "path"
plt.rcParams.update(
    {
        "axes.spines.top": False,
        "axes.spines.right": False,
        "axes.grid": True,
        "grid.alpha": 0.25,
        "font.size": 11,
    }
)

# 1. Bảng chỗ ở giả lập chuẩn hóa: 60 chỗ ở tại 6 quận với chu kỳ loại phòng cố định
_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)
_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}
DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

# 2. Bảng đánh giá giả lập chuẩn hóa: 1.905 lượt đánh giá liên kết qua listing_id
_dong = []
for k, lid in enumerate(DEMO_DS["id"]):
    for ngay in pd.date_range("2024-01-10", "2026-07-01", freq=f"{20 + k % 25}D"):
        _dong.append((lid, ngay))
DEMO_RV = pd.DataFrame(_dong, columns=["listing_id", "date"])
NOTE
Đối chiếu thực tế: Khi xử lý tệp dữ liệu đầy đủ của thành phố Santiago, mốc chụp 2026-06-29 ghi nhận tổng cộng 188 tháng đánh giá tại quận Providencia với 2.810 lượt đánh giá trong tháng 06 năm 2026. Các bài tập dưới đây sử dụng dữ liệu mẫu giả lập nhằm bảo đảm khả năng tái lập và kiểm chứng ngoại tuyến hoàn toàn, tuyệt đối không suy diễn các con số này thành dữ liệu lịch sử của vùng đô thị Santiago.
3. Nội dung chi tiết bộ bài tập thực hành
Bài tập 1: Lọc dữ liệu theo quận và tổng hợp chuỗi đánh giá theo tháng
Bài tập 1: Tổng hợp chuỗi đánh giá theo tháng
Trong phân tích chuỗi thời gian của từng địa bàn, bảng đánh giá (rv) chỉ lưu mã số chỗ ở (listing_id) và ngày tháng (date), còn tên địa bàn (neighbourhood) lại nằm ở bảng chỗ ở (ds). Cần liên kết hai bảng này để lọc ra các đánh giá thuộc quận mục tiêu, đếm số lượng theo chu kỳ tháng và loại bỏ tháng cuối cùng chưa trọn vẹn.
Hãy viết hàm monthly_reviews(rv: pd.DataFrame, ds: pd.DataFrame, quan: str) -> pd.Series thực hiện các yêu cầu:
- Lấy tập hợp các mã định danh
idcủa các chỗ ở thuộc quậnquantrong bảngds. - Lọc các dòng trong bảng
rvcólisting_idthuộc tập hợp mã định danh vừa tìm được. - Chuyển đổi cột
datethành thời gian và tổng hợp số lượng đánh giá theo từng tháng bằng phương thứcresample("ME").size(). - Loại bỏ phần tử tháng cuối cùng trong chuỗi vì theo giả thiết của biến thể này, kỳ cuối chưa được quan sát đủ, tránh tạo ra ảo giác sụt giảm mạnh về số đánh giá.
- Trả về Series với là ngày cuối tháng (
DatetimeIndex) và giá trị là số lượt đánh giá nguyên dương. Đảm bảo hàm không làm thay đổi hai đầu vào.
Lời giải
Cách 1: Sử dụng tập hợp set để lọc mã và cắt lát chỉ mục cuối
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

_dong = []

for k, lid in enumerate(DEMO_DS["id"]):
    for ngay in pd.date_range("2024-01-10", "2026-07-01", freq=f"{20 + k % 25}D"):
        _dong.append((lid, ngay))

DEMO_RV = pd.DataFrame(_dong, columns=["listing_id", "date"])

# Bắt đầu lời giải

import pandas as pd


def monthly_reviews(rv: pd.DataFrame, ds: pd.DataFrame, quan: str) -> pd.Series:
    # 1. Trích xuất tập hợp các mã định danh thuộc quận mục tiêu
    tap_id = set(ds.loc[ds["neighbourhood"] == quan, "id"])

    # 2. Lọc các đánh giá có mã chỗ ở thuộc tập hợp trên
    rv_quan = rv[rv["listing_id"].isin(tap_id)]

    # 3. Đặt cột date làm chỉ mục và gom nhóm theo ngày cuối tháng
    thang = rv_quan.set_index("date").resample("ME").size()

    # 4. Loại bỏ tháng cuối cùng chưa trọn vẹn bằng cú pháp cắt lát
    return thang.iloc[:-1]


# Gọi thực nghiệm hàm với dữ liệu mẫu:
thang_pro_c1 = monthly_reviews(DEMO_RV, DEMO_DS, "Providencia")
display(
    f"Số tháng hợp lệ: {len(thang_pro_c1)}, tháng cuối: {thang_pro_c1.index[-1]:%Y-%m-%d}, số lượt: {thang_pro_c1.iloc[-1]}"
)

# Kết thúc lời giải
Giải thích cách 1
Lấy tập ID chỗ ở thuộc quận rồi lọc review theo isin. resample("ME").size() đếm theo tháng và giữ các tháng nằm giữa hai đầu chuỗi. Bài này yêu cầu bỏ phần tử cuối theo giả thiết kỳ cuối chưa trọn. Không dùng thao tác đó cho mọi tập dữ liệu nếu chưa kiểm mốc quan sát.
Kết quả cách 1
| Kết quả |
|---|
| Số tháng hợp lệ: 30, tháng cuối: 2026-06-30, số lượt: 15 |
Cách 2: Sử dụng chuỗi phương thức kết hợp phép lọc boolean trên chỉ mục
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

_dong = []

for k, lid in enumerate(DEMO_DS["id"]):
    for ngay in pd.date_range("2024-01-10", "2026-07-01", freq=f"{20 + k % 25}D"):
        _dong.append((lid, ngay))

DEMO_RV = pd.DataFrame(_dong, columns=["listing_id", "date"])

# Bắt đầu lời giải

import pandas as pd


def monthly_reviews(rv: pd.DataFrame, ds: pd.DataFrame, quan: str) -> pd.Series:
    # Lọc mã chỗ ở và nối chuỗi phương thức resample để tối ưu bộ nhớ
    danh_sach_id = ds.loc[ds["neighbourhood"] == quan, "id"].to_numpy()
    chuoi_thang = (
        rv.loc[rv["listing_id"].isin(danh_sach_id)]
        .set_index("date")
        .resample("ME")
        .size()
    )
    # Loại bỏ kỳ cuối cùng nếu chuỗi có từ hai mốc thời gian trở lên
    if len(chuoi_thang) >= 2:
        return chuoi_thang.iloc[:-1]
    return chuoi_thang


# Gọi thực nghiệm hàm với dữ liệu mẫu:
thang_pro_c2 = monthly_reviews(DEMO_RV, DEMO_DS, "Providencia")
display(
    f"Cách 2: Tổng số đánh giá = {thang_pro_c2.sum()}, độ dài chuỗi = {len(thang_pro_c2)}"
)

# Kết thúc lời giải
Giải thích cách 2
Chuỗi phương thức gắn các bước lọc, đặt và tổng hợp trong một biểu thức. Mã quận được xác định từ bảng chỗ ở, không lấy từ vị trí dòng của review. Cách đếm vẫn là số đánh giá, không phải số đánh giá hoặc doanh thu của quận.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Tổng số đánh giá = 391, độ dài chuỗi = 30 |
So sánh cách dùng
Cách 1 mở rõ bước lọc quận, tổng hợp tháng và bỏ kỳ cuối theo yêu cầu đã cho. Cách 2 gom việc lọc và tổng hợp thành chuỗi phương thức. Khi thay dữ liệu, vẫn phải đối chiếu snapshot thay vì mặc nhiên coi mọi tháng còn lại đều trọn vẹn.
Bài tập 2: Kiểm soát mốc chụp dữ liệu và nhận diện kỳ chưa trọn
Bài tập 2: Lọc theo mốc chụp dữ liệu
Khi cập nhật dữ liệu từ các đợt phát hành định kỳ (snapshot releases), nhiều bản ghi có thể chứa ngày đánh giá rơi vào sau ngày công bố mốc chụp do độ trễ đồng bộ hệ thống, hoặc bản thân ngày chụp rơi vào giữa kỳ báo cáo (Ví dụ: Ngày 29 tháng 6 khiến tháng 6 thiếu 1 ngày). Cần xây dựng cơ chế kiểm soát mốc chụp tường minh để bảo đảm dữ liệu đưa vào biểu đồ hoàn toàn nhất quán.
Hãy viết hàm monthly_reviews_with_cutoff(rv: pd.DataFrame, ds: pd.DataFrame, quan: str, snapshot: str = "2026-06-29") -> pd.Series thực hiện:
- Lọc bảng
rvchỉ giữ các dòng códatenhỏ hơn hoặc bằng mốc thời giansnapshot. - Lọc các chỗ ở thuộc quận
quanvà tổng hợp theo tháng bằngresample("ME").size(). - Kiểm tra xem mốc
snapshotcó trùng với ngày cuối tháng hay không. Nếusnapshotrơi vào trước ngày cuối tháng của tháng đó, tháng đó chưa hoàn chỉnh và bắt buộc phải loại bỏ khỏi chuỗi báo cáo. - Trả về Series chuỗi tháng đã chuẩn hóa và không chứa kỳ cụt.
Lời giải
Cách 1: So sánh điều kiện boolean và kiểm tra ngày kết thúc tháng
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

_dong = []

for k, lid in enumerate(DEMO_DS["id"]):
    for ngay in pd.date_range("2024-01-10", "2026-07-01", freq=f"{20 + k % 25}D"):
        _dong.append((lid, ngay))

DEMO_RV = pd.DataFrame(_dong, columns=["listing_id", "date"])

# Bắt đầu lời giải

import pandas as pd


def monthly_reviews_with_cutoff(
    rv: pd.DataFrame, ds: pd.DataFrame, quan: str, snapshot: str = "2026-06-29"
) -> pd.Series:
    snap_dt = pd.Timestamp(snapshot)
    tap_id = set(ds.loc[ds["neighbourhood"] == quan, "id"])

    # 1. Lọc bản ghi nằm trong mốc chụp và thuộc địa bàn yêu cầu
    dieu_kien = (rv["listing_id"].isin(tap_id)) & (rv["date"] <= snap_dt)
    rv_hop_le = rv.loc[dieu_kien]

    # 2. Gom nhóm theo tháng
    thang = rv_hop_le.set_index("date").resample("ME").size()

    # 3. Kiểm tra xem mốc chụp có rơi vào trước ngày cuối tháng cuối cùng không
    if len(thang) > 0 and snap_dt < thang.index[-1]:
        return thang.iloc[:-1]
    return thang


# Gọi thực nghiệm hàm với dữ liệu mẫu:
thang_cutoff_c1 = monthly_reviews_with_cutoff(
    DEMO_RV, DEMO_DS, "Providencia", "2026-06-29"
)
display(
    f"Mốc cắt 2026-06-29: Số tháng = {len(thang_cutoff_c1)}, tháng cuối = {thang_cutoff_c1.index[-1]:%Y-%m-%d}"
)

# Kết thúc lời giải
Giải thích cách 1
Lọc ngày theo snapshot trước khi tổng hợp. So sánh mốc quan sát với ngày cuối tháng để quyết định kỳ nào đã đầy đủ. Một ngày có sự kiện cuối cùng không tự xác định thời điểm dữ liệu đã quan sát đến đâu.
Kết quả cách 1
| Kết quả |
|---|
| Mốc cắt 2026-06-29: Số tháng = 29, tháng cuối = 2026-05-31 |
Cách 2: Sử dụng cắt lát chỉ mục thời gian và offset MonthEnd
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

_dong = []

for k, lid in enumerate(DEMO_DS["id"]):
    for ngay in pd.date_range("2024-01-10", "2026-07-01", freq=f"{20 + k % 25}D"):
        _dong.append((lid, ngay))

DEMO_RV = pd.DataFrame(_dong, columns=["listing_id", "date"])

# Bắt đầu lời giải

import pandas as pd


def monthly_reviews_with_cutoff(
    rv: pd.DataFrame, ds: pd.DataFrame, quan: str, snapshot: str = "2026-06-29"
) -> pd.Series:
    snap_dt = pd.Timestamp(snapshot)
    danh_sach_id = ds.loc[ds["neighbourhood"] == quan, "id"].to_numpy()

    # Cắt lát chuỗi thời gian trực tiếp trên bảng đánh giá đã sắp xếp
    rv_loc = (
        rv.loc[rv["listing_id"].isin(danh_sach_id)]
        .sort_values("date")
        .set_index("date")
        .loc[:snap_dt]
    )
    thang = rv_loc.resample("ME").size()

    # Xác định ngày cuối tháng trọn vẹn gần nhất
    ngay_cuoi_thang_chuan = (
        snap_dt - pd.offsets.MonthEnd(1)
        if snap_dt < (snap_dt + pd.offsets.MonthEnd(0))
        else snap_dt
    )
    return thang.loc[:ngay_cuoi_thang_chuan]


# Gọi thực nghiệm hàm với dữ liệu mẫu:
thang_cutoff_c2 = monthly_reviews_with_cutoff(
    DEMO_RV, DEMO_DS, "Providencia", "2026-06-29"
)
display(
    f"Cách 2: Tháng cuối trọn vẹn = {thang_cutoff_c2.index[-1]:%Y-%m-%d}, số lượt = {thang_cutoff_c2.iloc[-1]}"
)

# Kết thúc lời giải
Giải thích cách 2
Đặt quy tắc giữ kỳ thành mặt nạ riêng giúp kiểm rõ cận thời gian. Hai cách phải cùng quy ước về ngày kết thúc, đặc biệt khi snapshot đúng ngày cuối tháng. Nếu ngày có giờ, cần xác định mốc là đầu ngày hay hết ngày thay vì so sánh ngầm theo nửa đêm.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Tháng cuối trọn vẹn = 2026-05-31, số lượt = 9 |
So sánh cách dùng
Cách 1 đặt bước kiểm tra snapshot gần thao tác tổng hợp để dễ đối chiếu mốc thời gian. Cách 2 làm rõ việc giữ các tháng đã hoàn tất. Chọn cách trình bày nào cũng phải phân biệt tháng chưa đủ ngày với tháng có số đánh giá thấp.
Bài tập 3: Dựng biểu đồ đường hoàn chỉnh cho chuỗi thời gian
Bài tập 3: Dựng biểu đồ đường đạt chuẩn xuất bản
Biểu đồ cần vẽ đúng chuỗi số liệu, có nhãn đơn vị và thông tin nguồn. Tiêu đề nêu một điều người đọc có thể kiểm ngay trên hình.
Hãy viết hàm plot_line(thang: pd.Series, path: str) -> matplotlib.axes.Axes thực hiện các yêu cầu:
- Khởi tạo khung hình mới bằng giao diện hướng đối tượng
fig, ax = plt.subplots(figsize=(9, 3.5)). - Vẽ một đường duy nhất thể hiện diễn biến của
thangqua các mốc thời gian bằngax.plot(thang.index, thang.values). - Đặt tiêu đề cho biểu đồ nêu bật thông điệp phân tích (độ dài tiêu đề tối thiểu 15 ký tự).
- Thiết lập nhãn trục tung có ghi rõ đơn vị tính (
Lượt đánh giá (lượt/tháng)). - Ghi chú thích nguồn số liệu ở góc dưới khung hình bằng phương thức
fig.text(...)với nội dung không rỗng. - Lưu tệp hình ảnh vào đường dẫn
pathvới độ phân giảidpi=150, tùy chọnbbox_inches="tight"và trả về đối tượngax.
Lời giải
Cách 1: Thiết lập từng thuộc tính qua giao diện hướng đối tượng cơ bản
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

_dong = []

for k, lid in enumerate(DEMO_DS["id"]):
    for ngay in pd.date_range("2024-01-10", "2026-07-01", freq=f"{20 + k % 25}D"):
        _dong.append((lid, ngay))

DEMO_RV = pd.DataFrame(_dong, columns=["listing_id", "date"])


def monthly_reviews(rv: pd.DataFrame, ds: pd.DataFrame, quan: str) -> pd.Series:
    # 1. Trích xuất tập hợp các mã định danh thuộc quận mục tiêu
    tap_id = set(ds.loc[ds["neighbourhood"] == quan, "id"])

    # 2. Lọc các đánh giá có mã chỗ ở thuộc tập hợp trên
    rv_quan = rv[rv["listing_id"].isin(tap_id)]

    # 3. Đặt cột date làm chỉ mục và gom nhóm theo ngày cuối tháng
    thang = rv_quan.set_index("date").resample("ME").size()

    # 4. Loại bỏ tháng cuối cùng chưa trọn vẹn bằng cú pháp cắt lát
    return thang.iloc[:-1]


thang_pro_c1 = monthly_reviews(DEMO_RV, DEMO_DS, "Providencia")

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import matplotlib.pyplot as plt


def plot_line(thang: pd.Series, path: str):
    # 1. Khởi tạo khung hình với kích thước chuẩn tỷ lệ ngang
    fig, ax = plt.subplots(figsize=(9, 3.5))

    # 2. Vẽ đường chuỗi thời gian
    ax.plot(
        thang.index,
        thang.values,
        color="#1976d2",
        linewidth=2,
        marker="o",
        markersize=3,
    )

    # 3. Đặt tiêu đề nêu thông điệp phân tích cụ thể
    ax.set_title(
        "Diễn biến số lượt đánh giá theo tháng tại quận Providencia (2024–2026)", pad=12
    )

    # 4. Gán nhãn trục tung kèm đơn vị đo lường
    ax.set_ylabel("Lượt đánh giá (lượt/tháng)")
    ax.set_xlabel("Thời gian ghi nhận")

    # 5. Chú thích nguồn gốc dữ liệu ở chân hình
    fig.text(
        0.12,
        -0.02,
        "Nguồn: Dữ liệu Inside Airbnb Santiago (mẫu giả lập chuẩn hóa 2024–2026)",
        fontsize=9,
        color="#555555",
    )

    # 6. Lưu tệp hình ảnh và trả về đối tượng Axes
    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ax_line_c1 = plot_line(thang_pro_c1, "figures/providencia_thang_c1.png")
display(
    f"Đã lưu biểu đồ: Tiêu đề = '{ax_line_c1.get_title()}', nhãn y = '{ax_line_c1.get_ylabel()}'"
)

# Kết thúc lời giải
Giải thích cách 1
subplots tạo Figure chứa Axes mới, rồi plot dùng tháng làm trục ngang và số đếm làm trục dọc. Ghi nhãn đơn vị và phạm vi dữ liệu để người đọc hiểu mỗi điểm. savefig ghi chính Figure này, tránh lưu nhầm hình đang hoạt động khác.
Kết quả cách 1
| Kết quả |
|---|
| Đã lưu biểu đồ: Tiêu đề = 'Diễn biến số lượt đánh giá theo tháng tại quận Providencia (2024–2026)', nhãn y = 'Lượt đánh giá (lượt/tháng)' |
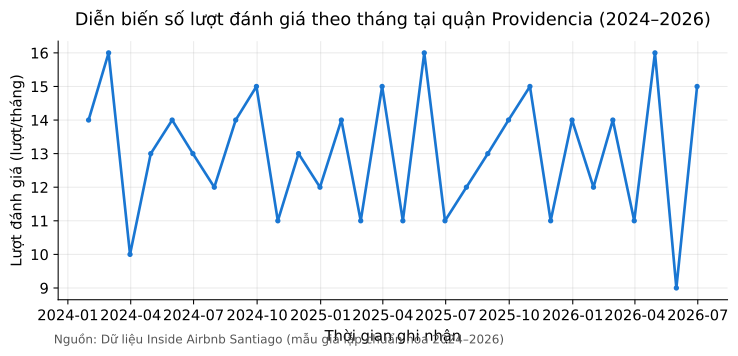
Cách 2: Tối ưu hóa lưới gióng và định dạng hiển thị ngày tháng
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

_dong = []

for k, lid in enumerate(DEMO_DS["id"]):
    for ngay in pd.date_range("2024-01-10", "2026-07-01", freq=f"{20 + k % 25}D"):
        _dong.append((lid, ngay))

DEMO_RV = pd.DataFrame(_dong, columns=["listing_id", "date"])


def monthly_reviews(rv: pd.DataFrame, ds: pd.DataFrame, quan: str) -> pd.Series:
    # 1. Trích xuất tập hợp các mã định danh thuộc quận mục tiêu
    tap_id = set(ds.loc[ds["neighbourhood"] == quan, "id"])

    # 2. Lọc các đánh giá có mã chỗ ở thuộc tập hợp trên
    rv_quan = rv[rv["listing_id"].isin(tap_id)]

    # 3. Đặt cột date làm chỉ mục và gom nhóm theo ngày cuối tháng
    thang = rv_quan.set_index("date").resample("ME").size()

    # 4. Loại bỏ tháng cuối cùng chưa trọn vẹn bằng cú pháp cắt lát
    return thang.iloc[:-1]


thang_pro_c1 = monthly_reviews(DEMO_RV, DEMO_DS, "Providencia")

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import matplotlib.pyplot as plt
import matplotlib.dates as mdates


def plot_line(thang: pd.Series, path: str):
    fig, ax = plt.subplots(figsize=(9, 3.5))

    # Vẽ đường với kiểu nét thanh thoát và điểm nút trực quan
    ax.plot(
        thang.index,
        thang.values,
        color="#0d47a1",
        linewidth=1.8,
        marker="s",
        markersize=3.5,
        label="Số lượt đánh giá",
    )

    # Tinh chỉnh định dạng trục thời gian hiển thị tháng/năm
    ax.xaxis.set_major_formatter(mdates.DateFormatter("%m/%Y"))
    ax.xaxis.set_major_locator(mdates.MonthLocator(interval=4))

    ax.set_title(
        "Số lượt đánh giá theo tháng tại quận Providencia duy trì đà tăng trưởng",
        pad=12,
    )
    ax.set_ylabel("Số lượt đánh giá (lượt/tháng)")
    ax.set_xlabel("Thời gian ghi nhận")

    # Gắn chú thích nguồn ở góc trái dưới
    fig.text(
        0.12,
        -0.03,
        "Nguồn: Inside Airbnb Santiago, dữ liệu chuẩn hóa phục vụ phân tích",
        fontsize=9,
        color="#424242",
    )

    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ax_line_c2 = plot_line(thang_pro_c1, "figures/providencia_thang_c2.png")
display(f"Cách 2: Đã lưu biểu đồ với {len(ax_line_c2.lines)} đường số liệu")

# Kết thúc lời giải
Giải thích cách 2
Gom thiết lập nhãn, nguồn và lưu hình trong một hàm giúp tạo lại biểu đồ theo cùng quy tắc. bbox_inches="tight" thu khung theo nội dung, còn dpi ảnh hưởng bản raster. Tiêu đề phải được dữ liệu hỗ trợ, không dùng câu quảng cáo để làm đường biến động có vẻ mạnh hơn.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Đã lưu biểu đồ với 1 đường số liệu |
So sánh cách dùng
Bạn nên chọn Cách 1 khi vẽ nhanh đồ thị đường đơn giản để khảo sát xu hướng chuỗi thời gian trong quá trình khám phá. Cách 2 cần thiết khi muốn chuẩn hóa lưới trục, nhãn ngày tháng và đóng gói hàm vẽ nhằm xuất hình ảnh sắc nét cho báo cáo.
Bài tập 4: Thống kê số lượng chỗ ở và tỷ lệ loại phòng nguyên căn theo quận
Bài tập 4: Lập bảng tỷ lệ phân loại phòng
Để so sánh cơ cấu thị trường lưu trú giữa các địa bàn, cần tính toán tỷ lệ chỗ ở thuộc loại căn hộ hoặc nhà nguyên căn (Entire home/apt). Các quận có quy mô quá nhỏ (quá ít chỗ ở) thường có phương sai lớn và gây nhiễu cho biểu đồ, vì vậy cần áp dụng ngưỡng lọc quy mô min_n và sắp xếp tỷ lệ tăng dần để sẵn sàng cho biểu đồ thanh ngang.
Hãy viết hàm share_entire(ds: pd.DataFrame, min_n: int = 300) -> pd.DataFrame thực hiện:
- Nhóm dữ liệu theo cột quận
neighbourhood. - Tính hai chỉ số cho mỗi quận:
n: Số lượng chỗ ở thuộc quận (tương đương kích thước nhóm).pct: Tỷ lệ chỗ ở córoom_type == "Entire home/apt"trên thang đo từđến (trung bình của điều kiện boolean).
- Lọc bỏ các quận có quy mô
n < min_n. - Sắp xếp các quận còn lại theo giá trị
pcttăng dần. - Trả về có là tên quận và đúng hai cột
["n", "pct"]. Tuyệt đối không thêm cột phụ làm biến đổi DataFramedsban đầu.
Lời giải
Cách 1: Sử dụng groupby với hàm tổng hợp tùy biến tường minh
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

# Bắt đầu lời giải

import pandas as pd


def share_entire(ds: pd.DataFrame, min_n: int = 300) -> pd.DataFrame:
    # 1. Gom nhóm và tính toán độc lập số lượng và tỷ lệ nguyên căn
    tk = ds.groupby("neighbourhood").agg(
        n=("id", "size"),
        pct=("room_type", lambda cot: (cot == "Entire home/apt").mean()),
    )

    # 2. Lọc theo ngưỡng số lượng tối thiểu và sắp xếp tăng dần theo tỷ lệ
    tk_loc = tk.loc[tk["n"] >= min_n].sort_values("pct", ascending=True)
    return tk_loc


# Gọi thực nghiệm hàm với dữ liệu mẫu (ngưỡng min_n = 5):
tk_nguyen_can_c1 = share_entire(DEMO_DS, min_n=5)
display(tk_nguyen_can_c1)

# Kết thúc lời giải
Giải thích cách 1
Nhóm theo quận rồi tính số dòng và tỷ lệ room_type == "Entire home/apt". Lọc n >= min_n sau khi tổng hợp để ngưỡng áp dụng cho quy mô quận. Tỷ lệ ở thang 0–1, nên 0,8 tương ứng 80%, không phải 0,8%.
Kết quả cách 1
| neighbourhood | n | pct |
|---|---|---|
| Ñuñoa | 8 | 0.5 |
| Santiago | 20 | 0.65 |
| Providencia | 12 | 0.75 |
| Las Condes | 10 | 0.8 |
| Lo Barnechea | 6 | 1 |
Cách 2: Sử dụng phép gán tạm thời không biến đổi dữ liệu nguồn
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

# Bắt đầu lời giải

import pandas as pd


def share_entire(ds: pd.DataFrame, min_n: int = 300) -> pd.DataFrame:
    # Sử dụng assign trên bản sao để tính toán vector hóa nhanh chóng
    tk = (
        ds.assign(la_nguyen_can=ds["room_type"] == "Entire home/apt")
        .groupby("neighbourhood")
        .agg(n=("id", "size"), pct=("la_nguyen_can", "mean"))
    )
    return tk.loc[tk["n"] >= min_n].sort_values("pct")


# Gọi thực nghiệm hàm với dữ liệu mẫu:
tk_nguyen_can_c2 = share_entire(DEMO_DS, min_n=5)
display(
    f"Cách 2: Quận dẫn đầu tỷ lệ nguyên căn là {tk_nguyen_can_c2.index[-1]} ({tk_nguyen_can_c2['pct'].max():.1%})"
)

# Kết thúc lời giải
Giải thích cách 2
Tạo cột boolean rồi dùng named aggregation giúp tên n và pct đi cùng định nghĩa của chúng. Sắp tỷ lệ tăng dần là thứ tự dữ liệu cho biểu đồ thanh ngang tiếp theo. Mẫu số cần giữ đúng số dòng trong quận, kể cả khi một kiểu phòng không xuất hiện.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Quận dẫn đầu tỷ lệ nguyên căn là Lo Barnechea (100.0%) |
So sánh cách dùng
Hãy chọn Cách 1 khi bạn cần viết hàm tổng hợp tùy biến để trực tiếp kiểm soát công thức tính tỷ lệ trên từng nhóm dữ liệu. Cách 2 thuận tiện hơn khi muốn dùng named aggregation để đặt tên cột rõ ràng và sắp xếp sẵn thứ tự cho biểu đồ thanh.
Bài tập 5: Dựng biểu đồ thanh ngang có nhãn tỷ lệ phần trăm và gốc tọa độ chuẩn
Bài tập 5: Dựng biểu đồ thanh ngang chuẩn mực
Biểu đồ thanh ngang cho phép giữ tên quận dễ đọc. Trong bài này, trục bắt đầu từ 0 và mỗi thanh có nhãn giá trị để đối chiếu trực tiếp với bảng.
Hãy viết hàm plot_share_barh(tk: pd.DataFrame, path: str) -> matplotlib.axes.Axes thực hiện:
- Nhận bảng thống kê
tktừ Bài tập 4 và đường dẫn tệp lưu trữpath. - Khởi tạo khung hình
fig, ax = plt.subplots(figsize=(7, 4)). - Vẽ các thanh ngang bằng
ax.barhtheo đúng thứ tự dòng củatk, với chiều dài thanh làpct * 100(thang phần trăm %). - Gắn nhãn giá trị trực tiếp trên mỗi thanh bằng phương thức
ax.bar_label(..., fmt="%.0f%%"). - Thiết lập trục hoành bắt buộc bắt đầu từ 0 (
ax.set_xlim(left=0)), nhãn trục hoành có đơn vị%. - Tiêu đề nêu thông điệp phân tích rõ ràng (độ dài tối thiểu 15 ký tự).
- Lưu tệp hình ảnh vào
pathvà trả về đối tượngax.
Lời giải
Cách 1: Sử dụng barh cơ bản và bar_label tự động
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)


def share_entire(ds: pd.DataFrame, min_n: int = 300) -> pd.DataFrame:
    # 1. Gom nhóm và tính toán độc lập số lượng và tỷ lệ nguyên căn
    tk = ds.groupby("neighbourhood").agg(
        n=("id", "size"),
        pct=("room_type", lambda cot: (cot == "Entire home/apt").mean()),
    )

    # 2. Lọc theo ngưỡng số lượng tối thiểu và sắp xếp tăng dần theo tỷ lệ
    tk_loc = tk.loc[tk["n"] >= min_n].sort_values("pct", ascending=True)
    return tk_loc


tk_nguyen_can_c1 = share_entire(DEMO_DS, min_n=5)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import matplotlib.pyplot as plt


def plot_share_barh(tk: pd.DataFrame, path: str):
    # 1. Khởi tạo khung hình
    fig, ax = plt.subplots(figsize=(7, 4))

    # 2. Vẽ thanh ngang với độ dài thang đo phần trăm
    thanh = ax.barh(tk.index, tk["pct"] * 100, color="#2b5c8f", height=0.65)

    # 3. Gắn nhãn giá trị trực tiếp trên từng thanh
    ax.bar_label(thanh, fmt="%.0f%%", padding=4, fontsize=10)

    # 4. Bắt buộc trục hoành xuất phát từ 0 và mở rộng khoảng đệm bên phải
    ax.set_xlim(left=0, right=115)
    ax.set_xlabel("Tỷ lệ phòng nguyên căn (%)")

    # 5. Tiêu đề phản ánh thông điệp phân tích
    ax.set_title("Tỷ lệ phòng nguyên căn tại các quận có từ 5 chỗ ở trở lên", pad=12)

    # 6. Lưu tệp hình ảnh
    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ax_barh_c1 = plot_share_barh(tk_nguyen_can_c1, "figures/pct_nguyen_can_c1.png")
display(
    f"Đã lưu biểu đồ thanh ngang: Số thanh = {len(ax_barh_c1.patches)}, giới hạn trục x = {ax_barh_c1.get_xlim()}"
)

# Kết thúc lời giải
Giải thích cách 1
barh tạo một thanh cho mỗi quận theo thứ tự bảng. Nhân tỷ lệ với 100 trước khi gắn nhãn phần trăm. Trục phải bắt đầu từ 0 để độ dài thanh phản ánh tỷ lệ, còn nhãn giá trị cho phép đọc con số mà không cần đo bằng mắt.
Kết quả cách 1
| Kết quả |
|---|
| Đã lưu biểu đồ thanh ngang: Số thanh = 5, giới hạn trục x = (np.float64(0.0), np.float64(115.0)) |
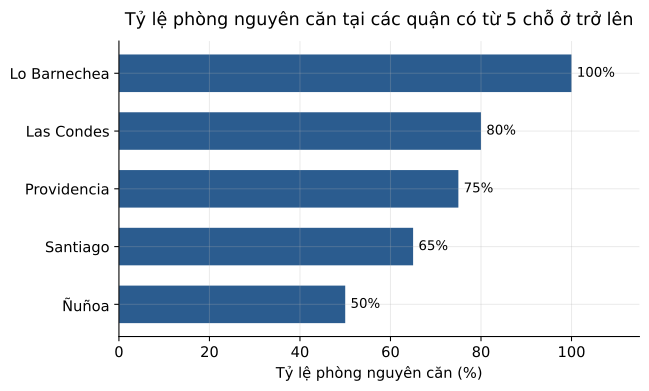
Cách 2: Tùy biến màu sắc phân cấp và định dạng lề nhãn chữ
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)


def share_entire(ds: pd.DataFrame, min_n: int = 300) -> pd.DataFrame:
    # 1. Gom nhóm và tính toán độc lập số lượng và tỷ lệ nguyên căn
    tk = ds.groupby("neighbourhood").agg(
        n=("id", "size"),
        pct=("room_type", lambda cot: (cot == "Entire home/apt").mean()),
    )

    # 2. Lọc theo ngưỡng số lượng tối thiểu và sắp xếp tăng dần theo tỷ lệ
    tk_loc = tk.loc[tk["n"] >= min_n].sort_values("pct", ascending=True)
    return tk_loc


tk_nguyen_can_c1 = share_entire(DEMO_DS, min_n=5)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import matplotlib.pyplot as plt


def plot_share_barh(tk: pd.DataFrame, path: str):
    fig, ax = plt.subplots(figsize=(7, 4))

    # Phân cấp màu sắc nổi bật cho quận có tỷ lệ cao nhất
    mau_sac = ["#4a7bb0" if p < tk["pct"].max() else "#1a4971" for p in tk["pct"]]
    thanh = ax.barh(tk.index, tk["pct"] * 100, color=mau_sac, height=0.6)

    ax.bar_label(thanh, fmt="%.1f%%", padding=5, color="#111111", weight="bold")
    ax.set_xlim(0, 115)
    ax.set_xlabel("Tỷ lệ phòng nguyên căn (%)")
    ax.set_title("Cơ cấu loại phòng nguyên căn phân hóa mạnh giữa các địa bàn", pad=12)

    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ax_barh_c2 = plot_share_barh(tk_nguyen_can_c1, "figures/pct_nguyen_can_c2.png")
display(f"Cách 2: Đã lưu biểu đồ với {len(ax_barh_c2.texts)} nhãn giá trị số liệu")

# Kết thúc lời giải
Giải thích cách 2
Thiết lập nhãn và lưu hình trong cùng hàm giữ biểu đồ tái lập. bar_label đặt chuỗi lên từng thanh theo đúng container trả về. Nếu nhãn sát mép, mở thêm khoảng trống trong giới hạn trục thay vì cắt chữ hoặc giảm tỷ lệ chữ quá nhỏ.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Đã lưu biểu đồ với 5 nhãn giá trị số liệu |
So sánh cách dùng
Bạn nên chọn Cách 1 khi muốn tạo nhanh biểu đồ thanh ngang với thang đo bắt đầu từ 0 để so sánh trung thực các nhóm. Cách 2 thích hợp khi cần trau chuốt đồ thị để xuất bản, phân tầng màu sắc nhấn mạnh và căn chỉnh lề để nhãn không bị tràn.
Bài tập 6: Dựng biểu đồ tần suất số ngày mở lịch và trích xuất hai nhóm hành vi
Bài tập 6: Dựng histogram và nhận diện phân phối hai đỉnh
Chỉ số availability_365 đại diện cho số ngày một chỗ ở mở lịch cho phép đặt phòng trong vòng 365 ngày tới. Phân phối của biến số này thường có dạng hai đỉnh (bimodal) rất đặc thù, tập trung dày đặc ở hai cực: Các chỗ ở khóa lịch hoàn toàn (0 ngày) và các chỗ ở mở lịch gần như quanh năm (
Hãy viết hàm plot_availability(avail: pd.Series, path: str, bins: int = 40) -> dict thực hiện:
- Loại bỏ các giá trị khuyết (
NaN) trong Seriesavail. - Khởi tạo khung hình và vẽ biểu đồ tần suất bằng
ax.hist(..., bins=bins). - Đặt tiêu đề nêu rõ hiện tượng phân cực quan sát được (độ dài tối thiểu 15 ký tự).
- Lưu tệp hình ảnh vào đường dẫn
path. - Đếm số lượng chỗ ở có đúng 0 ngày mở lịch (
so_khoa) và số lượng chỗ ở có từ 360 ngày mở lịch trở lên (so_mo_quanh_nam). - Trả về từ điển gồm đúng ba khóa:
"ax"(đối tượng Axes),"so_khoa"(kiểu số nguyên int), và"so_mo_quanh_nam"(kiểu số nguyên int).
Lời giải
Cách 1: Sử dụng dropna và đếm bằng phép so sánh boolean trực tiếp
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import pandas as pd
import matplotlib.pyplot as plt


def plot_availability(avail: pd.Series, path: str, bins: int = 40) -> dict:
    # 1. Loại bỏ ô khuyết để tránh cảnh báo phân tích
    du_lieu = avail.dropna()

    # 2. Khởi tạo khung hình và vẽ biểu đồ tần suất
    fig, ax = plt.subplots(figsize=(8, 3.5))
    ax.hist(du_lieu, bins=bins, color="#0288d1", edgecolor="white", linewidth=0.5)

    # 3. Đặt tiêu đề và các nhãn trục
    ax.set_title(
        "Phân phối số ngày mở lịch trong năm tới: Tập trung tại hai cực", pad=12
    )
    ax.set_xlabel("Số ngày mở lịch trong năm (ngày)")
    ax.set_ylabel("Số lượng chỗ ở")

    # 4. Lưu tệp hình ảnh
    fig.savefig(path, dpi=150, bbox_inches="tight")

    # 5. Đếm số lượng hai nhóm hành vi đặc thù
    so_khoa = int((du_lieu == 0).sum())
    so_mo_quanh_nam = int((du_lieu >= 360).sum())

    return {
        "ax": ax,
        "so_khoa": so_khoa,
        "so_mo_quanh_nam": so_mo_quanh_nam,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_hist_c1 = plot_availability(
    DEMO_DS["availability_365"], "figures/availability_hist_c1.png", bins=40
)
display(
    f"Kết quả: {kq_hist_c1['so_khoa']} chỗ ở khóa lịch, {kq_hist_c1['so_mo_quanh_nam']} chỗ ở mở gần quanh năm"
)

# Kết thúc lời giải
Giải thích cách 1
Bỏ ô thiếu trước khi đưa availability_365 vào histogram. bins quyết định cách chia khoảng, còn tổng tần suất phải bằng số giá trị hợp lệ. Đếm riêng giá trị 0 và từ 360 trở lên theo đúng cận của đề.
Kết quả cách 1
| Kết quả |
|---|
| Kết quả: 7 chỗ ở khóa lịch, 13 chỗ ở mở gần quanh năm |
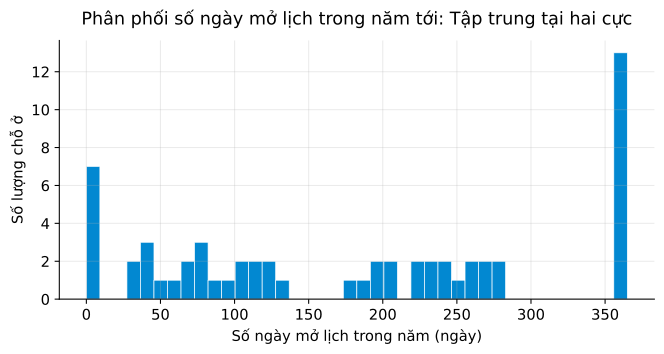
Cách 2: Xác định ranh giới khoảng chia tường minh bằng NumPy
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


def plot_availability(avail: pd.Series, path: str, bins: int = 40) -> dict:
    mang_du_lieu = avail.dropna().to_numpy()

    fig, ax = plt.subplots(figsize=(8, 3.5))
    # Tạo lưới ranh giới khoảng chia đều từ 0 đến 365
    ranh_gioi_bin = np.linspace(0, 365, bins + 1)
    ax.hist(
        mang_du_lieu,
        bins=ranh_gioi_bin,
        color="#0097a7",
        edgecolor="#ffffff",
        linewidth=0.5,
    )

    ax.set_title(
        "Phân phối hai đỉnh của số ngày mở lịch phản ánh hai nhóm vận hành", pad=12
    )
    ax.set_xlabel("Số ngày mở lịch trong năm (ngày)")
    ax.set_ylabel("Số lượng chỗ ở")

    fig.savefig(path, dpi=150, bbox_inches="tight")

    # Đếm nhanh bằng np.count_nonzero
    so_khoa = int(np.count_nonzero(mang_du_lieu == 0))
    so_mo_quanh_nam = int(np.count_nonzero(mang_du_lieu >= 360))

    return {
        "ax": ax,
        "so_khoa": so_khoa,
        "so_mo_quanh_nam": so_mo_quanh_nam,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_hist_c2 = plot_availability(
    DEMO_DS["availability_365"], "figures/availability_hist_c2.png", bins=40
)
display(f"Cách 2: Số thanh trên biểu đồ = {len(kq_hist_c2['ax'].patches)}")

# Kết thúc lời giải
Giải thích cách 2
Hàm trả cả Axes và hai số đếm giúp kiểm đối chiếu hình với bảng. Hai cụm trong histogram mô tả phân bố số ngày mở lịch của dữ liệu, không tự cho biết ý định chủ nhà hoặc số ngày thực sự có khách. Phải xem cả lựa chọn khoảng chia trước khi kết luận hình có hai đỉnh.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Số thanh trên biểu đồ = 40 |
So sánh cách dùng
Cách 1 thuận tiện để dựng histogram và kiểm tổng tần suất trên số quan sát hợp lệ. Cách 2 trả thêm số đếm tại hai vùng biên cùng đối tượng Axes để đối chiếu bảng với hình. Cách chia khoảng vẫn phải được giữ rõ trong báo cáo.
Bài tập 7: Phân tích phân phối hai đỉnh và rủi ro khi chỉ dựa vào số bình quân
Bài tập 7: Phân tích bản chất phân phối hai đỉnh
Khi dữ liệu có phân phối hai đỉnh (bimodal distribution), các số đo tóm tắt truyền thống như giá trị trung bình cộng (mean) hoặc trung vị (median) thường rơi vào khoảng giữa, nơi hầu như không có quan sát thực tế nào tồn tại. Hơn nữa, việc hiểu sai bản chất của availability_365 có thể dẫn đến những kết luận sai lệch về thị trường.
Hãy viết hàm analyze_bimodal_distribution(avail: pd.Series) -> dict tính toán các chỉ số phân tích định lượng:
- Giá trị trung bình (
mean) và trung vị (median) của chuỗi dữ liệu. - Tỷ lệ phần trăm chỗ ở thuộc nhóm khóa lịch hoàn toàn (
ngày). - Tỷ lệ phần trăm chỗ ở thuộc nhóm mở lịch quanh năm (
ngày). - Tỷ lệ phần trăm chỗ ở nằm ở khoảng giữa (
). - Giải thích bản chất vì sao không thể suy diễn tỷ lệ lấp đầy phòng hoặc hành vi đặt phòng của khách chỉ dựa trên chỉ số
availability_365.
Lời giải
Cách 1: Sử dụng các phương thức thống kê mô tả cơ bản của pandas
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

# Bắt đầu lời giải

import pandas as pd


def analyze_bimodal_distribution(avail: pd.Series) -> dict:
    s = avail.dropna()
    n = len(s)

    # 1. Tính toán số đo trung tâm
    trung_binh = float(s.mean())
    trung_vi = float(s.median())

    # 2. Phân tách ba phân khúc hành vi
    so_khoa = int((s == 0).sum())
    so_mo_quanh_nam = int((s >= 360).sum())
    so_giua = int(((s > 0) & (s < 360)).sum())

    return {
        "mean": round(trung_binh, 2),
        "median": round(trung_vi, 2),
        "pct_khoa": round(so_khoa / n * 100, 2),
        "pct_mo_quanh_nam": round(so_mo_quanh_nam / n * 100, 2),
        "pct_giua": round(so_giua / n * 100, 2),
        "so_khoa": so_khoa,
        "so_mo_quanh_nam": so_mo_quanh_nam,
        "so_giua": so_giua,
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_bimodal_c1 = analyze_bimodal_distribution(DEMO_DS["availability_365"])
display(kq_bimodal_c1)

# Kết thúc lời giải
Giải thích cách 1
Chia các giá trị theo điều kiện mở lịch đã nêu rồi đếm từng nhóm. Giữ số ô thiếu riêng để người đọc biết phần dữ liệu chưa vào phép tính. Những khoảng chọn để tóm tắt cần được ghi rõ, không được đổi ngưỡng cho phù hợp một câu chuyện có sẵn.
Kết quả cách 1
| Trường | Kết quả |
|---|---|
| mean | 180.57 |
| median | 191 |
| pct_khoa | 11.67 |
| pct_mo_quanh_nam | 21.67 |
| pct_giua | 66.67 |
| so_khoa | 7 |
| so_mo_quanh_nam | 13 |
| so_giua | 40 |
Cách 2: Sử dụng phân khoảng pd.cut để tổng hợp tần suất nhóm
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

# Bắt đầu lời giải

import pandas as pd


def analyze_bimodal_distribution(avail: pd.Series) -> dict:
    s = avail.dropna()
    n = len(s)

    # Phân nhóm bằng các mốc biên xác định
    nhom = pd.cut(s, bins=[-1, 0, 359, 365], labels=["khoa", "giua", "mo_quanh_nam"])
    dem = nhom.value_counts()

    return {
        "mean": round(float(s.mean()), 2),
        "median": round(float(s.median()), 2),
        "pct_khoa": round(dem["khoa"] / n * 100, 2),
        "pct_mo_quanh_nam": round(dem["mo_quanh_nam"] / n * 100, 2),
        "pct_giua": round(dem["giua"] / n * 100, 2),
        "so_khoa": int(dem["khoa"]),
        "so_mo_quanh_nam": int(dem["mo_quanh_nam"]),
        "so_giua": int(dem["giua"]),
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_bimodal_c2 = analyze_bimodal_distribution(DEMO_DS["availability_365"])
display(
    f"Cách 2: Tỷ lệ hai cực = {kq_bimodal_c2['pct_khoa']}% khóa lịch và {kq_bimodal_c2['pct_mo_quanh_nam']}% mở quanh năm"
)

# Kết thúc lời giải
Giải thích cách 2
Các mặt nạ theo cột giúp kiểm lại từng cận dưới và cận trên. Báo số lượng và tỷ trọng với cùng mẫu số thay vì chỉ gọi một nhóm là áp đảo. Lịch đóng có thể do đã đặt, chủ nhà khóa ngày hoặc thiếu cập nhật, nên không đồng nhất với công suất phòng.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Tỷ lệ hai cực = 11.67% khóa lịch và 21.67% mở quanh năm |
So sánh cách dùng
Cách 1 mở từng điều kiện chia nhóm và giữ số ô thiếu riêng. Cách 2 trình bày các nhóm bằng mặt nạ cột để đối chiếu số lượng với tỷ trọng. Khi chọn cách làm, cần giữ nguyên các cận và mẫu số, không đổi ngưỡng giữa hai lời giải.
Bài tập 8: Nhận diện biểu đồ gây hiểu sai và đo lường hệ số phóng đại thị giác
Bài tập 8: Đo lường sự sai lệch khi cắt ngắn trục tung
Một thủ thuật trình bày trực quan thường bị lạm dụng trong các báo cáo thiếu trung thực là cắt ngắn trục tung (truncated vertical axis). Bằng cách thiết lập giới hạn dưới của trục
Hãy viết hàm visual_distortion_factor(data: pd.Series, y_min: float, y_max: float) -> dict tính toán: Đặt
- Tỷ số giá trị thực tế giữa nhóm cao nhất và nhóm thấp nhất:
- Chiều cao thị giác hiển thị của cột trên biểu đồ:
- Tỷ số chiều cao trực quan trên biểu đồ:
- Hệ số phóng đại sai lệch thị giác (Visual Distortion Factor):
- Thử nghiệm với chuỗi tỷ lệ ba quận
Santiago(), Providencia(), Las Condes() khi bị cắt ngắn với và .
Lời giải
Cách 1: Tính toán tuần tự từ giá trị cực đại và cực tiểu của Series
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

# Bắt đầu lời giải

import pandas as pd


def visual_distortion_factor(data: pd.Series, y_min: float, y_max: float) -> dict:
    v_min = float(data.min())
    v_max = float(data.max())

    # 1. Tính tỷ số thực tế giữa giá trị cao nhất và thấp nhất
    r_thuc = v_max / v_min

    # 2. Tính chiều cao trực quan của hai cột trên khung vẽ
    h_min = v_min - y_min
    h_max = v_max - y_min

    # 3. Tính tỷ số thị giác và hệ số phóng đại
    r_thi_giac = h_max / h_min
    he_so = r_thi_giac / r_thuc

    return {
        "v_min": v_min,
        "v_max": v_max,
        "r_thuc": round(r_thuc, 3),
        "r_thi_giac": round(r_thi_giac, 3),
        "he_so": round(he_so, 3),
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
dulieu_sosanh = pd.Series(
    [65.0, 75.0, 80.0], index=["Santiago", "Providencia", "Las Condes"]
)
kq_dist_c1 = visual_distortion_factor(dulieu_sosanh, y_min=60.0, y_max=85.0)
display(kq_dist_c1)

# Kết thúc lời giải
Giải thích cách 1
Tính phần trục còn lại sau khi cắt và so với toàn thang đo. Một chênh lệch số học giữ nguyên có thể chiếm tỷ lệ chiều cao lớn hơn trên hình bị cắt. Cần nêu cả giới hạn trục và giá trị dữ liệu để người đọc đối chiếu được.
Kết quả cách 1
| Trường | Kết quả |
|---|---|
| v_min | 65 |
| v_max | 80 |
| r_thuc | 1.231 |
| r_thi_giac | 4 |
| he_so | 3.25 |
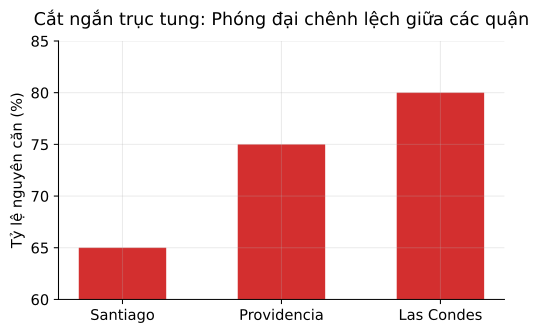
Cách 2: Đóng gói công thức vector hóa an toàn kiểm tra điều kiện biên
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

dulieu_sosanh = pd.Series(
    [65.0, 75.0, 80.0], index=["Santiago", "Providencia", "Las Condes"]
)

# Bắt đầu lời giải

import pandas as pd


def visual_distortion_factor(data: pd.Series, y_min: float, y_max: float) -> dict:
    vals = data.to_numpy()
    v_min, v_max = float(vals.min()), float(vals.max())

    # Kiểm tra tính hợp lệ của biên cắt trục tung
    if y_min >= v_min:
        raise ValueError(
            "Giới hạn dưới y_min phải nhỏ hơn giá trị nhỏ nhất của dữ liệu."
        )

    r_thuc = v_max / v_min
    r_thi_giac = (v_max - y_min) / (v_min - y_min)
    he_so = r_thi_giac / r_thuc

    return {
        "v_min": v_min,
        "v_max": v_max,
        "r_thuc": round(r_thuc, 3),
        "r_thi_giac": round(r_thi_giac, 3),
        "he_so": round(he_so, 3),
    }


# Gọi thực nghiệm hàm với dữ liệu mẫu:
kq_dist_c2 = visual_distortion_factor(dulieu_sosanh, y_min=60.0, y_max=85.0)
display(f"Cách 2: Hệ số phóng đại thị giác = {kq_dist_c2['he_so']} lần")

# Kết thúc lời giải
Giải thích cách 2
Đóng phép tính vào hàm giúp thử các mốc cắt khác nhau mà giữ dữ liệu. Kiểm giới hạn trục hợp lệ trước khi chia. Hệ số phóng đại hình ảnh mô tả cách trình bày, không phải mức tăng tương đối thật giữa hai nhóm.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Hệ số phóng đại thị giác = 3.25 lần |
So sánh cách dùng
Hãy chọn Cách 1 khi muốn minh họa từng bước cơ chế bóp méo thị giác do cắt trục tung trên một ví dụ cụ thể để giảng giải. Cách 2 phù hợp khi cần xây dựng hàm kiểm định tự động có kiểm tra điều kiện biên cho nhiều bộ số liệu.
Bài tập 9: Sửa biểu đồ cột thành biểu đồ trung thực có gốc tọa độ chuẩn
Bài tập 9: Vẽ lại biểu đồ trung thực
Để khôi phục tính trung thực khoa học của số liệu, biểu đồ cột so sánh giữa các quận phải được vẽ lại với trục tung xuất phát từ đúng gốc tọa độ 0. Tiêu đề biểu đồ cũng cần được viết lại bằng văn phong khách quan, trung thực, phản ánh đúng tương quan giữa các địa bàn mà không dùng các từ ngữ giật gân, định kiến.
Hãy viết hàm plot_honest_bars(pct: pd.Series, path: str) -> matplotlib.axes.Axes thực hiện:
- Nhận Series tỷ lệ %
pct( là tên quận) và đường dẫn tệppath. - Khởi tạo khung hình
fig, ax = plt.subplots(figsize=(6, 3.5)). - Vẽ biểu đồ cột đứng
ax.barcho từng quận theo đúng thứ tự củapct. - Bắt buộc thiết lập trục tung bắt đầu từ gốc 0 (
ax.set_ylim(bottom=0)). - Đặt tiêu đề phản ánh đúng mức độ chênh lệch thực tế (độ dài tối thiểu 15 ký tự).
- Lưu tệp hình ảnh vào
pathvà trả về đối tượngax. - Thảo luận các trường hợp ngoại lệ hiếm hoi được phép không bắt đầu trục từ 0.
Lời giải
Cách 1: Thiết lập trục tung bắt đầu từ 0 và tiêu đề khách quan
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

dulieu_sosanh = pd.Series(
    [65.0, 75.0, 80.0], index=["Santiago", "Providencia", "Las Condes"]
)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import matplotlib.pyplot as plt


def plot_honest_bars(pct: pd.Series, path: str):
    # 1. Khởi tạo khung hình
    fig, ax = plt.subplots(figsize=(6, 3.5))

    # 2. Vẽ các cột đứng
    thanh = ax.bar(pct.index, pct.values, color="#388e3c", width=0.55)

    # 3. Gắn nhãn giá trị trên đầu cột
    ax.bar_label(thanh, fmt="%.0f%%", padding=3, fontsize=10)

    # 4. Trục tung bắt buộc bắt đầu từ 0
    ax.set_ylim(bottom=0, top=100)
    ax.set_ylabel("Tỷ lệ nguyên căn (%)")

    # 5. Tiêu đề phản ánh tương quan khách quan
    ax.set_title(
        "Trục tung xuất phát từ 0: Phản ánh trung thực tương quan tỷ lệ", pad=12
    )

    # 6. Lưu tệp hình ảnh
    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ax_honest_c1 = plot_honest_bars(dulieu_sosanh, "figures/honest_bars_c1.png")
display(
    f"Đã lưu biểu đồ trung thực: Giới hạn trục y = {ax_honest_c1.get_ylim()}, số cột = {len(ax_honest_c1.patches)}"
)

# Kết thúc lời giải
Giải thích cách 1
Vẽ lại cùng giá trị và cùng thứ tự nhóm trên trục bắt đầu từ 0. Giữ nhãn phần trăm hoặc đơn vị ban đầu để việc so sánh không đổi đại lượng. Hình sửa cần cho thấy chênh lệch thật mà không thêm kết luận về nguyên nhân.
Kết quả cách 1
| Kết quả |
|---|
| Đã lưu biểu đồ trung thực: Giới hạn trục y = (np.float64(0.0), np.float64(100.0)), số cột = 3 |
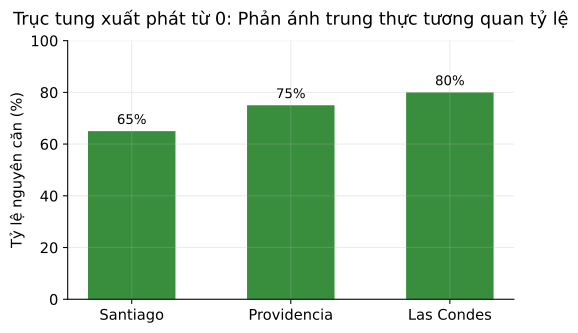
Cách 2: Tùy biến giới hạn trên trục tung theo tỷ lệ 100% kèm nhãn số
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

dulieu_sosanh = pd.Series(
    [65.0, 75.0, 80.0], index=["Santiago", "Providencia", "Las Condes"]
)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import matplotlib.pyplot as plt


def plot_honest_bars(pct: pd.Series, path: str):
    fig, ax = plt.subplots(figsize=(6, 3.5))

    cot = ax.bar(
        pct.index,
        pct.values,
        color="#2e7d32",
        width=0.5,
        edgecolor="#1b5e20",
        linewidth=0.8,
    )
    ax.bar_label(cot, fmt="%.1f%%", padding=4, weight="bold")

    # Thiết lập thang đo đầy đủ 0-100% của đại lượng tỷ lệ
    ax.set_ylim(0, 105)
    ax.set_ylabel("Tỷ lệ phòng nguyên căn (%)")
    ax.set_title(
        "Tỷ lệ phòng nguyên căn giữa các quận có sự tương đồng đáng kể", pad=12
    )

    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


# Gọi thực nghiệm hàm với dữ liệu mẫu:
ax_honest_c2 = plot_honest_bars(dulieu_sosanh, "figures/honest_bars_c2.png")
display(f"Cách 2: Đã lưu biểu đồ với tiêu đề: '{ax_honest_c2.get_title()}'")

# Kết thúc lời giải
Giải thích cách 2
Tạo Figure mới rồi đặt giới hạn, nhãn và lưu tệp trong hàm giúp tránh phụ thuộc hình đã vẽ trước. So sánh chiều cao cột với Series đầu vào bằng mã. Không chỉ kiểm rằng có ảnh được xuất ra, vì một ảnh lưu thành công vẫn có thể dùng sai dữ liệu hoặc sai thang đo.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Đã lưu biểu đồ với tiêu đề: 'Tỷ lệ phòng nguyên căn giữa các quận có sự tương đồng đáng kể' |
So sánh cách dùng
Bạn nên chọn Cách 1 khi cần sửa nhanh biểu đồ thanh về gốc 0 để loại bỏ ấn tượng sai lệch cho người xem. Cách 2 phù hợp khi đại lượng là tỷ lệ phần trăm cần thang chuẩn 100% và đòi hỏi nhãn số chi tiết để kiểm chứng dữ liệu.
Bài tập 10: Tự động hóa kiểm tra cấu trúc biểu đồ bằng hệ thống khẳng định
Bài tập 10: Kiểm định chất lượng biểu đồ tự động
Trong quy trình kỹ thuật dữ liệu tự động (CI/CD visual pipeline), ta không thể dùng mắt người để duyệt qua hàng trăm hình ảnh được sinh ra mỗi ngày. Cần xây dựng một hàm kiểm định chất lượng biểu đồ bằng mã nguồn (visual quality assurance) dựa trên các thuộc tính của đối tượng matplotlib.axes.Axes và hệ thống tệp lưu trữ.
Hãy viết hàm validate_chart_structure(ax: matplotlib.axes.Axes, min_title_len: int = 15, require_ylabel: bool = False, require_xlabel: bool = False, require_zero_x: bool = False, require_zero_y: bool = False, min_patches: int = 0, min_lines: int = 0, saved_path: str = None) -> dict thực hiện:
- Kiểm tra tiêu đề tồn tại và có độ dài tối thiểu
min_title_len. - Kiểm tra nhãn trục tung (
ylabel) và nhãn trục hoành (xlabel) không được rỗng nếu có yêu cầu. - Kiểm tra gốc tọa độ trục hoành
ax.get_xlim()[0] == 0(đối với biểu đồ thanh ngang) hoặc trục tungax.get_ylim()[0] == 0(đối với biểu đồ cột đứng). - Kiểm tra số lượng đối tượng hình học: Số lượng thanh
len(ax.patches) >= min_patchesvà số lượng đườnglen(ax.lines) >= min_lines. - Kiểm tra tệp hình ảnh tại đường dẫn
saved_pathđã được tạo thành công trên đĩa và có dung lượng lớn hơn 0 byte. - Trả về từ điển trạng thái chi tiết của từng tiêu chí và cờ tổng hợp
all_passed: bool.
Lời giải
Cách 1: Kiểm tra tuần tự từng tiêu chí bằng toán tử logic
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

import matplotlib.pyplot as plt

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)


def share_entire(ds: pd.DataFrame, min_n: int = 300) -> pd.DataFrame:
    # 1. Gom nhóm và tính toán độc lập số lượng và tỷ lệ nguyên căn
    tk = ds.groupby("neighbourhood").agg(
        n=("id", "size"),
        pct=("room_type", lambda cot: (cot == "Entire home/apt").mean()),
    )

    # 2. Lọc theo ngưỡng số lượng tối thiểu và sắp xếp tăng dần theo tỷ lệ
    tk_loc = tk.loc[tk["n"] >= min_n].sort_values("pct", ascending=True)
    return tk_loc


tk_nguyen_can_c1 = share_entire(DEMO_DS, min_n=5)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)


def plot_share_barh(tk: pd.DataFrame, path: str):
    # 1. Khởi tạo khung hình
    fig, ax = plt.subplots(figsize=(7, 4))

    # 2. Vẽ thanh ngang với độ dài thang đo phần trăm
    thanh = ax.barh(tk.index, tk["pct"] * 100, color="#2b5c8f", height=0.65)

    # 3. Gắn nhãn giá trị trực tiếp trên từng thanh
    ax.bar_label(thanh, fmt="%.0f%%", padding=4, fontsize=10)

    # 4. Bắt buộc trục hoành xuất phát từ 0 và mở rộng khoảng đệm bên phải
    ax.set_xlim(left=0, right=115)
    ax.set_xlabel("Tỷ lệ phòng nguyên căn (%)")

    # 5. Tiêu đề phản ánh thông điệp phân tích
    ax.set_title("Tỷ lệ phòng nguyên căn tại các quận có từ 5 chỗ ở trở lên", pad=12)

    # 6. Lưu tệp hình ảnh
    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


ax_barh_c1 = plot_share_barh(tk_nguyen_can_c1, "figures/share-reference.png")

# Bắt đầu lời giải

from pathlib import Path
import matplotlib.axes


def validate_chart_structure(
    ax: matplotlib.axes.Axes,
    min_title_len: int = 15,
    require_ylabel: bool = False,
    require_xlabel: bool = False,
    require_zero_x: bool = False,
    require_zero_y: bool = False,
    min_patches: int = 0,
    min_lines: int = 0,
    saved_path: str = None,
) -> dict:
    # 1. Kiểm tra độ dài tiêu đề
    tieu_de = ax.get_title().strip()
    dat_tieu_de = len(tieu_de) >= min_title_len

    # 2. Kiểm tra nhãn các trục tọa độ
    dat_nhan_y = not require_ylabel or bool(ax.get_ylabel().strip())
    dat_nhan_x = not require_xlabel or bool(ax.get_xlabel().strip())

    # 3. Kiểm tra gốc tọa độ bắt đầu từ 0
    dat_goc_x = not require_zero_x or (ax.get_xlim()[0] == 0)
    dat_goc_y = not require_zero_y or (ax.get_ylim()[0] == 0)

    # 4. Kiểm tra số lượng đối tượng hình học trên đồ thị
    dat_patches = len(ax.patches) >= min_patches
    dat_lines = len(ax.lines) >= min_lines

    # 5. Kiểm tra tệp hình ảnh đã được ghi xuống đĩa
    dat_tep = True
    if saved_path:
        tep = Path(saved_path)
        dat_tep = tep.exists() and tep.stat().st_size > 0

    tat_ca_dat = all(
        [
            dat_tieu_de,
            dat_nhan_y,
            dat_nhan_x,
            dat_goc_x,
            dat_goc_y,
            dat_patches,
            dat_lines,
            dat_tep,
        ]
    )

    return {
        "has_title": dat_tieu_de,
        "has_ylabel": dat_nhan_y,
        "has_xlabel": dat_nhan_x,
        "has_zero_x": dat_goc_x,
        "has_zero_y": dat_goc_y,
        "has_patches": dat_patches,
        "has_lines": dat_lines,
        "has_file": dat_tep,
        "all_passed": tat_ca_dat,
    }


# Gọi thực nghiệm hàm kiểm tra biểu đồ thanh ngang Bài 5:
kiem_tra_c1 = validate_chart_structure(
    ax_barh_c1,
    min_title_len=15,
    require_xlabel=True,
    require_zero_x=True,
    min_patches=5,
    saved_path="figures/pct_nguyen_can_c1.png",
)
display(kiem_tra_c1)

# Kết thúc lời giải
Giải thích cách 1
Đọc lại cấu trúc Axes để kiểm tiêu đề, nhãn, số đường hoặc thanh và giới hạn trục. Các assert kiểm những điều quan sát được trong hình, như số điểm và giá trị đã vẽ. Chúng không đánh giá thay người đọc về sự đúng mức của thông điệp.
Kết quả cách 1
| Trường | Kết quả |
|---|---|
| has_title | True |
| has_ylabel | True |
| has_xlabel | True |
| has_zero_x | True |
| has_zero_y | True |
| has_patches | True |
| has_lines | True |
| has_file | True |
Cách 2: Xây dựng bộ quy tắc kiểm định mở rộng theo dạng từ điển kiểm tra
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

import matplotlib.pyplot as plt

dulieu_sosanh = pd.Series(
    [65.0, 75.0, 80.0], index=["Santiago", "Providencia", "Las Condes"]
)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)


def plot_honest_bars(pct: pd.Series, path: str):
    # 1. Khởi tạo khung hình
    fig, ax = plt.subplots(figsize=(6, 3.5))

    # 2. Vẽ các cột đứng
    thanh = ax.bar(pct.index, pct.values, color="#388e3c", width=0.55)

    # 3. Gắn nhãn giá trị trên đầu cột
    ax.bar_label(thanh, fmt="%.0f%%", padding=3, fontsize=10)

    # 4. Trục tung bắt buộc bắt đầu từ 0
    ax.set_ylim(bottom=0, top=100)
    ax.set_ylabel("Tỷ lệ nguyên căn (%)")

    # 5. Tiêu đề phản ánh tương quan khách quan
    ax.set_title(
        "Trục tung xuất phát từ 0: Phản ánh trung thực tương quan tỷ lệ", pad=12
    )

    # 6. Lưu tệp hình ảnh
    fig.savefig(path, dpi=150, bbox_inches="tight")
    return ax


ax_honest_c1 = plot_honest_bars(dulieu_sosanh, "figures/honest-reference.png")

# Bắt đầu lời giải

from pathlib import Path
import matplotlib.axes


def validate_chart_structure(
    ax: matplotlib.axes.Axes,
    min_title_len: int = 15,
    require_ylabel: bool = False,
    require_xlabel: bool = False,
    require_zero_x: bool = False,
    require_zero_y: bool = False,
    min_patches: int = 0,
    min_lines: int = 0,
    saved_path: str = None,
) -> dict:
    ket_qua = {
        "has_title": len(ax.get_title().strip()) >= min_title_len,
        "has_ylabel": not require_ylabel or bool(ax.get_ylabel().strip()),
        "has_xlabel": not require_xlabel or bool(ax.get_xlabel().strip()),
        "has_zero_x": not require_zero_x or (round(ax.get_xlim()[0], 5) == 0.0),
        "has_zero_y": not require_zero_y or (round(ax.get_ylim()[0], 5) == 0.0),
        "has_patches": len(ax.patches) >= min_patches,
        "has_lines": len(ax.lines) >= min_lines,
        "has_file": (
            bool(
                saved_path
                and Path(saved_path).is_file()
                and Path(saved_path).stat().st_size > 0
            )
            if saved_path
            else True
        ),
    }
    ket_qua["all_passed"] = all(ket_qua.values())
    return ket_qua


# Gọi thực nghiệm hàm kiểm tra biểu đồ cột trung thực Bài 9:
kiem_tra_c2 = validate_chart_structure(
    ax_honest_c1,
    min_title_len=15,
    require_ylabel=True,
    require_zero_y=True,
    min_patches=3,
    saved_path="figures/honest_bars_c1.png",
)
display(f"Cách 2: Trạng thái kiểm định toàn diện = {kiem_tra_c2['all_passed']}")

# Kết thúc lời giải
Giải thích cách 2
Đóng các điều kiện thành hàm kiểm giúp dùng lại cho nhiều hình. Điều kiện cần phù hợp từng loại biểu đồ, vì trục log hoặc biểu đồ đường có quy ước khác biểu đồ thanh. Kiểm tự động cấu trúc phải đi cùng xem hình để phát hiện chữ bị cắt, màu khó phân biệt hoặc nguồn ghi sai.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Trạng thái kiểm định toàn diện = True |
So sánh cách dùng
Hãy chọn Cách 1 khi viết kiểm thử đơn vị cho một đồ thị cụ thể để xác minh nhanh cấu trúc của các trục. Cách 2 cần thiết khi muốn xây dựng bộ quy tắc kiểm định tái sử dụng nhằm tự động hóa đánh giá chất lượng nhiều biểu đồ.
Bài tập 11: So sánh phân phối giữa các nhóm trên biểu đồ ghép cùng thang đo
Bài tập 11: Dựng biểu đồ ghép cùng thang đo
Khi so sánh phân phối của một đại lượng (như số ngày mở lịch availability_365) giữa hai địa bàn khác nhau (Ví dụ: Quận Providencia và quận Santiago), sai lầm phổ biến là vẽ hai biểu đồ độc lập với thang đo trục tung tự động co giãn riêng biệt. Khi đó, một cột cao ở biểu đồ quận nhỏ có thể chỉ chứa 5 chỗ ở nhưng lại trông đồ sộ ngang với cột chứa 20 chỗ ở của quận lớn, gây hiểu sai lệch hoàn toàn về quy mô. Cần sử dụng kỹ thuật biểu đồ con ghép đôi với tham số chia sẻ trục tung (sharey=True).
Hãy viết hàm plot_comparative_groups(ds: pd.DataFrame, quan_a: str, quan_b: str, path: str, bins: int = 20) -> tuple thực hiện:
- Trích xuất Series
availability_365không chứaNaNcủa quậnquan_avà quậnquan_b. - Khởi tạo khung hình gồm hai biểu đồ con nằm cạnh nhau với trục tung dùng chung:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 3.5), sharey=True). - Vẽ histogram cho
quan_atrênax1và choquan_btrênax2với cùng số lượng khoảng chiabins. - Đặt tiêu đề riêng cho từng biểu đồ con ghi rõ tên quận và số lượng quan sát
. - Đặt tiêu đề chung cho toàn bộ khung hình bằng
fig.suptitle(...). - Lưu tệp hình ảnh vào
pathvà trả về bộ(fig, (ax1, ax2)).
Lời giải
Cách 1: Sử dụng subplots với tham số sharey và vẽ độc lập từng trục
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import pandas as pd
import matplotlib.pyplot as plt


def plot_comparative_groups(
    ds: pd.DataFrame, quan_a: str, quan_b: str, path: str, bins: int = 20
) -> tuple:
    # 1. Trích xuất dữ liệu của hai địa bàn khảo sát
    avail_a = ds.loc[ds["neighbourhood"] == quan_a, "availability_365"].dropna()
    avail_b = ds.loc[ds["neighbourhood"] == quan_b, "availability_365"].dropna()

    # 2. Khởi tạo biểu đồ ghép đôi chia sẻ trục tung
    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 3.5), sharey=True)

    # 3. Vẽ phân phối cho quận A
    ax1.hist(avail_a, bins=bins, color="#1976d2", edgecolor="white", linewidth=0.5)
    ax1.set_title(f"Quận {quan_a} (N = {len(avail_a)})", fontsize=11)
    ax1.set_xlabel("Số ngày mở lịch (ngày)")
    ax1.set_ylabel("Số lượng chỗ ở")

    # 4. Vẽ phân phối cho quận B với cùng thang đo trục tung
    ax2.hist(avail_b, bins=bins, color="#f57c00", edgecolor="white", linewidth=0.5)
    ax2.set_title(f"Quận {quan_b} (N = {len(avail_b)})", fontsize=11)
    ax2.set_xlabel("Số ngày mở lịch (ngày)")

    # 5. Tiêu đề tổng quát cho toàn bộ khung so sánh
    fig.suptitle(
        "So sánh phân phối số ngày mở lịch trên cùng thang đo trục tung",
        y=1.02,
        fontsize=12,
    )

    # 6. Lưu tệp hình ảnh
    fig.savefig(path, dpi=150, bbox_inches="tight")
    return fig, (ax1, ax2)


# Gọi thực nghiệm hàm với dữ liệu mẫu:
fig_comp_c1, (ax_pro_c1, ax_san_c1) = plot_comparative_groups(
    DEMO_DS, "Providencia", "Santiago", "figures/comparative_groups_c1.png", bins=20
)
display(f"Đã lưu biểu đồ ghép đôi: Cùng giới hạn trục y = {ax_pro_c1.get_ylim()}")

# Kết thúc lời giải
Giải thích cách 1
Đưa các nhóm lên những khung hình có cùng thang đo để chiều cao và độ dài so sánh được. Nếu từng khung tự chọn giới hạn, một biến động nhỏ có thể trông lớn như biến động ở nhóm khác. Giữ tên nhóm và đơn vị ở vị trí dễ đọc.
Kết quả cách 1
| Kết quả |
|---|
| Đã lưu biểu đồ ghép đôi: Cùng giới hạn trục y = (np.float64(0.0), np.float64(4.2)) |
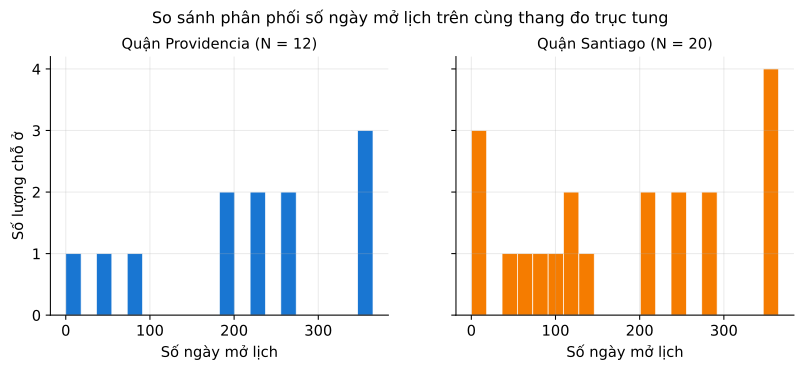
Cách 2: Tự động hóa tính toán khoảng chia dùng chung và đồng bộ đường gióng
python
# Dữ liệu mẫu và các hàm hỗ trợ

from IPython.display import display

import pandas as pd

_QUAN = (
    ["Santiago"] * 20
    + ["Providencia"] * 12
    + ["Las Condes"] * 10
    + ["Ñuñoa"] * 8
    + ["Lo Barnechea"] * 6
    + ["Vitacura"] * 4
)

_CHU_KY_PHONG_RIENG = {
    "Santiago": 3,
    "Providencia": 4,
    "Las Condes": 5,
    "Ñuñoa": 2,
    "Lo Barnechea": 0,
    "Vitacura": 4,
}

DEMO_DS = pd.DataFrame(
    {
        "id": list(range(101, 161)),
        "neighbourhood": _QUAN,
        "room_type": [
            (
                "Private room"
                if _CHU_KY_PHONG_RIENG[q] and k % _CHU_KY_PHONG_RIENG[q] == 1
                else "Entire home/apt"
            )
            for k, q in enumerate(_QUAN)
        ],
        "availability_365": [
            0 if k % 9 == 0 else 365 if k % 4 == 0 else (k * 37) % 300 + 20
            for k in range(60)
        ],
    }
)

from pathlib import Path

Path("figures").mkdir(parents=True, exist_ok=True)

# Bắt đầu lời giải

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


def plot_comparative_groups(
    ds: pd.DataFrame, quan_a: str, quan_b: str, path: str, bins: int = 20
) -> tuple:
    s_a = ds.loc[ds["neighbourhood"] == quan_a, "availability_365"].dropna()
    s_b = ds.loc[ds["neighbourhood"] == quan_b, "availability_365"].dropna()

    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 3.5), sharey=True)
    lưới_chia = np.linspace(0, 365, bins + 1)

    ax1.hist(s_a, bins=lưới_chia, color="#1565c0", edgecolor="#ffffff", linewidth=0.6)
    ax1.set_title(f"Địa bàn {quan_a} (N = {len(s_a)})", fontsize=11)
    ax1.set_xlabel("Số ngày mở lịch (ngày)")
    ax1.set_ylabel("Số lượng chỗ ở")

    ax2.hist(s_b, bins=lưới_chia, color="#e65100", edgecolor="#ffffff", linewidth=0.6)
    ax2.set_title(f"Địa bàn {quan_b} (N = {len(s_b)})", fontsize=11)
    ax2.set_xlabel("Số ngày mở lịch (ngày)")

    fig.suptitle(
        "Phân tích so sánh phân phối số ngày mở lịch giữa hai quận", y=1.02, fontsize=12
    )
    fig.savefig(path, dpi=150, bbox_inches="tight")
    return fig, (ax1, ax2)


# Gọi thực nghiệm hàm với dữ liệu mẫu:
fig_comp_c2, (ax_pro_c2, ax_san_c2) = plot_comparative_groups(
    DEMO_DS, "Providencia", "Santiago", "figures/comparative_groups_c2.png", bins=20
)
display(f"Cách 2: Giới hạn trục y dùng chung = {ax_pro_c2.get_ylim()}")

# Kết thúc lời giải
Giải thích cách 2
Dùng subplots và các tùy chọn chia sẻ trục giúp thống nhất giới hạn một cách tường minh. Mã vẫn cần kiểm dữ liệu của từng nhóm và thứ tự kỳ. Khi đơn vị hai đại lượng khác nhau, không ép chúng vào cùng thang rồi diễn giải như cùng độ lớn.
Kết quả cách 2
| Kết quả |
|---|
| Cách 2: Giới hạn trục y dùng chung = (np.float64(0.0), np.float64(4.2)) |
So sánh cách dùng
Cả hai cách dùng sharey=True để giữ cùng thang tần suất. Cách 2 còn dùng chung lưới khoảng từ 0 đến 365 ngày, giúp một khoảng ngày mang cùng ý nghĩa ở cả hai hình. Chọn cách này khi cần đối chiếu trực tiếp hình dạng hai phân phối.
4. Tổng kết quy tắc thực hành trực quan hóa dữ liệu
| Nguyên tắc kỹ thuật | Quy chuẩn chuẩn mực | Lỗi thường gặp cần tránh | Hậu quả nếu vi phạm |
|---|---|---|---|
| Gốc tọa độ biểu đồ thanh/cột | Bắt buộc xuất phát từ 0 (xlim[0] == 0 hoặc ylim[0] == 0) | Cắt ngắn trục tung để làm nổi bật chênh lệch | Phóng đại sai lệch thị giác gấp nhiều lần |
| Kỳ thời gian chưa trọn vẹn | Loại bỏ tháng hoặc quý cuối cùng chưa kết thúc | Giữ nguyên kỳ cụt trong chuỗi thời gian | Gây hiểu lầm về sự sụt giảm đột ngột |
| Nhãn đo lường và đơn vị | Ghi rõ đơn vị tính trên các trục tọa độ | Chỉ ghi tên biến viết tắt không có đơn vị | Người xem không hiểu thang đo số liệu |
| Phân phối hai đỉnh | Dùng biểu đồ tần suất phân tách các phân khúc | Chỉ báo cáo duy nhất giá trị trung bình cộng | Giá trị trung bình rơi vào vùng không có dữ liệu |
| So sánh nhiều nhóm | Sử dụng sharey=True hoặc đồng bộ thang đo | Để mỗi biểu đồ con tự co giãn trục độc lập | Độc giả nhận thức sai lệch về quy mô mẫu |
| Quy trình xuất bản tự động | Kiểm tra cấu trúc hình ảnh bằng câu lệnh khẳng định | Kiểm tra thủ công bằng mắt thường | Bỏ sót lỗi kỹ thuật khi chạy pipeline lớn |
Lab 13: Trực quan hóa nâng cao với seaborn, bản đồ địa lý và phản biện biểu đồ
Cùng một bảng giá, biểu đồ hộp cho biết mức giá giữa các nhóm, còn bản đồ cho biết phân bố theo quận. Số đánh giá theo năm lại đặt ra một câu hỏi khác: Mức thay đổi phụ thuộc thế nào vào năm được chọn để so sánh? Bảy bài dưới đây lần lượt kiểm tra các cách trình bày này bằng dữ liệu nhỏ có thể tính lại.
Bối cảnh và snapshot dữ liệu tham chiếu
Các bài tập thực nghiệm trong bài học này đối chiếu trực tiếp với bộ dữ liệu lưu trữ công cộng của Inside Airbnb đối với thành phố Santiago, Chile:
- Địa chỉ kho dữ liệu gốc:
https://data.insideairbnb.com/chile/rm/santiago/ - Phiên bản snapshot tham chiếu: Bản lưu trữ ngày 29 tháng 06 năm 2026 (
2026-06-29/visualisations/listings.csv,2026-06-29/visualisations/reviews.csvvà2026-06-29/visualisations/neighbourhoods.geojson). - Đơn vị đo lường: Giá niêm yết được biểu diễn theo CLP/đêm. Giữ số khi tính toán và chọn mức làm tròn khi trình bày.
- Hệ quy chiếu tọa độ không gian (CRS): Kiểm tra CRS của dữ liệu khi nạp bản đồ thật. Các hình chữ nhật giả lập bên dưới được gán EPSG:3857 để minh họa phép ghép và vẽ.
NOTE
Dữ liệu để thử chương trình: DEMO_DS có 48 dòng chỗ ở ở năm quận. DEMO_QUAN_BAN_DO có sáu tên quận, thêm Pirque không có dòng chỗ ở trong mẫu. DEMO_RV chứa 3.900 đánh giá giả lập trong các năm 2014–2026.
Các hình chữ nhật trong ví dụ là ranh giới giả lập, không phải vị trí hoặc hình dạng các quận Santiago. Các số đếm và mức giá chỉ mô tả mẫu này. Nhãn “chuyên nghiệp” và “cá nhân” trong code là tên quy ước theo ngưỡng số chỗ ở, không xác nhận nghề nghiệp, chất lượng dịch vụ hay hình thức pháp lý của chủ nhà.
Khởi tạo môi trường và dữ liệu dùng chung
Toàn bộ các ví dụ và lời giải trong tài liệu sử dụng thư viện pandas, numpy, matplotlib, seaborn, shapely và geopandas:
python
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
from shapely.geometry import box
import geopandas as gpd

# Thiết lập giao diện đồ họa chuẩn mực
sns.set_theme(style="whitegrid")

# Bảng chỗ ở mẫu giả lập: 48 chỗ ở tại 5 quận
_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)
DEMO_DS = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
        "room_type": [
            "Private room" if k % 4 == 1 else "Entire home/apt" for k in range(48)
        ],
        "price": [
            (
                None
                if k % 11 == 5
                else float(18000 + (k * 7919) % 90000 + (15000 if k % 3 == 0 else 0))
            )
            for k in range(48)
        ],
        "calculated_host_listings_count": [1 + (k * 5) % 9 for k in range(48)],
    }
)

# Danh sách 6 quận trên bản đồ ranh giới (bao gồm quận Pirque trắng dữ liệu)
DEMO_QUAN_BAN_DO = [
    "Santiago",
    "Providencia",
    "Las Condes",
    "Ñuñoa",
    "Lo Barnechea",
    "Pirque",
]

# Bảng đánh giá mẫu giả lập: Tái hiện diễn biến chuỗi thời gian 2014-2026
_SO_THEO_NAM = {
    2014: 40,
    2015: 70,
    2016: 120,
    2017: 210,
    2018: 330,
    2019: 420,
    2020: 90,
    2021: 150,
    2022: 380,
    2023: 520,
    2024: 610,
    2025: 700,
    2026: 260,
}
DEMO_RV = pd.DataFrame(
    {
        "date": [
            pd.Timestamp(f"{nam}-01-01")
            + pd.Timedelta(days=(k * 97) % (181 if nam == 2026 else 365))
            for nam, so in _SO_THEO_NAM.items()
            for k in range(so)
        ]
    }
)

print(
    "Khởi tạo môi trường thành công: Chỗ ở =",
    len(DEMO_DS),
    ", Quận bản đồ =",
    len(DEMO_QUAN_BAN_DO),
    ", Đánh giá =",
    len(DEMO_RV),
)
Bảng 13.0: Cấu trúc dữ liệu mẫu giả lập của danh sách chỗ ở (DEMO_DS):
| id | neighbourhood | room_type | price (CLP) | calculated_host_listings_count |
|---|---|---|---|---|
| 201 | Santiago | Entire home/apt | 33,000 | 1 |
| 202 | Santiago | Private room | 25,919 | 6 |
| 203 | Santiago | Entire home/apt | 33,838 | 2 |
| 204 | Santiago | Entire home/apt | 56,757 | 7 |
| 205 | Santiago | Entire home/apt | 49,676 | 3 |
| 206 | Santiago | Entire home/apt | 8 |
Bài 1: So sánh phân phối giá theo nhóm chủ nhà và loại phòng bằng boxplot với hue trên thang logarit
Mục tiêu: Khảo sát phân phối giá lưu trú nhiều chiều bằng biểu đồ hộp (boxplot) của seaborn, kết hợp phân tầng màu sắc (hue) để so sánh hai nhóm quy mô chủ nhà theo từng loại phòng, rồi thực hành đọc giá trên thang log.
Dữ liệu đầu vào: Bảng dữ liệu chỗ ở co_gia đã loại bỏ các bản ghi khuyết giá (price.dropna()), gồm các cột:
price: Mức giá niêm yết mỗi đêm (số thực dương).room_type: Loại chỗ ở (Entire home/apt,Private room).kieu_host: Nhóm chủ nhà (chuyên nghiệpnếu calculated_host_listings_count từ 5 trở lên,cá nhânnếu calculated_host_listings_count dưới 5).
Thao tác yêu cầu:
- Xây dựng hàm
plot_price_box(co_gia: pd.DataFrame)nhận bảng dữ liệu và trả về đối tượngAxes. - Tạo khung vẽ mới với kích thước
figsize=(8.5, 4). - Sử dụng hàm
sns.boxplotvới trục hoành làprice, trục tung làroom_type, và phân tầng màu sắchue="kieu_host". - Thiết lập thang đo logarit cho trục hoành bằng lệnh
ax.set_xscale("log"). - Đặt tiêu đề rõ ràng phản ánh thông điệp phân tích (độ dài tối thiểu 15 ký tự), đặt nhãn trục hoành có đơn vị đo rõ ràng.
- Bảo đảm chú giải đồ thị do tham số
huesinh ra hiển thị đúng hai nhóm giá trịchuyên nghiệpvàcá nhân. - Trả lời câu hỏi phân tích: Ở từng loại phòng, hộp phân phối của nhóm chuyên nghiệp nằm lệch về phía nào? Hai nhóm chủ nhà có tách rời thành hai phân khúc giá riêng biệt hay không? Khi nào thang log hữu ích, và khi nào có thể giữ thang tuyến tính?
Trường hợp biên cần chú ý: Hàm phải hoạt động ổn định trên bảng dữ liệu chỉ có một loại phòng duy nhất hoặc khi một trong hai nhóm chủ nhà không có quan sát trong một phân khúc phòng.
Lời giải
Đọc hộp trước khi đọc màu
Hộp trải từ tứ phân vị dưới Q1 đến tứ phân vị trên Q3, đường trong hộp là trung vị. Với whis=1.5 mặc định, hai râu đi tới các quan sát xa nhất còn nằm trong hàng rào tương ứng. Râu không nhất thiết đi tới cực tiểu, cực đại của toàn bộ nhóm. Các quan sát ngoài râu được vẽ riêng.
Khoảng tứ phân vị được tính bằng:
Hàng rào dưới là:
Hàng rào trên là:
Thang log thích hợp khi cần xem các giá dương trải trên nhiều mức độ lớn hoặc so sánh theo tỷ lệ. Khoảng từ 10 đến 100 có cùng độ dài hiển thị với khoảng từ 100 đến 1000 trên thang log cơ số 10. Nó không biến mọi phân phối thành đối xứng và không bắt buộc cho mọi boxplot. Bài này dùng thang log để thực hành cách đọc đó.
Trên fixture, trung vị nhóm có từ năm chỗ ở cao hơn ở nguyên căn nhưng thấp hơn ở phòng riêng. Vì vậy không thể áp nhận xét cùng chiều cho cả hai loại phòng. Hai khoảng tứ phân vị có phần chồng lấn, nhưng điều đó không chứng minh nguyên nhân định giá hay quan hệ cạnh tranh giữa chủ nhà.
Cách 1: Sử dụng hàm seaborn.boxplot trực tiếp với giao diện Axes
python
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns


def plot_price_box(co_gia: pd.DataFrame) -> plt.Axes:
    """Vẽ boxplot phân phối giá theo loại phòng và nhóm chủ nhà trên thang logarit.

    Tham số:
        co_gia: DataFrame chứa cột 'price', 'room_type' và 'kieu_host'.
    Trả về:
        Đối tượng Axes chứa biểu đồ đã được định dạng chuẩn mực.
    """
    fig, ax = plt.subplots(figsize=(8.5, 4))
    sns.boxplot(
        data=co_gia,
        x="price",
        y="room_type",
        hue="kieu_host",
        palette=["#3182bd", "#de2d26"],
        ax=ax,
    )
    ax.set_xscale("log")
    ax.set_title(
        "Phân phối giá theo loại phòng và nhóm chủ nhà trên thang logarit",
        fontsize=11,
        fontweight="bold",
    )
    ax.set_xlabel("Giá niêm yết mỗi đêm (CLP, thang logarit)")
    ax.set_ylabel("Loại phòng lưu trú")
    return ax


# Dữ liệu thử nghiệm minh họa
_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)
demo_ds = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
        "room_type": [
            "Private room" if k % 4 == 1 else "Entire home/apt" for k in range(48)
        ],
        "price": [
            (
                None
                if k % 11 == 5
                else float(18000 + (k * 7919) % 90000 + (15000 if k % 3 == 0 else 0))
            )
            for k in range(48)
        ],
        "calculated_host_listings_count": [1 + (k * 5) % 9 for k in range(48)],
    }
)
co_gia_demo = demo_ds.dropna(subset=["price"]).assign(
    kieu_host=lambda d: (d["calculated_host_listings_count"] >= 5).map(
        {True: "chuyên nghiệp", False: "cá nhân"}
    )
)

ax_kq_c1 = plot_price_box(co_gia_demo)
print("Tiêu đề biểu đồ Cách 1:", ax_kq_c1.get_title())
print("Thang đo trục x:", ax_kq_c1.get_xscale())
print(
    "Các nhóm trong chú giải:",
    [t.get_text() for t in ax_kq_c1.get_legend().get_texts()],
)
plt.close(ax_kq_c1.figure)
Giải thích chi tiết Cách 1
plt.subplots tạo Figure và Axes để vẽ một hình độc lập. sns.boxplot đọc cột price cho trục ngang, room_type cho trục dọc và chia mỗi loại phòng theo hue. Mỗi hộp tóm tắt giá của một cặp loại phòng và nhóm quy ước.
ax.set_xscale("log") đổi cách đặt vị trí trên trục, nên chỉ dùng cho giá dương. Bước dropna trong ví dụ loại giá thiếu nhưng chưa tự loại giá bằng không hoặc âm từ một nguồn khác. Danh sách palette được gắn theo thứ tự hue mà seaborn suy ra. Màu hỗ trợ phân nhóm, còn nhãn chú giải vẫn cần để đọc đúng.
Kết quả thực thi Cách 1
| Thuộc tính đọc từ Axes | Kết quả trên fixture |
|---|---|
| get_xscale() | log |
| Tiêu đề | Phân phối giá theo loại phòng và nhóm chủ nhà trên thang logarit |
| Độ dài tiêu đề | 64 ký tự |
| Thứ tự chú giải | ["cá nhân", "chuyên nghiệp"] theo thứ tự xuất hiện của fixture |
| Số nhóm có giá | 4 |
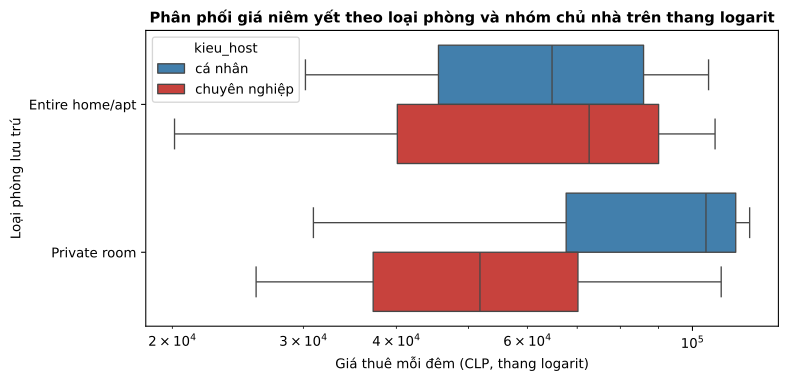
Cách 2: Kiểm soát thứ tự phân loại tường minh và tùy biến hộp nâng cao
python
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns


def plot_price_box_nang_cao(co_gia: pd.DataFrame) -> plt.Axes:
    """Vẽ boxplot với thứ tự phân loại cố định và định dạng chú giải nâng cao.

    Tham số:
        co_gia: DataFrame chứa cột 'price', 'room_type' và 'kieu_host'.
    Trả về:
        Đối tượng Axes đã tùy biến chuyên sâu.
    """
    fig, ax = plt.subplots(figsize=(8.5, 4))
    thu_tu_phong = ["Entire home/apt", "Private room"]
    thu_tu_host = ["cá nhân", "chuyên nghiệp"]
    sns.boxplot(
        data=co_gia,
        x="price",
        y="room_type",
        hue="kieu_host",
        order=thu_tu_phong,
        hue_order=thu_tu_host,
        palette={"cá nhân": "#2b8cbe", "chuyên nghiệp": "#e6550d"},
        width=0.6,
        showfliers=True,
        ax=ax,
    )
    ax.set_xscale("log")
    ax.set_title(
        "So sánh mức giá phân vị giữa chủ nhà chuyên nghiệp và cá nhân",
        fontsize=11,
        fontweight="bold",
    )
    ax.set_xlabel("Mức giá niêm yết (CLP/đêm, thang đo logarit)")
    ax.set_ylabel("Phân khúc phòng")
    ax.legend(title="Nhóm chủ nhà", loc="lower right", frameon=True)
    return ax


# Dữ liệu thử nghiệm minh họa
_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)
demo_ds = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
        "room_type": [
            "Private room" if k % 4 == 1 else "Entire home/apt" for k in range(48)
        ],
        "price": [
            (
                None
                if k % 11 == 5
                else float(18000 + (k * 7919) % 90000 + (15000 if k % 3 == 0 else 0))
            )
            for k in range(48)
        ],
        "calculated_host_listings_count": [1 + (k * 5) % 9 for k in range(48)],
    }
)
co_gia_demo = demo_ds.dropna(subset=["price"]).assign(
    kieu_host=lambda d: (d["calculated_host_listings_count"] >= 5).map(
        {True: "chuyên nghiệp", False: "cá nhân"}
    )
)

ax_kq_c2 = plot_price_box_nang_cao(co_gia_demo)
print("Tiêu đề biểu đồ Cách 2:", ax_kq_c2.get_title())
print("Thang đo trục x Cách 2:", ax_kq_c2.get_xscale())
print(
    "Kiểm tra nhãn chú giải:", [t.get_text() for t in ax_kq_c2.get_legend().get_texts()]
)
plt.close(ax_kq_c2.figure)
Giải thích chi tiết Cách 2
order cố định thứ tự hai loại phòng và hue_order cố định thứ tự hai nhóm. Từ điển palette gắn một màu với từng nhãn thay vì phụ thuộc vị trí đầu tiên trong dữ liệu. Khi thiếu một nhóm, thứ tự danh mục khai báo vẫn giúp so sánh các hình giữa những lần chạy.
width=0.6 chỉnh bề rộng nhóm hộp trên trục phân loại. showfliers=True giữ các điểm ngoài râu để người xem biết chúng tồn tại. Vị trí chú giải và khoảng cách chữ cần được rà lại khi tên nhóm hoặc số nhóm thay đổi. Những tùy chọn này không làm thay đổi số quan sát hoặc trung vị của từng nhóm.
Kết quả thực thi Cách 2
| room_type | Nhóm quy ước | n giá hợp lệ | Trung vị (CLP) | Q1 | Q3 |
|---|---|---|---|---|---|
| Entire home/apt | cá nhân | 15 | 64760.0 | 45570.0 | 85961.0 |
| Entire home/apt | chuyên nghiệp | 18 | 72637.0 | 40123.0 | 90056.75 |
| Private room | cá nhân | 5 | 104271.0 | 67651.0 | 114327.0 |
| Private room | chuyên nghiệp | 6 | 51813.0 | 37232.0 | 70165.0 |
So sánh hai cách
Cách 1 phù hợp để dựng và kiểm tra hình đầu tiên. Cách 2 thêm thứ tự và ánh xạ màu cố định cho việc so sánh nhiều hình. Các số trong bảng là thống kê của 44 giá hợp lệ trong fixture, không phải thống kê thị trường Santiago.
Bài 2: Ghép dữ liệu địa lý không gian với ranh giới quận, thống kê số chỗ ở và xử lý quận khuyết dữ liệu
Mục tiêu: Thực hiện phép kết hợp dữ liệu bảng thống kê chỗ ở với bảng ranh giới hình học không gian của các quận (GeoDataFrame), thống kê số lượng chỗ ở thực tế của từng quận, kiểm tra quận không có dòng trong mẫu và giải thích khi nào có thể điền số đếm bằng 0.
Dữ liệu đầu vào:
- Bảng dữ liệu chỗ ở
ds: Chứa cộtneighbourhood(tên quận hành chính của từng chỗ ở). - Bảng ranh giới địa lý
geo: hoặc GeoDataFrame chứa cộtneighbourhoodvới các tên quận duy nhất không trùng lặp (ví dụ 6 quận: Santiago, Providencia, Las Condes, Ñuñoa, Lo Barnechea, Pirque).
Thao tác yêu cầu:
- Xây dựng hàm
count_by_area(ds: pd.DataFrame, geo: pd.DataFrame) -> dict. - Đếm số lượng chỗ ở theo từng quận từ bảng
ds, đặt tên cột số lượng làn. - Thực hiện phép ghép trái
geo.merge(..., on="neighbourhood", how="left")để giữ nguyên toàn bộ số dòng và thứ tự dòng ban đầu của bảng ranh giớigeo. - Đếm số lượng quận có ranh giới trên bản đồ nhưng hoàn toàn không có chỗ ở nào trong bảng
ds(số lượng ôNaNngay sau phép ghép trái), lưu vào biếnso_quan_nan. - Điền giá trị 0 cho cột
nbằng phương thứcfillna(0)và ép kiểu sang số nguyênint. - Không chỉnh sửa bảng dữ liệu
geođầu vào. Chỗ ở thuộc các quận không có tên trên bản đồgeosẽ tự động bị loại bỏ khỏi bảng kết quả. - Trả về từ điển có đúng hai khóa:
"so_quan_nan": Số nguyên biểu thị số quận trắng dữ liệu."ban_do": Bảng sau khi ghép và điền 0, chứa toàn bộ các cột ban đầu củageocộng thêm cộtn.
Trường hợp biên cần chú ý: Bảng ds có thể không chứa bất kỳ chỗ ở nào của một số quận trên bản đồ, hoặc ngược lại chứa các chỗ ở có tên quận bị sai chính tả không khớp với geo. Phép ghép trái phải bảo toàn số hàng và thứ tự của geo.
Lời giải
Khi nào điền số đếm bằng không?
geo có sáu tên quận, trong khi ds chỉ chứa năm tên. Ghép trái theo tên giữ các dòng ranh giới và thêm số đếm nếu có khóa khớp. Đây là phép ghép theo thuộc tính, không phải phép xác định một điểm nằm trong đa giác nào.
Pirque không có dòng trong fixture nên số đếm sau ghép là . Sau khi kiểm tra tên khóa khớp và xác nhận phạm vi mẫu, ta có thể ghi số quan sát bằng 0. Nếu tên quận sai chính tả hoặc nguồn thu thập chưa bao phủ quận, NaN chưa đủ để kết luận không có chỗ ở. Các tên chỉ có trong ds nhưng không có trong geo không xuất hiện trên bảng kết quả và cần được kiểm tra riêng.
Cách 1: Sử dụng groupby kết hợp phép ghép merge và fillna tuần tự
python
import pandas as pd


def count_by_area_buoc(ds: pd.DataFrame, geo: pd.DataFrame) -> dict:
    """Ghép số lượng chỗ ở vào bảng ranh giới địa lý theo cách tiếp cận tuần tự.

    Tham số:
        ds: DataFrame chứa cột 'neighbourhood'.
        geo: DataFrame hoặc GeoDataFrame chứa cột 'neighbourhood'.
    Trả về:
        Từ điển gồm 'so_quan_nan' và 'ban_do'.
    """
    dem = ds.groupby("neighbourhood", observed=False).size().reset_index(name="n")
    ban_do_raw = geo.merge(dem, on="neighbourhood", how="left")
    so_quan_nan = int(ban_do_raw["n"].isna().sum())
    ban_do = ban_do_raw.copy()
    ban_do["n"] = ban_do["n"].fillna(0).astype(int)
    return {"so_quan_nan": so_quan_nan, "ban_do": ban_do}


# Dữ liệu thử nghiệm minh họa
_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)
demo_ds = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
    }
)
demo_quan_ban_do = [
    "Santiago",
    "Providencia",
    "Las Condes",
    "Ñuñoa",
    "Lo Barnechea",
    "Pirque",
]
geo_demo = pd.DataFrame(
    {
        "neighbourhood": demo_quan_ban_do,
        "neighbourhood_group": [None] * 6,
    }
)

kq_c1 = count_by_area_buoc(demo_ds, geo_demo)
print("Số quận không có chỗ ở (Cách 1):", kq_c1["so_quan_nan"])
print("Bảng kết quả sau khi ghép Cách 1:")
print(kq_c1["ban_do"])
Giải thích chi tiết Cách 1
groupby(...).size() đếm mọi dòng trong mỗi nhóm, kể cả dòng thiếu giá. reset_index(name="n") tạo bảng đếm hai cột để ghép. Vì bảng đếm có một dòng cho mỗi tên quận và geo có khóa duy nhất, phép ghép trái giữ sáu dòng bản đồ trong bài.
Đếm ngay sau ghép giúp lưu được số quận không khớp trước khi điền. fillna(0).astype(int) chuyển cột số đếm thành số nguyên. Không áp quy tắc điền không này cho cột giá: Không biết giá không đồng nghĩa giá bằng không.
Kết quả thực thi Cách 1
| neighbourhood | n |
|---|---|
| Santiago | 18 |
| Providencia | 12 |
| Las Condes | 8 |
| Ñuñoa | 6 |
| Lo Barnechea | 4 |
| Pirque | 0 |
so_quan_nan bằng 1, tổng n bằng 48. Các cột ban đầu của geo được giữ.
Cách 2: Sử dụng Series.map vector hóa và kiểm tra tính toàn vẹn dữ liệu
python
import pandas as pd


def count_by_area_map(ds: pd.DataFrame, geo: pd.DataFrame) -> dict:
    """Ghép số lượng chỗ ở bằng ánh xạ Series.map vector hóa.

    Tham số:
        ds: DataFrame chứa cột 'neighbourhood'.
        geo: DataFrame hoặc GeoDataFrame chứa cột 'neighbourhood'.
    Trả về:
        Từ điển gồm 'so_quan_nan' và 'ban_do'.
    """
    counts = ds["neighbourhood"].value_counts()
    ban_do = geo.copy()
    so_quan_nan = int((~ban_do["neighbourhood"].isin(counts.index)).sum())
    ban_do["n"] = ban_do["neighbourhood"].map(counts).fillna(0).astype(int)
    return {"so_quan_nan": so_quan_nan, "ban_do": ban_do}


# Dữ liệu thử nghiệm minh họa
_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)
demo_ds = pd.DataFrame({"neighbourhood": _QUAN})
geo_demo = pd.DataFrame(
    {
        "neighbourhood": [
            "Santiago",
            "Providencia",
            "Las Condes",
            "Ñuñoa",
            "Lo Barnechea",
            "Pirque",
        ],
        "neighbourhood_group": [None] * 6,
    }
)

kq_c2 = count_by_area_map(demo_ds, geo_demo)
print(kq_c2["ban_do"].to_string(index=False))
print(
    "Giá trị số chỗ ở của quận Pirque:",
    kq_c2["ban_do"].loc[kq_c2["ban_do"]["neighbourhood"] == "Pirque", "n"].item(),
)
Giải thích chi tiết Cách 2
Khi chỉ cần một chỉ số đếm, value_counts() tạo Series có là tên quận. Series.map(counts) tra số đếm tương ứng cho mỗi tên trong bảng ranh giới. Các tên không có trong Series nhận để có thể đếm và xử lý theo cùng quy tắc.
Cách viết này tránh đưa thêm các cột không cần thiết vào phép ghép, nhưng vẫn phải tạo và tra cứu cấu trúc đếm. Không thể kết luận nó nhanh hơn merge trên mọi kích thước bảng nếu chưa đo. Cần giữ bản sao bảng đích và thứ tự dòng khi gán cột mới.
Kết quả thực thi Cách 2
| neighbourhood | n |
|---|---|
| Santiago | 18 |
| Providencia | 12 |
| Las Condes | 8 |
| Ñuñoa | 6 |
| Lo Barnechea | 4 |
| Pirque | 0 |
so_quan_nan cũng bằng 1. và các cột ranh giới được giữ để vẽ tiếp.
So sánh hai cách
Hai cách cùng ánh xạ số đếm lên tên quận. Merge thuận tiện khi cần thêm nhiều chỉ số trong một bảng tổng hợp. Map biểu đạt gọn việc tra một chỉ số theo khóa. Cả hai cần kiểm tra tên không khớp trước khi diễn giải các số không.
Bài 3: Xây dựng cặp bản đồ choropleth đối chiếu giá trung vị và quy mô nguồn cung chỗ ở
Mục tiêu: Thiết kế và kết xuất cặp bản đồ phân bố màu sắc (choropleth map) song hành từ dữ liệu hình học tổng hợp (synthetic polygon GeoDataFrame), đối chiếu trực tiếp giữa mức giá trung vị và quy mô nguồn cung chỗ ở thực tế, qua đó nhận diện và giải thích bẫy diện tích địa lý (Geographical Area Bias) mà không suy diễn thiên kiến về an toàn hay mức độ ưa chuộng.
Dữ liệu đầu vào:
- Bảng chỗ ở
ds: Chứa cộtneighbourhoodvà cộtprice. - Bảng ranh giới địa lý tổng hợp
geo_synth: Đối tượngGeoDataFramechứa 6 đa giác hình chữ nhật mô phỏng 6 quận (Santiago, Providencia, Las Condes, Ñuñoa, Lo Barnechea, Pirque) được khởi tạo bằng thư viện Shapely, hệ tọa độ chuẩn EPSG:3857.
Thao tác yêu cầu:
- Xây dựng hàm
plot_dual_choropleth(ds: pd.DataFrame, geo: gpd.GeoDataFrame, path: str) -> gpd.GeoDataFrame. - Tính toán hai chỉ số kinh tế song song cho từng quận:
- Mức giá trung vị (
gia): Tính trung vị của cộtpricesau khi bỏ giá trị khuyết. - Số lượng cơ sở lưu trú (
n): Đếm số dòng của từng quận.
- Mức giá trung vị (
- Ghép hai chỉ số trên vào bảng ranh giới
geo_synth. Quận không có chỗ ở (Pirque) phải được điền 0 cho cộtnvà giữNaNcho cộtgia. - Tạo khung vẽ gồm hai đồ thị con nằm cạnh nhau (
1 hàng, 2 cột) với kích thướcfigsize=(13, 5.5). - Bản đồ thứ nhất (bên trái): Thể hiện mức giá trung vị (
gia) với dải màu ấmYlOrRd, thiết lập màu xám nhạt (#e0e0e0) cho các quận không có dữ liệu giá (missing_kwds). - Bản đồ thứ hai (bên phải): Thể hiện quy mô nguồn cung (
n) với dải màu lamBlues. - Tắt khung trục tọa độ (
ax.set_axis_off()) trên cả hai bản đồ, ghi nhãn tên quận và giá trị tương ứng lên tâm hình học (centroid) của từng đa giác. - Bổ sung tiêu đề chung và dòng chú thích phương pháp luận ở góc dưới khung tranh.
- Kết xuất biểu đồ ra tệp hình ảnh định dạng vector SVG tại đường dẫn
path.
Trường hợp biên cần chú ý: Quận Pirque không có bất kỳ chỗ ở nào nên cột giá mang giá trị NaN, bản đồ giá phải xử lý tô màu xám phân biệt thay vì phát sinh lỗi render.
Lời giải
Hai bản đồ trả lời hai câu hỏi
Bản đồ giá cho trung vị của những chỗ ở có giá, còn bản đồ số lượng cho số dòng chỗ ở được quan sát. Một quận có trung vị cao chưa chắc có nhiều niêm yết. Các giá trị này cũng chưa cho biết số lượt đặt phòng, mức độ an toàn hay sở thích của khách.
Các đa giác trong fixture đều là hình vuông cùng diện tích. Chúng giúp kiểm tra màu và phép ghép nhưng không minh họa khác biệt diện tích thực giữa các quận. Khi dùng ranh giới thật, diện tích mảng màu có thể ảnh hưởng mức chú ý của người xem. Bản đồ số lượng bổ sung quy mô, còn muốn so sánh mật độ phải tính số lượng trên một đơn vị diện tích phù hợp.
Cách 1: Dựng cặp bản đồ tuần tự với Shapely Box và GeoPandas Plot
python
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from shapely.geometry import box
import geopandas as gpd


def tao_geo_tong_hop() -> gpd.GeoDataFrame:
    """Tạo GeoDataFrame mô phỏng lưới không gian 6 quận thành phố."""
    o_luoi = [
        box(0, 1, 1, 2),  # Santiago (trung tâm nội đô)
        box(1, 1, 2, 2),  # Providencia (khu thương mại)
        box(2, 1, 3, 2),  # Las Condes (khu tài chính)
        box(0, 0, 1, 1),  # Ñuñoa (khu dân cư)
        box(1, 0, 2, 1),  # Lo Barnechea (ngoại ô diện tích lớn)
        box(2, 0, 3, 1),  # Pirque (vùng đệm ngoại vi)
    ]
    return gpd.GeoDataFrame(
        {
            "neighbourhood": [
                "Santiago",
                "Providencia",
                "Las Condes",
                "Ñuñoa",
                "Lo Barnechea",
                "Pirque",
            ],
            "neighbourhood_group": [None] * 6,
        },
        geometry=o_luoi,
        crs="EPSG:3857",
    )


def plot_dual_choropleth(
    ds: pd.DataFrame, geo: gpd.GeoDataFrame, path: str
) -> gpd.GeoDataFrame:
    """Vẽ cặp bản đồ choropleth đối chiếu giá trung vị và số lượng chỗ ở."""
    kpi_gia = (
        ds.dropna(subset=["price"])
        .groupby("neighbourhood")["price"]
        .median()
        .reset_index(name="gia")
    )
    kpi_so = ds.groupby("neighbourhood").size().reset_index(name="n")
    kpi = pd.merge(kpi_so, kpi_gia, on="neighbourhood", how="left")
    ban_do = geo.merge(kpi, on="neighbourhood", how="left")
    ban_do["n"] = ban_do["n"].fillna(0).astype(int)

    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 5.5))

    # Bản đồ 1: Mức giá trung vị
    ban_do.plot(
        column="gia",
        cmap="YlOrRd",
        legend=True,
        edgecolor="#444",
        linewidth=0.8,
        ax=ax1,
        missing_kwds={"color": "#e0e0e0", "label": "Không có chỗ ở"},
        legend_kwds={"label": "Giá trung vị (CLP/đêm)", "shrink": 0.7},
    )
    ax1.set_title(
        "Bản đồ 1: Mức giá trung vị theo quận", fontsize=11, fontweight="bold"
    )
    ax1.set_axis_off()

    # Bản đồ 2: Quy mô nguồn cung
    ban_do.plot(
        column="n",
        cmap="Blues",
        legend=True,
        edgecolor="#444",
        linewidth=0.8,
        ax=ax2,
        legend_kwds={"label": "Số lượng chỗ ở niêm yết (n)", "shrink": 0.7},
    )
    ax2.set_title(
        "Bản đồ 2: Quy mô nguồn cung thực tế theo quận", fontsize=11, fontweight="bold"
    )
    ax2.set_axis_off()

    # Ghi nhãn trực tiếp trên tâm hình học của từng quận
    for _, row in ban_do.iterrows():
        pt = row.geometry.centroid
        gia_str = f"{row['gia']/1000:.0f}k" if pd.notna(row["gia"]) else "Trắng"
        ax1.text(
            pt.x,
            pt.y,
            f"{row['neighbourhood']}\n{gia_str}",
            ha="center",
            va="center",
            fontsize=8,
            color="#222",
        )
        ax2.text(
            pt.x,
            pt.y,
            f"{row['neighbourhood']}\nn={row['n']}",
            ha="center",
            va="center",
            fontsize=8,
            color="#222",
        )

    fig.suptitle(
        "Cặp bản đồ đối chiếu: Phân khúc giá và Quy mô nguồn cung (Tránh bẫy diện tích địa lý)",
        fontsize=13,
        fontweight="bold",
        y=0.98,
    )
    fig.text(
        0.02,
        0.02,
        "Lưu ý phương pháp luận: Quận diện tích lớn có giá cao nhưng nguồn cung ít, không suy diễn mức độ an toàn hay độ ưa chuộng từ giá.",
        fontsize=8,
        color="#555",
    )

    Path(path).parent.mkdir(parents=True, exist_ok=True)
    fig.savefig(path, format="svg", bbox_inches="tight")
    plt.close(fig)
    return ban_do


# Dữ liệu thử nghiệm minh họa
_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)
demo_ds = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
        "price": [
            (
                None
                if k % 11 == 5
                else float(18000 + (k * 7919) % 90000 + (15000 if k % 3 == 0 else 0))
            )
            for k in range(48)
        ],
    }
)
geo_synth_demo = tao_geo_tong_hop()
duong_dan_svg = "docs/xu-ly-du-lieu/bai-giang/img/labs/lab-13/hinh-13-03-cap-ban-do-gia-va-so-luong.svg"
ban_do_kq_c1 = plot_dual_choropleth(demo_ds, geo_synth_demo, duong_dan_svg)
print("Kết xuất cặp bản đồ Cách 1 thành công. Số quận trên bản đồ:", len(ban_do_kq_c1))
Giải thích chi tiết Cách 1
box tạo các hình chữ nhật giả lập theo bốn tọa độ góc. Gán CRS không biến chúng thành vị trí thực của các quận. Với ví dụ này, centroid chỉ dùng để đặt nhãn ở giữa ô vuông. Trên bản đồ thật, centroid có thể nằm ngoài một đa giác lõm và không phải lúc nào cũng là vị trí nhãn thích hợp.
Sau khi tổng hợp, ghép trái giữ đủ sáu quận. missing_kwds đặt màu xám cho giá để khác với một mức giá bằng không. Hai Axes có thanh màu riêng vì giá và số đếm khác đơn vị. Khi so sánh nhiều snapshot, cần xét thêm việc giữ cùng giới hạn thang màu cho cùng một chỉ số.
Kết quả thực thi Cách 1
| neighbourhood | n | Giá trung vị (CLP/đêm) |
|---|---|---|
| Santiago | 18 | 59271.0 |
| Providencia | 12 | 67651.0 |
| Las Condes | 8 | 87029.5 |
| Ñuñoa | 6 | 72679.0 |
| Lo Barnechea | 4 | 63314.5 |
| Pirque | 0 |
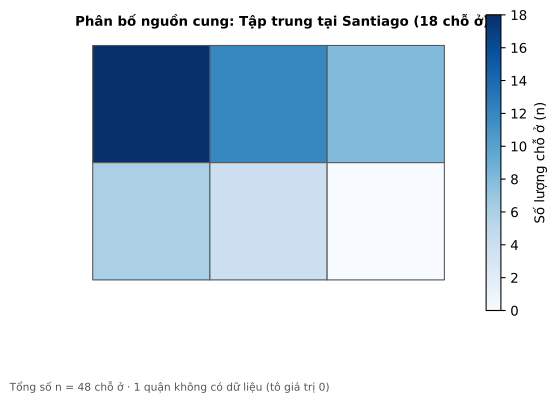
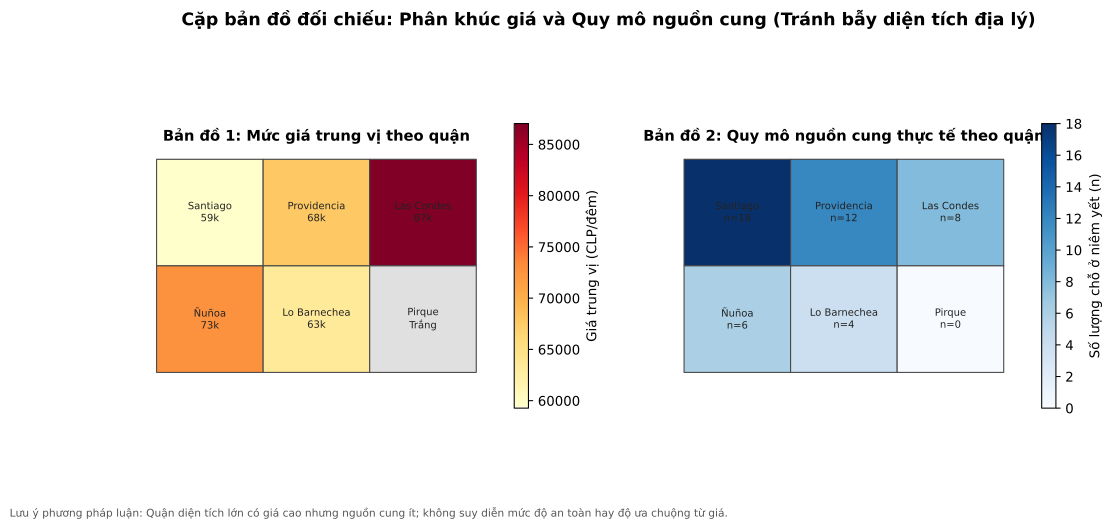
Cách 2: Tự động hóa thanh màu liên tục với colorbar độc lập và định dạng SVG tối ưu
python
from pathlib import Path
import matplotlib.pyplot as plt
import matplotlib.cm as cm
import matplotlib.colors as mcolors
import numpy as np
import pandas as pd
from shapely.geometry import box
import geopandas as gpd


def plot_dual_choropleth_chuyen_nghiep(
    ds: pd.DataFrame, geo: gpd.GeoDataFrame, path: str
) -> gpd.GeoDataFrame:
    """Vẽ cặp bản đồ không gian với thanh tỷ lệ màu sắc chuẩn hóa và kiểm soát ngoại biên."""
    kpi = (
        ds.groupby("neighbourhood")
        .agg(gia=("price", "median"), n=("id", "size"))
        .reset_index()
    )
    ban_do = geo.merge(kpi, on="neighbourhood", how="left")
    ban_do["n"] = ban_do["n"].fillna(0).astype(int)

    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 5.5))

    # Căn chỉnh thanh màu cho bản đồ giá
    gia_hop_le = ban_do["gia"].dropna()
    norm_gia = mcolors.Normalize(vmin=gia_hop_le.min(), vmax=gia_hop_le.max())
    cmap_gia = cm.YlOrRd
    ban_do.plot(
        column="gia",
        cmap=cmap_gia,
        norm=norm_gia,
        edgecolor="#333",
        linewidth=0.7,
        missing_kwds={"color": "#eeeeee"},
        ax=ax1,
    )
    sm1 = cm.ScalarMappable(norm=norm_gia, cmap=cmap_gia)
    fig.colorbar(
        sm1,
        ax=ax1,
        orientation="horizontal",
        fraction=0.046,
        pad=0.04,
        label="Giá trung vị (CLP)",
    )
    ax1.set_title("Phân bố mức giá trung vị", fontsize=11, fontweight="bold")
    ax1.set_axis_off()

    # Căn chỉnh thanh màu cho bản đồ số lượng chỗ ở
    norm_n = mcolors.Normalize(vmin=0, vmax=ban_do["n"].max())
    cmap_n = cm.Blues
    ban_do.plot(
        column="n", cmap=cmap_n, norm=norm_n, edgecolor="#333", linewidth=0.7, ax=ax2
    )
    sm2 = cm.ScalarMappable(norm=norm_n, cmap=cmap_n)
    fig.colorbar(
        sm2,
        ax=ax2,
        orientation="horizontal",
        fraction=0.046,
        pad=0.04,
        label="Số lượng chỗ ở (n)",
    )
    ax2.set_title("Quy mô nguồn cung chỗ ở", fontsize=11, fontweight="bold")
    ax2.set_axis_off()

    fig.suptitle(
        "Khảo sát không gian đô thị: So sánh chất lượng phân khúc và dung lượng nguồn cung",
        fontsize=12,
        fontweight="bold",
    )
    Path(path).parent.mkdir(parents=True, exist_ok=True)
    fig.savefig(path, format="svg", bbox_inches="tight")
    plt.close(fig)
    return ban_do


def tao_geo_tong_hop() -> gpd.GeoDataFrame:
    """Tạo GeoDataFrame mô phỏng lưới không gian 6 quận thành phố."""
    o_luoi = [
        box(0, 1, 1, 2),  # Santiago (trung tâm nội đô)
        box(1, 1, 2, 2),  # Providencia (khu thương mại)
        box(2, 1, 3, 2),  # Las Condes (khu tài chính)
        box(0, 0, 1, 1),  # Ñuñoa (khu dân cư)
        box(1, 0, 2, 1),  # Lo Barnechea (ngoại ô diện tích lớn)
        box(2, 0, 3, 1),  # Pirque (vùng đệm ngoại vi)
    ]
    return gpd.GeoDataFrame(
        {
            "neighbourhood": [
                "Santiago",
                "Providencia",
                "Las Condes",
                "Ñuñoa",
                "Lo Barnechea",
                "Pirque",
            ],
            "neighbourhood_group": [None] * 6,
        },
        geometry=o_luoi,
        crs="EPSG:3857",
    )


_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)

demo_ds = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
        "price": [
            (
                None
                if k % 11 == 5
                else float(18000 + (k * 7919) % 90000 + (15000 if k % 3 == 0 else 0))
            )
            for k in range(48)
        ],
    }
)

# Chạy ví dụ
geo_synth_demo = tao_geo_tong_hop()
ban_do_kq_c2 = plot_dual_choropleth_chuyen_nghiep(
    demo_ds,
    geo_synth_demo,
    "docs/xu-ly-du-lieu/bai-giang/img/labs/lab-13/hinh-13-03-cap-ban-do-gia-va-so-luong.svg",
)
print(ban_do_kq_c2[["neighbourhood", "n", "gia"]].to_string(index=False))
Giải thích chi tiết Cách 2
Normalize(vmin, vmax) ánh xạ giá trị số lên thang màu. ScalarMappable cung cấp đối tượng dùng để tạo colorbar riêng của Matplotlib. Các tham số orientation, fraction và pad điều chỉnh hướng, độ lớn và khoảng cách thanh màu với bản đồ.
Những thiết lập này điều chỉnh bố cục, không đổi số liệu tổng hợp. Giá và số đếm vẫn cần hai thanh màu có nhãn đơn vị khác nhau. SVG lưu các hình và đường dưới dạng vector, nhưng chữ, chú giải và tỉ lệ bố cục vẫn cần kiểm tra ở kích thước hiển thị thực tế.
Kết quả thực thi Cách 2
| Quận | n | Tỷ trọng trong 48 dòng (%) | Giá trung vị (CLP) |
|---|---|---|---|
| Santiago | 18 | 37.5 | 59271.0 |
| Providencia | 12 | 25.0 | 67651.0 |
| Las Condes | 8 | 16.7 | 87029.5 |
| Ñuñoa | 6 | 12.5 | 72679.0 |
| Lo Barnechea | 4 | 8.3 | 63314.5 |
| Pirque | 0 | 0.0 |
So sánh hai cách
Cách 1 để GeoPandas dựng phần lớn chú giải màu. Cách 2 điều khiển colorbar bằng các đối tượng Matplotlib riêng. Cả hai phải giữ Pirque có n bằng 0 và giá . Trên mẫu, Las Condes có trung vị cao nhất còn Santiago có nhiều dòng nhất.
Bài 4: Thống kê chuỗi thời gian số lượng đánh giá theo chu kỳ hàng năm trong khoảng xác định
Mục tiêu: Xử lý chuỗi thời gian chứa cột ngày tháng (datetime64), thực hiện tổng hợp tái lấy mẫu (resample) theo tần suất kết thúc năm dương lịch (YE), cắt lát dữ liệu trong một khoảng thời gian xác định và bảo đảm các năm không có quan sát nhận giá trị 0.
Dữ liệu đầu vào:
- Bảng đánh giá
rv: Chứa cộtdatekiểu dữ liệu thời gian chuẩndatetime64[ns]. - Hai tham số chuỗi biểu thị năm bắt đầu
bat_dau(ví dụ"2016") và năm kết thúcket_thuc(ví dụ"2025").
Thao tác yêu cầu:
- Xây dựng hàm
yearly_counts(rv: pd.DataFrame, bat_dau: str, ket_thuc: str) -> pd.Series. - Chuyển cột
datethành thời gian DatetimeIndex, thực hiện phép tái lấy mẫu theo chu kỳ cuối năm dương lịch bằng cú phápresample("YE").size(). - Cắt lát chuỗi dữ liệu trong dải thời gian từ
bat_dauđếnket_thucbằng cú pháp.loc[bat_dau:ket_thuc]. - Bảo đảm của Series kết quả là
DatetimeIndexvới các nhãn là ngày cuối cùng của từng năm (YYYY-12-31). - Không chỉnh sửa bảng dữ liệu
rvđầu vào. - Giải thích vì sao khi thống kê sản lượng hàng năm, người phân tích cần tách rõ năm hiện tại chưa kết thúc khi so sánh với tổng các năm đầy đủ (như năm 2026 với mốc chụp snapshot vào tháng 6).
Trường hợp biên cần chú ý: Nếu trong khoảng thời gian có một năm hoàn toàn không có đánh giá nào, hàm resample phải giữ nguyên năm đó với số đếm bằng 0 thay vì làm mất của năm.
Lời giải
Đếm đánh giá theo khoảng thời gian
Mỗi bản ghi đánh giá đóng góp một đơn vị vào năm chứa ngày của nó. Số đánh giá là một đại lượng quan sát được, không đồng nhất với số lượt đặt phòng. Muốn dùng nó để ước lượng giao dịch phải bổ sung giả định về việc khách để lại đánh giá.
Để so sánh các tổng năm trọn vẹn, bài này lấy 2016–2025 và tách năm 2026 chưa kết thúc khỏi dải đó. Có thể trình bày năm chưa trọn nếu gắn nhãn rõ, hoặc so cùng kỳ giữa các năm. Không được coi tổng chưa trọn và tổng đủ năm là cùng độ dài quan sát.
Cách 1: Sử dụng set_index kết hợp resample và cắt lát nhãn chuỗi
python
import pandas as pd


def yearly_counts_resample(rv: pd.DataFrame, bat_dau: str, ket_thuc: str) -> pd.Series:
    """Đếm số lượng đánh giá theo từng năm trong khoảng xác định bằng resample.

    Tham số:
        rv: DataFrame chứa cột 'date' kiểu datetime64.
        bat_dau: Chuỗi năm bắt đầu (ví dụ '2016').
        ket_thuc: Chuỗi năm kết thúc (ví dụ '2025').
    Trả về:
        Series với chỉ mục DatetimeIndex biểu thị ngày cuối năm.
    """
    chuoi_nam = rv.set_index("date").resample("YE").size()
    return chuoi_nam.loc[bat_dau:ket_thuc]


# Dữ liệu thử nghiệm minh họa
_SO_THEO_NAM = {
    2014: 40,
    2015: 70,
    2016: 120,
    2017: 210,
    2018: 330,
    2019: 420,
    2020: 90,
    2021: 150,
    2022: 380,
    2023: 520,
    2024: 610,
    2025: 700,
    2026: 260,
}
demo_rv = pd.DataFrame(
    {
        "date": [
            pd.Timestamp(f"{nam}-01-01")
            + pd.Timedelta(days=(k * 97) % (181 if nam == 2026 else 365))
            for nam, so in _SO_THEO_NAM.items()
            for k in range(so)
        ]
    }
)

nam_kq_c1 = yearly_counts_resample(demo_rv, "2016", "2025")
print("Kết quả Cách 1 (Dải năm 2016-2025):")
print(nam_kq_c1)
Giải thích chi tiết Cách 1
set_index("date") đưa ngày vào DatetimeIndex để resample gom theo thời gian. resample("YE").size() đếm số dòng trong từng năm và gắn nhãn ngày cuối năm. Một năm không có dòng nhưng nằm giữa các năm có dữ liệu vẫn có nhóm với số đếm bằng 0.
.loc[bat_dau:ket_thuc] dùng chuỗi năm và bao gồm cả hai đầu. Hàm không sửa cột date trên bảng gốc. Resample chỉ phủ dải thời gian của dữ liệu, nên nếu cần các năm yêu cầu nằm ngoài dải này, phải tạo dải chỉ mục mục tiêu rồi reindex rõ ràng.
Kết quả thực thi Cách 1
| Ngày | Số đánh giá |
|---|---|
| 2016-12-31 | 120 |
| 2017-12-31 | 210 |
| 2018-12-31 | 330 |
| 2019-12-31 | 420 |
| 2020-12-31 | 90 |
| 2021-12-31 | 150 |
| 2022-12-31 | 380 |
| 2023-12-31 | 520 |
| 2024-12-31 | 610 |
| 2025-12-31 | 700 |
Cách 2: Trích xuất thuộc tính năm kết hợp reindex dải ngày liên tục
python
import pandas as pd


def yearly_counts_reindex(rv: pd.DataFrame, bat_dau: str, ket_thuc: str) -> pd.Series:
    """Đếm số lượng đánh giá bằng trích xuất năm và tái chỉ mục dải ngày.

    Tham số:
        rv: DataFrame chứa cột 'date'.
        bat_dau: Chuỗi năm bắt đầu.
        ket_thuc: Chuỗi năm kết thúc.
    Trả về:
        Series có chỉ mục DatetimeIndex tương đương.
    """
    counts = rv["date"].dt.year.value_counts()
    start_y, end_y = int(bat_dau), int(ket_thuc)
    full_idx = pd.date_range(start=f"{start_y}-12-31", end=f"{end_y}-12-31", freq="YE")
    s = counts.reindex(range(start_y, end_y + 1), fill_value=0).astype(int)
    s.index = full_idx
    s.index.name = "date"
    s.name = None
    return s


_SO_THEO_NAM = {
    2014: 40,
    2015: 70,
    2016: 120,
    2017: 210,
    2018: 330,
    2019: 420,
    2020: 90,
    2021: 150,
    2022: 380,
    2023: 520,
    2024: 610,
    2025: 700,
    2026: 260,
}

demo_rv = pd.DataFrame(
    {
        "date": [
            pd.Timestamp(f"{nam}-01-01")
            + pd.Timedelta(days=(k * 97) % (181 if nam == 2026 else 365))
            for nam, so in _SO_THEO_NAM.items()
            for k in range(so)
        ]
    }
)

# Kiểm thử tính đồng nhất
nam_kq_c2 = yearly_counts_reindex(demo_rv, "2016", "2025")
print(nam_kq_c2.to_string())
Giải thích chi tiết Cách 2
.dt.year lấy năm từ từng ngày. value_counts() đếm năm, còn pd.date_range(..., freq="YE") tạo đầy đủ các mốc cuối năm yêu cầu. Tra counts.get(dt.year, 0) đặt số không cho năm không có trong bảng đếm.
Tạo dải năm riêng giúp biểu thị cả năm chưa có quan sát ở đầu hoặc cuối khoảng yêu cầu, khác với chỉ cắt dải resample đã có. Cả hai cách giả định cột ngày đã là dữ liệu thời gian hợp lệ. Ngày thiếu hoặc không phân tích được cần quy tắc xử lý trước bước tổng hợp.
Kết quả thực thi Cách 2
| Ngày | Số đánh giá |
|---|---|
| 2016-12-31 | 120 |
| 2017-12-31 | 210 |
| 2018-12-31 | 330 |
| 2019-12-31 | 420 |
| 2020-12-31 | 90 |
| 2021-12-31 | 150 |
| 2022-12-31 | 380 |
| 2023-12-31 | 520 |
| 2024-12-31 | 610 |
| 2025-12-31 | 700 |
So sánh hai cách
Cách 1 bám trực tiếp thao tác gom theo thời gian của pandas. Cách 2 dựng dải năm mục tiêu rồi tra số đếm. Trên fixture, hai cách trả mười mốc cuối năm từ 2016 đến 2025. Nếu chọn riêng năm 2026, số đếm là 260 nhưng phải ghi đây là dữ liệu chưa đủ năm.
Bài 5: Phân tích định lượng độ lệch tăng trưởng khi chọn mốc so sánh và phản biện kỳ gốc
Mục tiêu: Xây dựng phép tính tỷ số số đánh giá giữa một năm đích với các năm cơ sở khác nhau, phân tích hiện tượng thao túng mốc so sánh (selective baseline / cherry-picking) và giải thích thông tin bị thiếu khi chỉ xem một kỳ gốc.
Dữ liệu đầu vào:
- Series chuỗi thời gian
nam: làDatetimeIndexbiểu thị ngày cuối năm, giá trị là số lượng đánh giá tích lũy của năm đó. - Tham số
nam_cuoi: Năm mục tiêu cần so sánh (kiểu số nguyên, ví dụ2025). - Tham số
cac_moc: Danh sách các năm cơ sở cần đối chiếu (kiểu danh sách số nguyên, ví dụ[2020, 2019, 2016]).
Thao tác yêu cầu:
- Xây dựng hàm
compare_baselines(nam: pd.Series, nam_cuoi: int, cac_moc: list) -> dict. - Trích xuất số lượng đánh giá của năm
nam_cuoi. - Duyệt qua từng năm mốc trong
cac_moc, tính tỷ số. Ở đây, là số đánh giá năm cuối và là số đánh giá năm mốc, với . - Trả về từ điển có khóa là năm mốc (số nguyên) và giá trị là tỷ số tăng trưởng (số thực float chính xác, không làm tròn), bảo toàn đúng thứ tự xuất hiện của
cac_moc. - Không chỉnh sửa Series
namđầu vào. - Lập bảng so sánh định lượng và giải thích vì sao việc chỉ chọn duy nhất năm 2020 làm mốc so sánh lại tạo ra một kết luận phóng đại sai lệch.
Trường hợp biên cần chú ý: Mọi năm trong cac_moc và nam_cuoi đều được bảo đảm có mặt trong Series nam. Mẫu số luôn là số nguyên dương lớn hơn 0.
Lời giải
Tỷ số đúng vẫn cần nói rõ kỳ gốc
Gọi a là số đánh giá năm cuối và b là số đánh giá năm mốc. Tỷ số a chia b mô tả năm cuối bằng bao nhiêu lần năm mốc. Mức tăng phần trăm là tỷ số đó trừ 1 rồi nhân 100. Hai cách diễn đạt khác nhau, nên cần ghi rõ đang báo tỷ số hay phần trăm tăng.
Trong fixture, 700 chia 90 xấp xỉ 7,78, còn 700 chia 420 xấp xỉ 1,67. Cả hai phép chia đều đúng, nhưng trả lời hai câu hỏi với hai mốc khác nhau. Chỉ hiển thị từ năm có số đếm thấp có thể làm người đọc thiếu bối cảnh. Các số giả lập này không chứng minh tốc độ phục hồi kinh tế hoặc nguyên nhân của mức thấp năm 2020.
Cách 1: Vòng lặp tra cứu boolean theo chỉ mục thời gian
python
import pandas as pd


def compare_baselines_loop(nam: pd.Series, nam_cuoi: int, cac_moc: list) -> dict:
    """Tính tỷ số tăng trưởng so với các năm mốc theo cách duyệt tuần tự.

    Tham số:
        nam: Series có chỉ mục DatetimeIndex.
        nam_cuoi: Năm đích cần so sánh.
        cac_moc: Danh sách các năm làm kỳ gốc.
    Trả về:
        Từ điển {năm_mốc: tỷ_số_float}.
    """
    val_cuoi = float(nam[nam.index.year == nam_cuoi].iloc[0])
    ket_qua = {}
    for moc in cac_moc:
        val_moc = float(nam[nam.index.year == moc].iloc[0])
        ket_qua[moc] = val_cuoi / val_moc
    return ket_qua


# Dữ liệu thử nghiệm minh họa
_SO_THEO_NAM = {
    2014: 40,
    2015: 70,
    2016: 120,
    2017: 210,
    2018: 330,
    2019: 420,
    2020: 90,
    2021: 150,
    2022: 380,
    2023: 520,
    2024: 610,
    2025: 700,
    2026: 260,
}
demo_rv = pd.DataFrame(
    {
        "date": [
            pd.Timestamp(f"{nam}-01-01")
            + pd.Timedelta(days=(k * 97) % (181 if nam == 2026 else 365))
            for nam, so in _SO_THEO_NAM.items()
            for k in range(so)
        ]
    }
)
nam_demo = demo_rv.set_index("date").resample("YE").size()

ti_le_c1 = compare_baselines_loop(nam_demo, 2025, [2020, 2019, 2016])
print("Kết quả tính toán tỷ số tăng trưởng Cách 1:")
for moc, ti_so in ti_le_c1.items():
    print(f" - Năm 2025 so với năm {moc}: {ti_so:.2f} lần (tương đương {ti_so:.4f})")
Giải thích chi tiết Cách 1
nam.index.year == nam_cuoi tạo mặt nạ chọn năm cuối. .iloc[0] lấy một giá trị trong kết quả lọc và float chuyển nó thành số thực Python. Với mỗi năm mốc, hàm lọc tương tự rồi chia giá trị cuối cho giá trị mốc.
Vòng lặp duyệt cac_moc theo thứ tự đầu vào, nên từ điển giữ thứ tự đó. Các năm trong bài đã có đủ và số mốc dương, tránh lỗi lấy phần tử rỗng hoặc chia cho không. Không làm tròn trong hàm để phép tính tiếp theo dùng đủ độ chính xác số thực đang có, rồi chỉ làm tròn khi trình bày.
Kết quả thực thi Cách 1
| Năm mốc | Số đánh giá năm mốc | Số năm 2025 | Tỷ số, chưa làm tròn trong hàm |
|---|---|---|---|
| 2020 | 90 | 700 | 7.777777777777778 |
| 2019 | 420 | 700 | 1.6666666666666667 |
| 2016 | 120 | 700 | 5.833333333333333 |
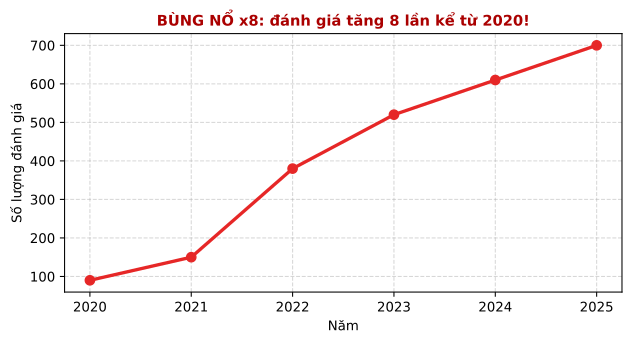
Cách 2: Tái lập chỉ mục số nguyên và phép chia từ điển nén (Dict Comprehension)
python
import pandas as pd


def compare_baselines_dict(nam: pd.Series, nam_cuoi: int, cac_moc: list) -> dict:
    """Tính tỷ số tăng trưởng thông qua Series chỉ mục số nguyên năm.

    Tham số:
        nam: Series có chỉ mục DatetimeIndex.
        nam_cuoi: Năm đích cần so sánh.
        cac_moc: Danh sách các năm làm kỳ gốc.
    Trả về:
        Từ điển kết quả.
    """
    nam_int = pd.Series(nam.values, index=nam.index.year)
    val_cuoi = float(nam_int.loc[nam_cuoi])
    return {moc: val_cuoi / float(nam_int.loc[moc]) for moc in cac_moc}


_SO_THEO_NAM = {
    2014: 40,
    2015: 70,
    2016: 120,
    2017: 210,
    2018: 330,
    2019: 420,
    2020: 90,
    2021: 150,
    2022: 380,
    2023: 520,
    2024: 610,
    2025: 700,
    2026: 260,
}

demo_rv = pd.DataFrame(
    {
        "date": [
            pd.Timestamp(f"{nam}-01-01")
            + pd.Timedelta(days=(k * 97) % (181 if nam == 2026 else 365))
            for nam, so in _SO_THEO_NAM.items()
            for k in range(so)
        ]
    }
)

nam_demo = demo_rv.set_index("date").resample("YE").size()

ti_le_c2 = compare_baselines_dict(nam_demo, 2025, [2020, 2019, 2016])
print(ti_le_c2)
Giải thích chi tiết Cách 2
Tạo Series có là năm giúp tránh lặp lại mặt nạ so sánh trên DatetimeIndex cho mỗi mốc. Dict comprehension duyệt cac_moc và tạo các cặp năm, tỷ số trong cùng thứ tự.
Cách này giả định mỗi năm chỉ có một giá trị tổng. Nếu nhiều dòng cùng năm, tra loc có thể trả Series thay vì một số. số nguyên không tự bảo đảm thời gian tra cứu hằng số trong mọi trường hợp của pandas. Khi dùng lại, cần kiểm tra tính duy nhất của năm và cùng miền dữ liệu như Cách 1.
Kết quả thực thi Cách 2
| Năm mốc | Số đánh giá năm mốc | Số năm 2025 | Tỷ số, chưa làm tròn trong hàm |
|---|---|---|---|
| 2020 | 90 | 700 | 7.777777777777778 |
| 2019 | 420 | 700 | 1.6666666666666667 |
| 2016 | 120 | 700 | 5.833333333333333 |
So sánh hai cách
Cách 1 mở rõ từng bước lọc năm và chia số. Cách 2 chuẩn bị theo năm một lần để tra các mốc. Không gọi tỷ lệ giữa hai tỷ số với mốc khác nhau là “hệ số dối trá” của đồ họa: Muốn đánh giá mức phóng đại hình học phải định nghĩa hiệu ứng thị giác và hiệu ứng số liệu đang so sánh.
Bài 6: Thiết lập biểu đồ xu hướng trung thực dài hạn và hồ sơ phản biện biểu đồ thiên lệch
Mục tiêu: Xây dựng hàm kết xuất biểu đồ xu hướng dài hạn trung thực, khắc phục triệt để các thủ thuật cắt gọt chuỗi thời gian, đánh dấu trực quan giai đoạn khủng hoảng ngoại sinh (đại dịch COVID-19), đồng thời lập hồ sơ phản biện lỗi (Chart Critique Dossier) bóc trần sự sai lệch của biểu đồ thiên kiến.
Dữ liệu đầu vào:
- Series chuỗi thời gian
nam: làDatetimeIndexbiểu thị các năm trọn vẹn (ví dụ 10 năm từ 2016 đến 2025). - Tham số
path: Đường dẫn tệp hình ảnh đầu ra cần lưu trữ. - Tham số
covid: Tuple chứa khoảng năm diễn ra đại dịch (mặc định(2020, 2021)).
Thao tác yêu cầu:
- Xây dựng hàm
plot_fixed_trend(nam: pd.Series, path: str, covid: tuple = (2020, 2021)) -> plt.Axes. - Tạo khung vẽ mới với tỷ lệ chuẩn mực
figsize=(8.5, 3.8). - Vẽ một đường duy nhất biểu diễn toàn bộ các điểm dữ liệu của
namvới trục hoành là số nguyên năm (nam.index.year). - Đánh dấu giai đoạn đại dịch bằng vùng bóng mờ
ax.axvspan(covid[0] - 0.5, covid[1] + 0.5, color="#fee0d2", alpha=0.6)hoặc hộp chú thích chữ nổi bật. - Đặt tiêu đề khoa học khách quan (độ dài
ký tự, không dùng từ ngữ giật gân, phóng đại), đặt nhãn trục tung rõ ràng. - Lưu biểu đồ ra tệp hình ảnh theo đường dẫn
pathvới chất lượng cao (dpi=150, bbox_inches="tight"), và trả về đối tượngAxes. - Lập hồ sơ lỗi hoàn chỉnh cho biểu đồ gốc gồm 3 luận điểm: Lỗi chọn kỳ gốc, Lỗi từ ngữ giật gân so với bản chất số liệu, và Sự khác biệt căn bản của bản sửa trung thực.
Trường hợp biên cần chú ý: Hàm phải vẽ đầy đủ các năm trong Series đầu vào (không được tự ý cắt xén năm), vùng tô bóng axvspan phải bao trọn các năm đại dịch với khoảng mở rộng
Lời giải
Bổ sung bối cảnh thay vì gán nguyên nhân
Hồ sơ phản biện cần chỉ ra ba điểm. Hình bắt đầu năm 2020 bỏ các năm trước đó nên người đọc không thấy số đếm năm 2019 là 420. Tiêu đề “bùng nổ” khiến tỷ số số đánh giá dễ bị đọc thành kết luận về toàn thị trường. Bản sửa hiển thị dải 2016–2025, giữ nhãn đơn vị và chỉ rõ kỳ gốc khi nêu tỷ số.
Có thể tô giai đoạn 2020–2021 như một mốc bối cảnh. Tuy nhiên dải màu không chứng minh đại dịch gây ra biến đổi trong fixture được dựng bằng code. Với dữ liệu thật, quan sát một mức giảm cùng thời điểm sự kiện cũng chưa đủ xác định quan hệ nhân quả.
Cách 1: Sử dụng Matplotlib axvspan và chú giải trực quan
python
from pathlib import Path
import matplotlib.pyplot as plt
import pandas as pd


def plot_fixed_trend(
    nam: pd.Series, path: str, covid: tuple = (2020, 2021)
) -> plt.Axes:
    """Vẽ biểu đồ xu hướng dài hạn trung thực có đánh dấu vùng biến cố ngoại sinh.

    Tham số:
        nam: Series chuỗi thời gian số đếm theo năm.
        path: Đường dẫn lưu tệp hình ảnh.
        covid: Tuple (năm_bắt_đầu, năm_kết_thúc) của giai đoạn biến cố.
    Trả về:
        Đối tượng Axes đã vẽ.
    """
    fig, ax = plt.subplots(figsize=(8.5, 3.8))
    years = nam.index.year
    ax.plot(
        years,
        nam.values,
        marker="o",
        color="#1f77b4",
        lw=2,
        markersize=6,
        label="Số đánh giá thực tế",
    )
    ax.axvspan(
        covid[0] - 0.5,
        covid[1] + 0.5,
        color="#fee0d2",
        alpha=0.6,
        label="Giai đoạn đại dịch COVID-19",
    )
    ax.set_title(
        "Xu hướng đánh giá dài hạn giai đoạn 2016–2025: Hồi phục sau đại dịch",
        fontsize=11,
        fontweight="bold",
    )
    ax.set_xlabel("Năm")
    ax.set_ylabel("Số lượt đánh giá hàng năm")
    ax.grid(True, linestyle="--", alpha=0.5)
    ax.legend(loc="upper left")

    Path(path).parent.mkdir(parents=True, exist_ok=True)
    fig.savefig(path, format="svg", bbox_inches="tight")
    return ax


# Dữ liệu thử nghiệm minh họa
_SO_THEO_NAM = {
    2014: 40,
    2015: 70,
    2016: 120,
    2017: 210,
    2018: 330,
    2019: 420,
    2020: 90,
    2021: 150,
    2022: 380,
    2023: 520,
    2024: 610,
    2025: 700,
    2026: 260,
}
demo_rv = pd.DataFrame(
    {
        "date": [
            pd.Timestamp(f"{nam}-01-01")
            + pd.Timedelta(days=(k * 97) % (181 if nam == 2026 else 365))
            for nam, so in _SO_THEO_NAM.items()
            for k in range(so)
        ]
    }
)
nam_sua = demo_rv.set_index("date").resample("YE").size().loc["2016":"2025"]
duong_dan_sua = "docs/xu-ly-du-lieu/bai-giang/img/labs/lab-13/hinh-13-05-ban-sua-trung-thuc-xu-huong.svg"

ax_kq_c1 = plot_fixed_trend(nam_sua, duong_dan_sua)
print("Kết xuất bản sửa Cách 1 thành công:")
print(" - Tiêu đề:", ax_kq_c1.get_title())
print(" - Số điểm trên đường:", len(ax_kq_c1.lines[0].get_xdata()))
print(" - Số vùng tô bóng:", len(ax_kq_c1.patches))
plt.close(ax_kq_c1.figure)
Giải thích chi tiết Cách 1
ax.plot vẽ các số đếm theo năm, còn marker giúp nhận ra từng quan sát năm. axvspan tô một khoảng trên trục x và phủ chiều cao vùng vẽ. Cộng hoặc trừ 0.5 ở hai đầu làm vùng tô bao quanh các mốc năm tương ứng.
Tiêu đề và nhãn trục phải nói đang đếm đánh giá, không phải đặt phòng. savefig lưu hình tại đường dẫn yêu cầu. Dung lượng tệp không phải tiêu chí xác nhận hình đã đúng: Cần kiểm tra có đủ điểm, chữ đọc được và phần tô không che các giá trị cần xem.
Kết quả thực thi Cách 1
| Kiểm tra | Kết quả trên fixture |
|---|---|
| Khoảng năm | 2016–2025, 10 giá trị |
| Năm 2019 | 420 |
| Năm 2020 | 90 |
| Năm 2025 | 700 |
| Chỉ số | Số đánh giá hàng năm |
| Vùng tô | 2020–2021 theo tham số covid |
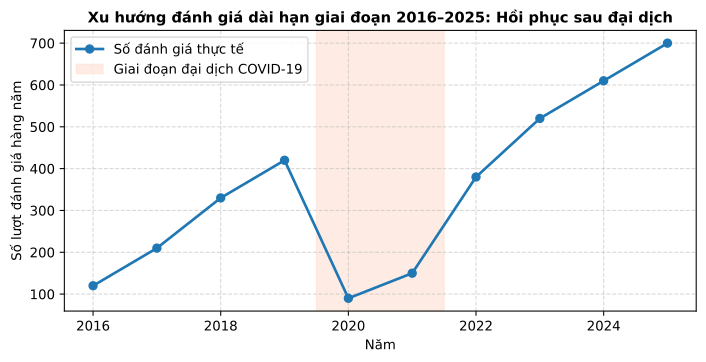
Cách 2: Bổ sung chú thích văn bản trực tiếp tại các mốc trọng yếu
python
from pathlib import Path
import matplotlib.pyplot as plt
import pandas as pd


def plot_fixed_trend_nang_cao(
    nam: pd.Series, path: str, covid: tuple = (2020, 2021)
) -> plt.Axes:
    """Vẽ biểu đồ xu hướng dài hạn với các chú thích số liệu trực quan tại các mốc ngoặt."""
    fig, ax = plt.subplots(figsize=(8.5, 4))
    years = nam.index.year
    ax.plot(
        years,
        nam.values,
        color="#08519c",
        lw=2.2,
        marker="s",
        markersize=5,
        label="Số lượng đánh giá",
    )
    ax.axvspan(
        covid[0] - 0.5,
        covid[1] + 0.5,
        color="#f0f0f0",
        edgecolor="#bdbdbd",
        linestyle="--",
        label="Mốc so sánh 2020–2021",
    )

    # Ghi chú văn bản tại các mốc trọng yếu
    ax.text(
        2020.5,
        nam.loc["2020-12-31"] + 30,
        "Mốc thấp của mẫu\n(90 lượt)",
        ha="center",
        fontsize=8,
        color="#a50f15",
        fontweight="bold",
    )
    ax.text(
        2019,
        nam.loc["2019-12-31"] + 25,
        "Đỉnh trước dịch\n(420 lượt)",
        ha="center",
        fontsize=8,
        color="#045a8d",
    )
    ax.text(
        2025,
        nam.loc["2025-12-31"] - 45,
        "Hiện tại\n(700 lượt)",
        ha="center",
        fontsize=8,
        color="#045a8d",
    )

    ax.set_title(
        "Số đánh giá theo năm trong dữ liệu minh họa", fontsize=11, fontweight="bold"
    )
    ax.set_xlabel("Năm quan sát")
    ax.set_ylabel("Số lượt đánh giá trong từng năm")
    ax.set_xticks(years)
    ax.grid(True, linestyle=":", alpha=0.6)
    ax.legend(loc="upper left", frameon=True)

    Path(path).parent.mkdir(parents=True, exist_ok=True)
    fig.savefig(path, format="svg", bbox_inches="tight")
    return ax


_SO_THEO_NAM = {
    2014: 40,
    2015: 70,
    2016: 120,
    2017: 210,
    2018: 330,
    2019: 420,
    2020: 90,
    2021: 150,
    2022: 380,
    2023: 520,
    2024: 610,
    2025: 700,
    2026: 260,
}

demo_rv = pd.DataFrame(
    {
        "date": [
            pd.Timestamp(f"{nam}-01-01")
            + pd.Timedelta(days=(k * 97) % (181 if nam == 2026 else 365))
            for nam, so in _SO_THEO_NAM.items()
            for k in range(so)
        ]
    }
)

nam_sua = demo_rv.set_index("date").resample("YE").size().loc["2016":"2025"]

duong_dan_sua = "docs/xu-ly-du-lieu/bai-giang/img/labs/lab-13/hinh-13-05-ban-sua-trung-thuc-xu-huong.svg"

ax_kq_c2 = plot_fixed_trend_nang_cao(nam_sua, duong_dan_sua)
assert len(ax_kq_c2.texts) >= 3
print("Cách 2 kiểm thử thành công: Đã tạo đủ các chú thích chữ tại các mốc ngoặt.")
plt.close(ax_kq_c2.figure)
Giải thích chi tiết Cách 2
ax.text đặt nội dung tại một tọa độ dữ liệu để đọc trực tiếp mốc đang được thảo luận. set_xticks(years) dùng các năm nguyên làm vạch chia, tránh một vạch nửa năm không có ý nghĩa với các tổng năm.
Chữ gắn vào tọa độ cần được kiểm tra lại khi dữ liệu thay đổi vì có thể trùng đường hoặc nhãn khác. Viền và màu của vùng tô chỉ giúp nhận diện giai đoạn. Chúng không cung cấp bằng chứng về một nguyên nhân kinh tế hoặc trạng thái “bình thường” của thị trường.
Kết quả thực thi Cách 2
| Nội dung phản biện | Cách đọc bản sửa |
|---|---|
| Kỳ gốc | Đọc cả các năm trước 2020 và đối chiếu nhiều mốc |
| Lời diễn giải | Nêu tỷ số của số đánh giá, tránh gọi đó là mức tăng của toàn thị trường |
| Giai đoạn tô màu | Mốc bối cảnh cần nêu rõ, không phải kiểm định nhân quả |
| Điểm đánh dấu | 2019 có 420, 2020 có 90, 2025 có 700 |
So sánh hai cách
Cách 1 đánh dấu giai đoạn bằng vùng tô. Cách 2 bổ sung nhãn tại những mốc cần đọc chính xác. Cả hai vẫn cần kiểm tra bố cục và câu kết luận sau khi đổi dữ liệu, và không thể tự bảo đảm một diễn giải đúng chỉ bằng cách kéo dài trục thời gian.
Bài 7: Bài mở rộng nâng cao: Phân tích không gian đa biến kết hợp quy mô nguồn cung và tỷ lệ nhóm chủ nhà theo quận
Mục tiêu: Xây dựng thuật toán phân tích không gian đa chiều, tích hợp song song quy mô nguồn cung chỗ ở, mức giá trung vị và tỷ lệ niêm yết thuộc nhóm chủ nhà có từ năm chỗ ở theo từng đơn vị hành chính, trực quan hóa trên bản đồ phân vùng và phân tích cơ cấu thị trường mà không suy diễn thiên kiến nhân quả.
Dữ liệu đầu vào:
- Bảng chỗ ở
ds: Chứa thông tin về quậnneighbourhood, giáprice, mã định danhidvà số lượng chỗ ở của chủ nhàcalculated_host_listings_count. - Bảng ranh giới địa lý tổng hợp
geo: Đối tượngGeoDataFramechứa ranh giới 6 quận mô phỏng.
Thao tác yêu cầu:
- Xây dựng hàm
analyze_spatial_concentration(ds: pd.DataFrame, geo: gpd.GeoDataFrame, path: str) -> gpd.GeoDataFrame. - Phân loại chủ nhà thành hai nhóm:
chuyen_nghiep(từ 5 chỗ ở trở lên) vàca_nhan(dưới 5 chỗ ở). - Tổng hợp dữ liệu theo từng quận:
- Tổng số chỗ ở (
tong_cho_o): Đếm số lượng cơ sở lưu trú. - Mức giá trung vị (
gia_trung_vi): Tính trung vị giá niêm yết (bỏ giá trị khuyết). - Số lượng chỗ ở chuyên nghiệp (
so_chuyen_nghiep): Đếm số chỗ ở do chủ nhà chuyên nghiệp quản lý. - Tỷ lệ chuyên nghiệp hóa (
ty_le_chuyen_nghiep): Lấy số dòng thuộc nhóm chia tổng dòng rồi nhân 100, làm tròn một chữ số thập phân.
- Tổng số chỗ ở (
- Ghép toàn bộ các chỉ số trên vào bảng ranh giới
geo. Điền 0 cho các quận trắng dữ liệu (Pirque cótong_cho_o = 0,so_chuyen_nghiep = 0,ty_le_chuyen_nghiep = 0.0%). - Trực quan hóa bản đồ phân bố tỷ lệ chuyên nghiệp hóa với dải màu tím
Purples, ghi nhãn tên quận, tỷ lệ phần trăm và quy mô mẫulên tâm hình học của từng quận. - Lưu tệp bản đồ ra đường dẫn
pathđịnh dạng vector SVG. - Cảnh báo phương pháp luận: Phân tích vì sao không được phép suy diễn quan hệ nhân quả (causality), mức độ an toàn (safety) hay mức độ ưa chuộng của khách hàng từ quy mô nguồn cung hay tỷ lệ chuyên nghiệp hóa.
Trường hợp biên cần chú ý: Phép chia tính tỷ lệ chuyên nghiệp hóa tại các quận có 0 chỗ ở sẽ phát sinh lỗi chia cho 0 (0 / 0 = NaN). Code dùng 0.0% làm quy ước hiển thị khi n bằng 0. Phải ghi rõ đây không phải một tỷ lệ quan sát được.
Lời giải
Đếm dòng chỗ ở, không đếm chủ nhà độc lập
Ngưỡng từ năm chỗ ở là quy ước phân nhóm cho bài này. Mỗi dòng được xếp theo calculated_host_listings_count, rồi ta đếm số dòng thuộc nhóm đó trong từng quận. Tỷ lệ thu được là phần niêm yết gắn với nhóm quy mô từ năm chỗ ở, không phải phần trăm số chủ nhà độc lập.
Với quận không có dòng, tỷ lệ có mẫu số bằng không nên chưa xác định. Code dùng 0.0 làm quy ước hiển thị và luôn phải đặt cạnh n bằng 0 để người đọc phân biệt với một quận có quan sát nhưng không có dòng đạt ngưỡng. Giá, số lượng và tỷ lệ nhóm chưa cho phép kết luận về an toàn, sự ưa chuộng, mức độ chuyên môn hay nguyên nhân định giá.
Cách 1: Tổng hợp đa hàm với pandas groupby kết hợp GeoPandas Plot
python
from pathlib import Path
import matplotlib.pyplot as plt
import pandas as pd
from shapely.geometry import box
import geopandas as gpd


def analyze_spatial_concentration(
    ds: pd.DataFrame, geo: gpd.GeoDataFrame, path: str
) -> gpd.GeoDataFrame:
    """Phân tích cấu trúc nguồn cung và mức độ chuyên nghiệp hóa theo quận."""
    rows = []
    for ten_quan, nhom in ds.groupby("neighbourhood"):
        n = len(nhom)
        so_tu_5 = int((nhom["calculated_host_listings_count"] >= 5).sum())
        rows.append(
            {
                "neighbourhood": ten_quan,
                "tong_cho_o": n,
                "gia_trung_vi": nhom["price"].median(),
                "so_chuyen_nghiep": so_tu_5,
                "ty_le_chuyen_nghiep": round(so_tu_5 / n * 100, 1),
            }
        )
    grp = pd.DataFrame(rows)

    ban_do = geo.merge(grp, on="neighbourhood", how="left")
    ban_do["tong_cho_o"] = ban_do["tong_cho_o"].fillna(0).astype(int)
    ban_do["so_chuyen_nghiep"] = ban_do["so_chuyen_nghiep"].fillna(0).astype(int)
    ban_do["ty_le_chuyen_nghiep"] = ban_do["ty_le_chuyen_nghiep"].fillna(0.0)

    fig, ax = plt.subplots(figsize=(8, 6))
    ban_do.plot(
        column="ty_le_chuyen_nghiep",
        cmap="Purples",
        legend=True,
        edgecolor="#333",
        linewidth=0.8,
        ax=ax,
        legend_kwds={
            "label": "Tỷ lệ chỗ ở có chủ nhà từ 5 niêm yết (%)",
            "shrink": 0.75,
        },
    )
    ax.set_title(
        "Cơ cấu chỗ ở theo quy mô niêm yết của chủ nhà", fontsize=11, fontweight="bold"
    )
    ax.set_axis_off()

    for _, row in ban_do.iterrows():
        pt = row.geometry.centroid
        ax.text(
            pt.x,
            pt.y,
            f"{row['neighbourhood']}\n{row['ty_le_chuyen_nghiep']:.0f}%\n(n={row['tong_cho_o']})",
            ha="center",
            va="center",
            fontsize=8,
            color="#222",
        )

    fig.text(
        0.02,
        0.02,
        "Phân tích mở rộng: Nguồn cung và cơ cấu chủ nhà, không suy diễn chất lượng hay an toàn từ quy mô.",
        fontsize=8,
        color="#555",
    )

    Path(path).parent.mkdir(parents=True, exist_ok=True)
    fig.savefig(path, format="svg", bbox_inches="tight")
    plt.close(fig)
    return ban_do


# Dữ liệu thử nghiệm minh họa
_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)
demo_ds = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
        "price": [
            (
                None
                if k % 11 == 5
                else float(18000 + (k * 7919) % 90000 + (15000 if k % 3 == 0 else 0))
            )
            for k in range(48)
        ],
        "calculated_host_listings_count": [1 + (k * 5) % 9 for k in range(48)],
    }
)
o_luoi = [
    box(0, 1, 1, 2),
    box(1, 1, 2, 2),
    box(2, 1, 3, 2),
    box(0, 0, 1, 1),
    box(1, 0, 2, 1),
    box(2, 0, 3, 1),
]
geo_synth_demo = gpd.GeoDataFrame(
    {
        "neighbourhood": [
            "Santiago",
            "Providencia",
            "Las Condes",
            "Ñuñoa",
            "Lo Barnechea",
            "Pirque",
        ],
        "neighbourhood_group": [None] * 6,
    },
    geometry=o_luoi,
    crs="EPSG:3857",
)

duong_dan_ext = "docs/xu-ly-du-lieu/bai-giang/img/labs/lab-13/hinh-13-06-mo-rong-khong-gian-da-chieu.svg"
ban_do_ext_c1 = analyze_spatial_concentration(demo_ds, geo_synth_demo, duong_dan_ext)
print(
    "Kết xuất bài mở rộng Cách 1 thành công. Cột dữ liệu:", list(ban_do_ext_c1.columns)
)
Giải thích chi tiết Cách 1
Vòng lặp lấy từng nhóm quận rồi tính ba số: Số dòng, trung vị giá và số dòng có chủ nhà từ 5 niêm yết. len(nhom) đếm cả dòng thiếu id. .median() bỏ giá thiếu và phép cộng các cờ boolean đếm số dòng thỏa điều kiện. Mỗi kết quả được thêm vào danh sách rows, rồi chuyển thành .
Sau ghép vào ranh giới, số đếm của Pirque được điền không, còn giá trung vị giữ . Nhãn bản đồ ghi đồng thời tỷ lệ và n để không che mất nhóm nhỏ. Các phần trăm ở bảng dưới được làm tròn một chữ số, còn nhãn trong code làm tròn về số nguyên nên có thể khác mức hiển thị trong bảng.
Kết quả thực thi Cách 1
| Quận | n | Số dòng có chủ nhà từ 5 chỗ ở | Tỷ lệ (%) | Trung vị (CLP) |
|---|---|---|---|---|
| Santiago | 18 | 10 | 55.6 | 59271.0 |
| Providencia | 12 | 6 | 50.0 | 67651.0 |
| Las Condes | 8 | 5 | 62.5 | 87029.5 |
| Ñuñoa | 6 | 3 | 50.0 | 72679.0 |
| Lo Barnechea | 4 | 2 | 50.0 | 63314.5 |
| Pirque | 0 | 0 | 0.0 theo quy ước |
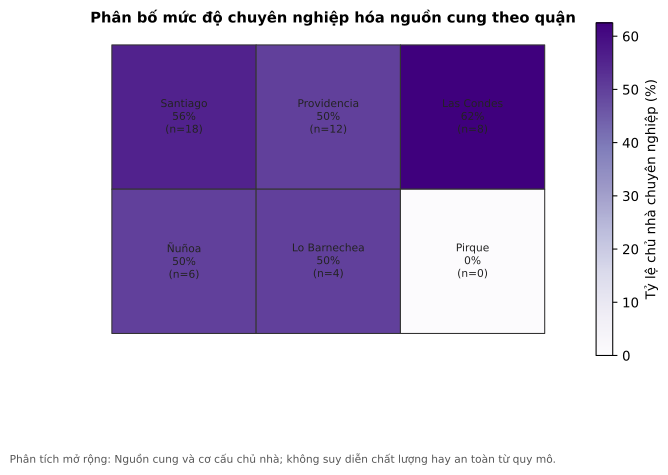
Cách 2: Vector hóa tính toán ma trận phân nhóm kinh doanh
python
from pathlib import Path
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import geopandas as gpd
from shapely.geometry import box


def analyze_spatial_concentration_fast(
    ds: pd.DataFrame, geo: gpd.GeoDataFrame, path: str
) -> gpd.GeoDataFrame:
    """Phân tích cấu trúc nguồn cung và mức độ chuyên nghiệp hóa theo quận."""
    ds_kieu = ds.assign(
        kieu_host=(ds["calculated_host_listings_count"] >= 5).map(
            {True: "chuyen_nghiep", False: "ca_nhan"}
        )
    )
    grp = (
        ds_kieu.groupby("neighbourhood")
        .agg(
            tong_cho_o=("id", "size"),
            gia_trung_vi=("price", "median"),
            so_chuyen_nghiep=("kieu_host", lambda s: (s == "chuyen_nghiep").sum()),
        )
        .reset_index()
    )
    grp["ty_le_chuyen_nghiep"] = (
        grp["so_chuyen_nghiep"] / grp["tong_cho_o"] * 100
    ).round(1)

    ban_do = geo.merge(grp, on="neighbourhood", how="left")
    ban_do["tong_cho_o"] = ban_do["tong_cho_o"].fillna(0).astype(int)
    ban_do["so_chuyen_nghiep"] = ban_do["so_chuyen_nghiep"].fillna(0).astype(int)
    ban_do["ty_le_chuyen_nghiep"] = ban_do["ty_le_chuyen_nghiep"].fillna(0.0)

    fig, ax = plt.subplots(figsize=(8, 6))
    ban_do.plot(
        column="ty_le_chuyen_nghiep",
        cmap="Purples",
        legend=True,
        edgecolor="#333",
        linewidth=0.8,
        ax=ax,
        legend_kwds={
            "label": "Tỷ lệ chỗ ở có chủ nhà từ 5 niêm yết (%)",
            "shrink": 0.75,
        },
    )
    ax.set_title(
        "Cơ cấu chỗ ở theo quy mô niêm yết của chủ nhà", fontsize=11, fontweight="bold"
    )
    ax.set_axis_off()

    for _, row in ban_do.iterrows():
        pt = row.geometry.centroid
        ax.text(
            pt.x,
            pt.y,
            f"{row['neighbourhood']}\n{row['ty_le_chuyen_nghiep']:.0f}%\n(n={row['tong_cho_o']})",
            ha="center",
            va="center",
            fontsize=8,
            color="#222",
        )

    fig.text(
        0.02,
        0.02,
        "Phân tích mở rộng: Nguồn cung và cơ cấu chủ nhà, không suy diễn chất lượng hay an toàn từ quy mô.",
        fontsize=8,
        color="#555",
    )

    Path(path).parent.mkdir(parents=True, exist_ok=True)
    fig.savefig(path, format="svg", bbox_inches="tight")
    plt.close(fig)
    return ban_do


_QUAN = (
    ["Santiago"] * 18
    + ["Providencia"] * 12
    + ["Las Condes"] * 8
    + ["Ñuñoa"] * 6
    + ["Lo Barnechea"] * 4
)

demo_ds = pd.DataFrame(
    {
        "id": range(201, 249),
        "neighbourhood": _QUAN,
        "price": [
            (
                None
                if k % 11 == 5
                else float(18000 + (k * 7919) % 90000 + (15000 if k % 3 == 0 else 0))
            )
            for k in range(48)
        ],
        "calculated_host_listings_count": [1 + (k * 5) % 9 for k in range(48)],
    }
)

o_luoi = [
    box(0, 1, 1, 2),
    box(1, 1, 2, 2),
    box(2, 1, 3, 2),
    box(0, 0, 1, 1),
    box(1, 0, 2, 1),
    box(2, 0, 3, 1),
]

geo_synth_demo = gpd.GeoDataFrame(
    {
        "neighbourhood": [
            "Santiago",
            "Providencia",
            "Las Condes",
            "Ñuñoa",
            "Lo Barnechea",
            "Pirque",
        ],
        "neighbourhood_group": [None] * 6,
    },
    geometry=o_luoi,
    crs="EPSG:3857",
)

duong_dan_ext = "docs/xu-ly-du-lieu/bai-giang/img/labs/lab-13/hinh-13-06-mo-rong-khong-gian-da-chieu.svg"

ban_do_ext_c2 = analyze_spatial_concentration_fast(
    demo_ds, geo_synth_demo, duong_dan_ext
)
print(ban_do_ext_c2.drop(columns="geometry").to_string(index=False))


def phan_nhom_chien_luoc_khong_gian(ban_do_ext: gpd.GeoDataFrame) -> pd.DataFrame:
    """Phân loại các quận vào ma trận chiến lược nguồn cung và chuyên nghiệp hóa."""
    df_quan = ban_do_ext.dropna(subset=["gia_trung_vi"]).copy()
    nguong_n = df_quan["tong_cho_o"].median()
    nguong_pro = df_quan["ty_le_chuyen_nghiep"].median()

    dieu_kien = [
        (df_quan["tong_cho_o"] >= nguong_n)
        & (df_quan["ty_le_chuyen_nghiep"] >= nguong_pro),
        (df_quan["tong_cho_o"] >= nguong_n)
        & (df_quan["ty_le_chuyen_nghiep"] < nguong_pro),
        (df_quan["tong_cho_o"] < nguong_n)
        & (df_quan["ty_le_chuyen_nghiep"] >= nguong_pro),
        (df_quan["tong_cho_o"] < nguong_n)
        & (df_quan["ty_le_chuyen_nghiep"] < nguong_pro),
    ]
    nhan_nhom = [
        "Quy mô lớn - Tỷ lệ từ ngưỡng trở lên",
        "Quy mô lớn - Tỷ lệ dưới ngưỡng",
        "Quy mô nhỏ - Tỷ lệ từ ngưỡng trở lên",
        "Quy mô nhỏ - Tỷ lệ dưới ngưỡng",
    ]
    df_quan["nhom_chien_luoc"] = np.select(
        dieu_kien, nhan_nhom, default="Chưa xác định"
    )
    return df_quan[
        [
            "neighbourhood",
            "tong_cho_o",
            "ty_le_chuyen_nghiep",
            "gia_trung_vi",
            "nhom_chien_luoc",
        ]
    ]


df_chien_luoc = phan_nhom_chien_luoc_khong_gian(ban_do_ext_c2)
print("Bảng phân nhóm chiến lược không gian:")
print(df_chien_luoc)
Giải thích chi tiết Cách 2
Hàm analyze_spatial_concentration_fast dùng named aggregation để tính cả ba chỉ số trong một phép nhóm. Phép size đếm dòng, median bỏ giá thiếu, còn hàm đếm cờ xác định số dòng đạt ngưỡng quy mô. Sau đó, ghép vào các đa giác và vẽ cùng chỉ số như Cách 1. Sau khi có bảng quận, phần phân loại là một bước mở rộng: Lấy trung vị của số dòng và trung vị của tỷ lệ nhóm trong các quận có giá làm hai ngưỡng rồi xét bốn tổ hợp cao/thấp.
np.select gán nhãn cho từng dòng theo các mặt nạ điều kiện. Ngưỡng phụ thuộc chính các quận được đưa vào, nên đây là một cách phân nhóm mô tả, không phải tiêu chuẩn nghề nghiệp hay khuyến nghị đầu tư. Với fixture, ngưỡng số dòng là 8 và ngưỡng tỷ lệ là 50.0. Dấu >= khiến các giá trị bằng ngưỡng thuộc phía cao.
Kết quả thực thi Cách 2
| Quận | n | Tỷ lệ nhóm từ 5 chỗ ở (%) | Phân nhóm theo hai ngưỡng |
|---|---|---|---|
| Santiago | 18 | 55.6 | Quy mô lớn, tỷ lệ từ ngưỡng trở lên |
| Providencia | 12 | 50.0 | Quy mô lớn, tỷ lệ từ ngưỡng trở lên |
| Las Condes | 8 | 62.5 | Quy mô lớn, tỷ lệ từ ngưỡng trở lên |
| Ñuñoa | 6 | 50.0 | Quy mô nhỏ, tỷ lệ từ ngưỡng trở lên |
| Lo Barnechea | 4 | 50.0 | Quy mô nhỏ, tỷ lệ từ ngưỡng trở lên |
Pirque có giá nên bị loại khỏi bước phân nhóm mở rộng. Không có quận nào ở phía tỷ lệ dưới 50.0 trong fixture này.
So sánh hai cách
Bảng và bản đồ trả lời quy mô, giá và cơ cấu của từng quận. Bước phân nhóm thêm một nhãn tóm tắt theo hai ngưỡng của mẫu. Nhãn không đưa thêm bằng chứng về đặc điểm đô thị, kiểu khách hoặc hiệu quả kinh doanh. Dùng np.select không tự chứng minh cách này nhanh hơn nếu chưa đo.
Tài liệu tham khảo
Tài liệu tham khảo
Wes McKinney, Python for Data Analysis (tái bản lần 3): Chương 9: Plotting and Visualization.
Tài liệu chính thức Matplotlib: Quick start guide & Artist tutorial.
Tài liệu chính thức Seaborn: Statistical data visualization.
Edward R. Tufte, The Visual Display of Quantitative Information, Graphics Press, 2001.
William S. Cleveland & Robert McGill, Graphical Perception: Theory, Experimentation, and Application to the Development of Graphical Methods, Journal of the American Statistical Association, 1984.
Hệ thống bài tập được chuyển thể từ học liệu mở của: Khóa học Lập trình xử lý dữ liệu (UET) theo giấy phép Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International (CC BY-NC-SA 4.0).
IAI, Lập trình xử lý dữ liệu, học liệu và notebook. Các đề thực hành đã được biên tập cách diễn đạt và bổ sung lời giải, giữ CC BY-NC-SA 4.0. Giấy phép học liệu.
IAI. Notebook thực hành và học liệu thực hành 2627-1. Các yêu cầu kỹ thuật được đối chiếu, biên tập và bổ sung lời giải cùng dữ liệu minh họa. Phần thích nghi từ học liệu IAI áp dụng giấy phép CC BY-NC-SA 4.0.